
O SQL Server 2016 saiu do suporte estendido em 14 de julho de 2026. O 2017 sai em outubro de 2027, e a TOTVS já marca ele como EOL na lista de bancos homologados. Quem roda Protheus numa dessas duas versões vai ter que mexer no banco de qualquer jeito.
E é nessa hora que a pergunta aparece na reunião: já que vai mexer, por que não ir pro PostgreSQL e parar de pagar licença?
Eu recebo essa pergunta com frequência. A resposta honesta é que depende de coisas que quase ninguém levanta antes de perguntar. Vou colocar aqui o que a TOTVS homologa de verdade, com o texto deles e não o meu, quanto custa ficar, o que muda pro DBA e pro desenvolvedor, com teste feito num PostgreSQL de laboratório, e como a migração acontece na prática com a ferramenta oficial. Sem torcida por banco. Já vi Protheus voando nos dois e rastejando nos dois.
O que a TOTVS homologa hoje
Tudo que está nesta seção eu tirei da página de bancos homologados do DBAccess e da página de bancos homologados do Protheus, no TDN, consultadas em 15 de outubro de 2026.
Então não, você não perde as procedures do custo médio indo pro Postgres. Isso é um mito que ainda circula, e a TOTVS escreve o contrário em letra de forma na página do Protheus: “Stored Procedures são suportadas para o banco PostgreSQL a partir da versão Protheus 12”.
Tem uma caixa verde na página do DBAccess que vale ler duas vezes. Guarda ela pra seção do custo.
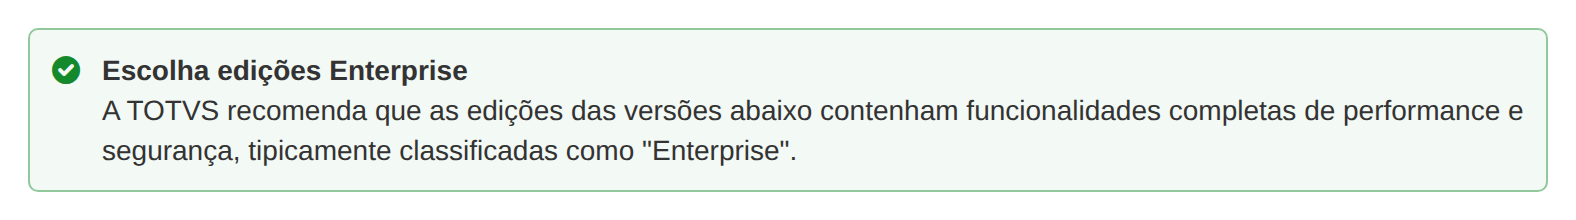
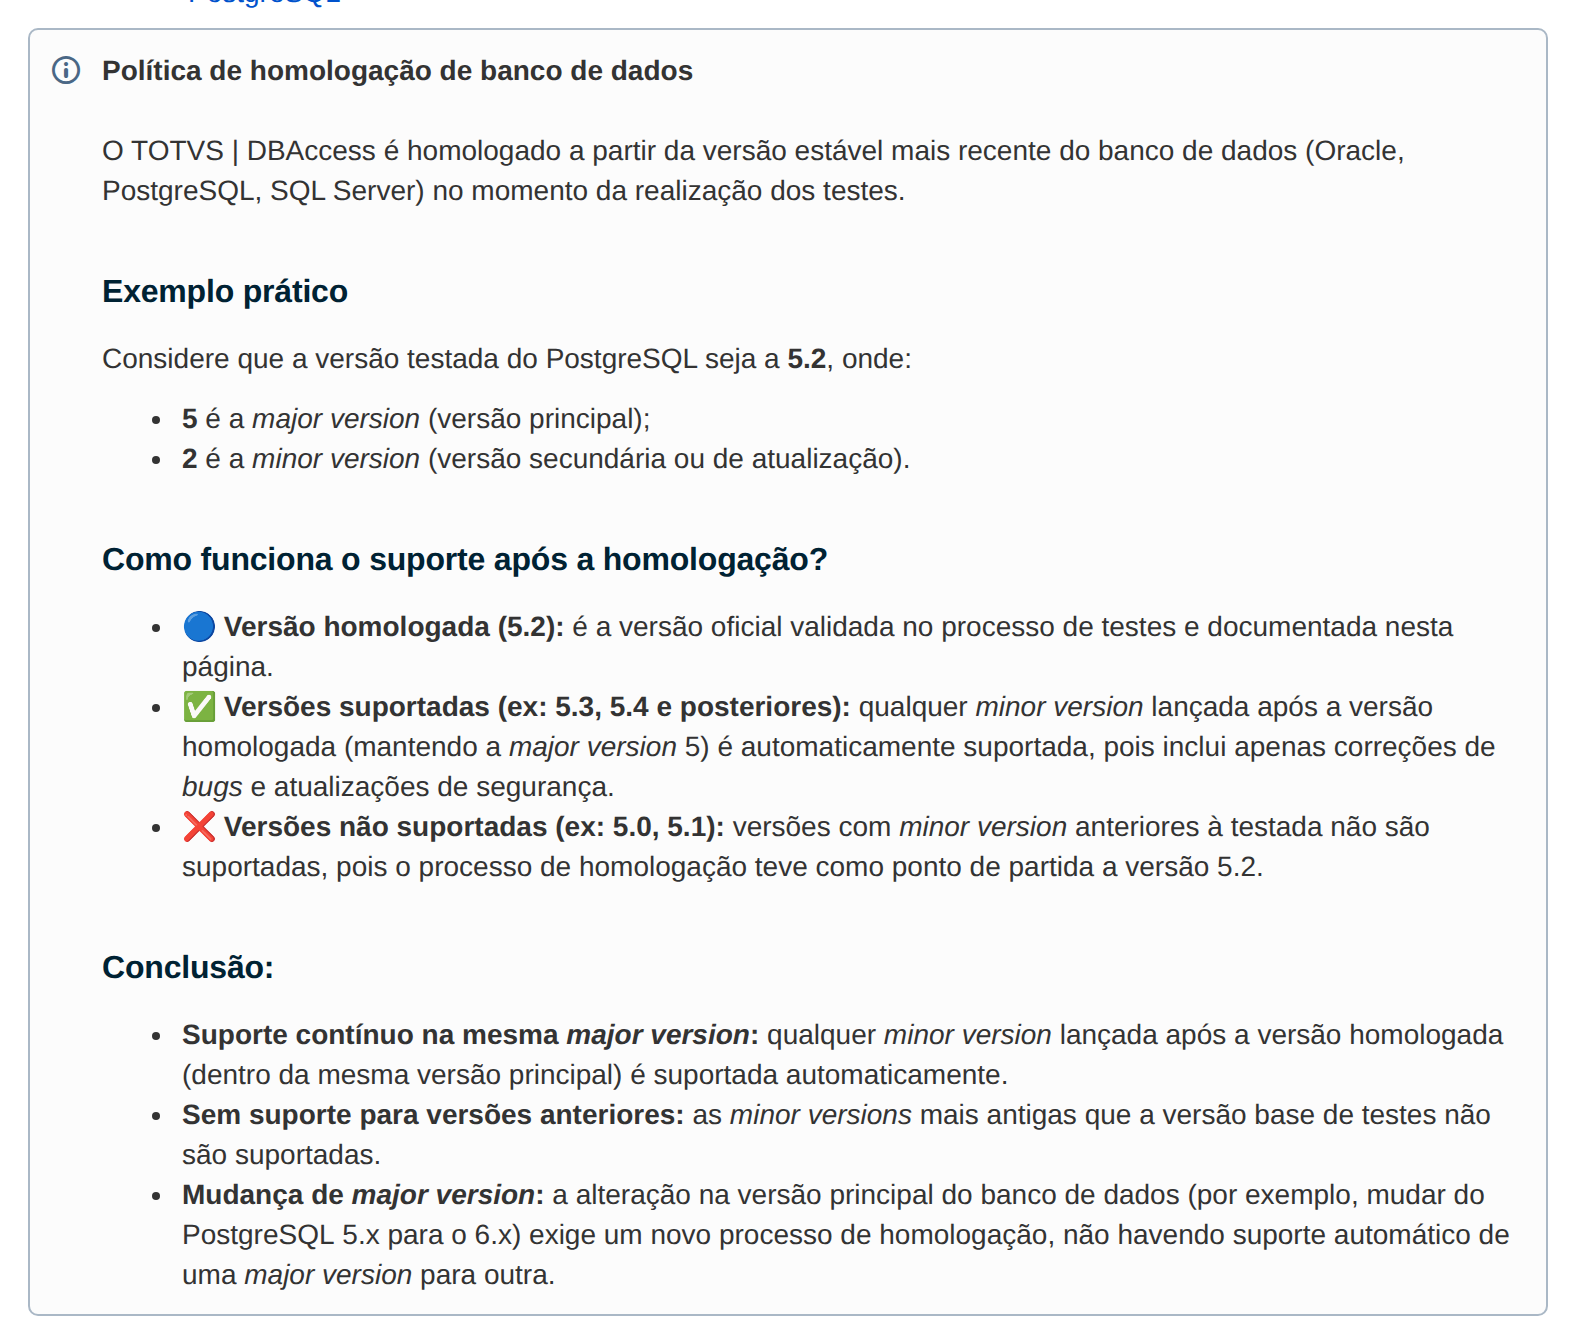
E tem a política de versão, que muita gente ignora. A homologação vale pra major version testada e pras minors seguintes. Major nova exige homologação nova. PostgreSQL 17 não está na lista, então não existe “subir pro 17 porque saiu”. Você vai de 16 pra 18, quando o seu DBAccess permitir.
Pro PostgreSQL a TOTVS exige três coisas na criação do banco e uma no DBAccess. O texto deles:
Encoding: WIN1252. Collation: C. Character type: *.CP1252 e/ou *.1252.
DBAccess.ini: Configure, no arquivo de configuração do DBAccess, a chave ODBC30=1. A utilização das funções de ODBC 1.0 da ODBC do Postgres é mantida apenas por compatibilidade, e seu uso pode gerar instabilidades e quedas do DBAccess.
Pacote postgresql12-contrib: este pacote é essencial para campos identificadores.
TOTVS, TDN: Banco de Dados Homologados (Linha Microsiga Protheus)
Fui testar num PostgreSQL 16 limpo, porque tem uma pegadinha logo na primeira linha: o banco não pode ser criado a partir do template padrão, que é UTF8. Sem o template0, o erro é este:
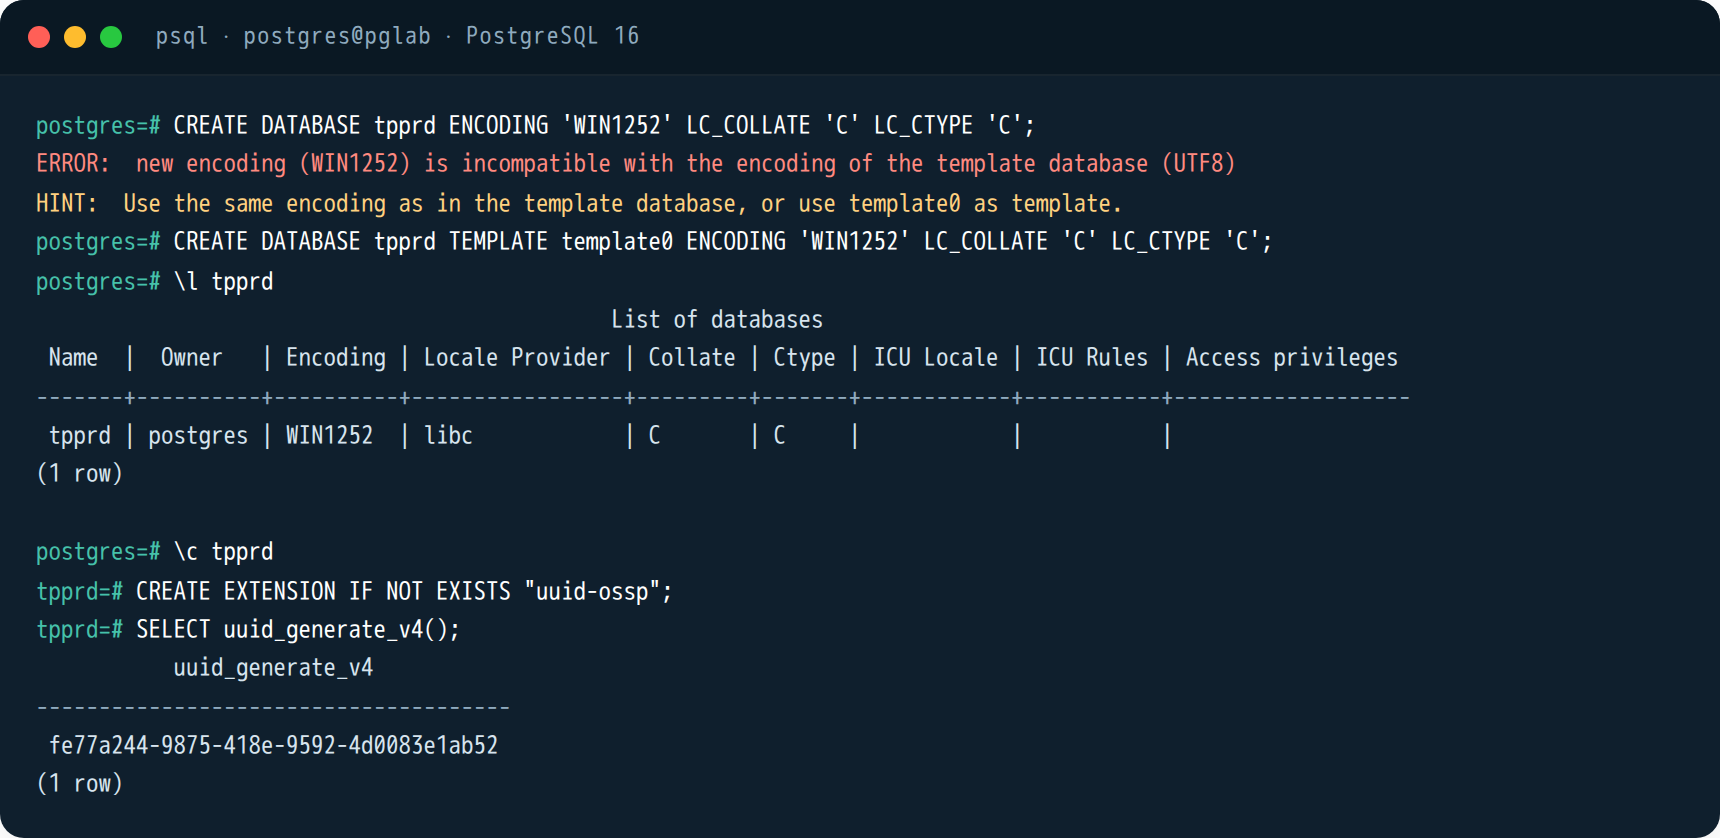
-- o banco do Protheus precisa nascer assim (não dá pra mudar depois)
CREATE DATABASE tpprd
  WITH TEMPLATE = template0
       ENCODING = 'WIN1252'
       LC_COLLATE = 'C'
       LC_CTYPE   = 'C';

CREATE EXTENSION IF NOT EXISTS "uuid-ossp";
; dbaccess.ini
[General]
ODBC30=1
[POSTGRES]
environments=tpprd
[POSTGRES/tpprd]
user=tpprd
password=...
TableSpace=tpprd_data
IndexSpace=tpprd_dataO ODBC30=1 vai na seção General, não na do banco. E se o DBAccess estiver em Windows, pula o driver ODBC versão 16 do Postgres. A página do DBAccess diz que tem bug conhecido e manda pra 17.00.0003 ou superior.
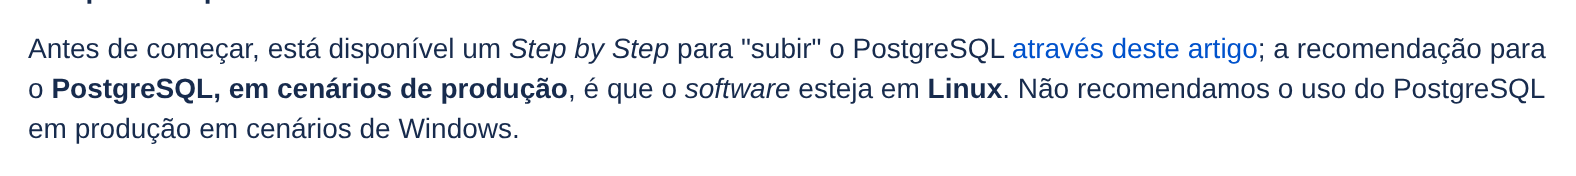
Mais uma, na página de dicas de migração. Se o seu time só sabe Windows, esse é o primeiro custo escondido da conversa:
Quanto custa ficar no SQL Server
Vamos fazer a conta com preço de lista da Microsoft pro SQL Server 2025, licenciamento por core, que é o que se usa com Protheus. Pacote de 2 cores Standard: US$ 3.945. Pacote de 2 cores Enterprise: US$ 15.123. Mínimo de 4 cores por servidor. Um servidor de banco de 8 cores, que é um tamanho comum de Protheus de porte médio:
Repara na segunda caixa. Se você segue a recomendação da TOTVS e vai de Enterprise, um servidor de 8 cores são sessenta mil dólares de lista. Se a homologação roda o mesmo motor, dobra. Em assinatura, são vinte e um mil por ano só de produção, pra sempre.
Muita gente roda Standard e vive bem. Mas aí não tem Always On completo, não tem TDE antes do 2019, tem teto de memória por instância. Cada um desses “não tem” vira uma decisão de arquitetura que você faz pra economizar licença, e isso também é custo, só que não aparece na nota fiscal.
O PostgreSQL custa zero de licença. Não custa zero. O custo muda de lugar: projeto de migração com três rodadas, gente que saiba operar Postgres em Linux, ferramenta de backup, arquitetura de alta disponibilidade, e, se você quiser alguém pra ligar de madrugada, contrato de suporte.
O que muda pro DBA
Aqui está o que eu mais quero que você leia, porque é onde a migração dá errado seis meses depois de ter dado certo.
O SQL Server atualiza a linha no lugar. O PostgreSQL não. Cada UPDATE no Postgres grava uma versão nova da linha e deixa a velha pra trás, marcada como morta, até o VACUUM passar e liberar o espaço. É assim que o MVCC dele funciona, e é por isso que leitor não bloqueia escritor.
Agora pensa no Protheus. Delete no Protheus é um UPDATE no D_E_L_E_T_. A SB2 toma pancada de update a noite inteira no recálculo do custo. As tabelas de saldo contábil tomam insert, update e delete em todo fechamento. Tudo isso no Postgres vira linha morta.
Não é teoria. Criei uma sb2010 com a cara da do Protheus (campos CHAR, D_E_L_E_T_, R_E_C_N_O_, índice composto), 300 mil linhas, e rodei cinco passadas de UPDATE no saldo, que é o que um recálculo faz. Olha o tamanho antes e depois:
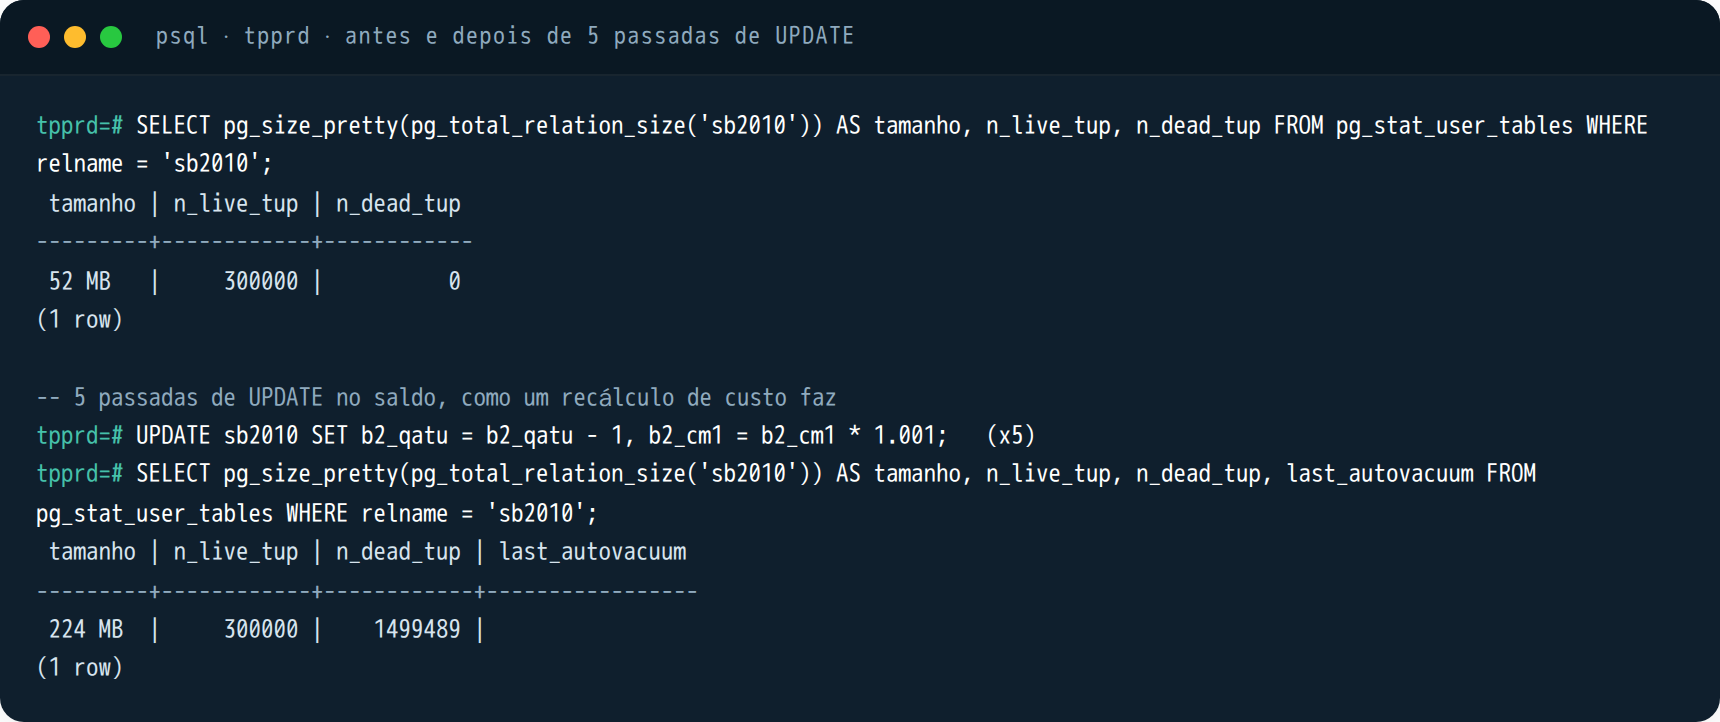
Aí roda o VACUUM. Ele recolhe as mortas, libera o espaço pra reuso dentro da tabela, e a tabela continua com 224 MB. VACUUM comum não devolve espaço pro sistema operacional. Isso é importante pra quem vem do SQL Server e espera um shrink:
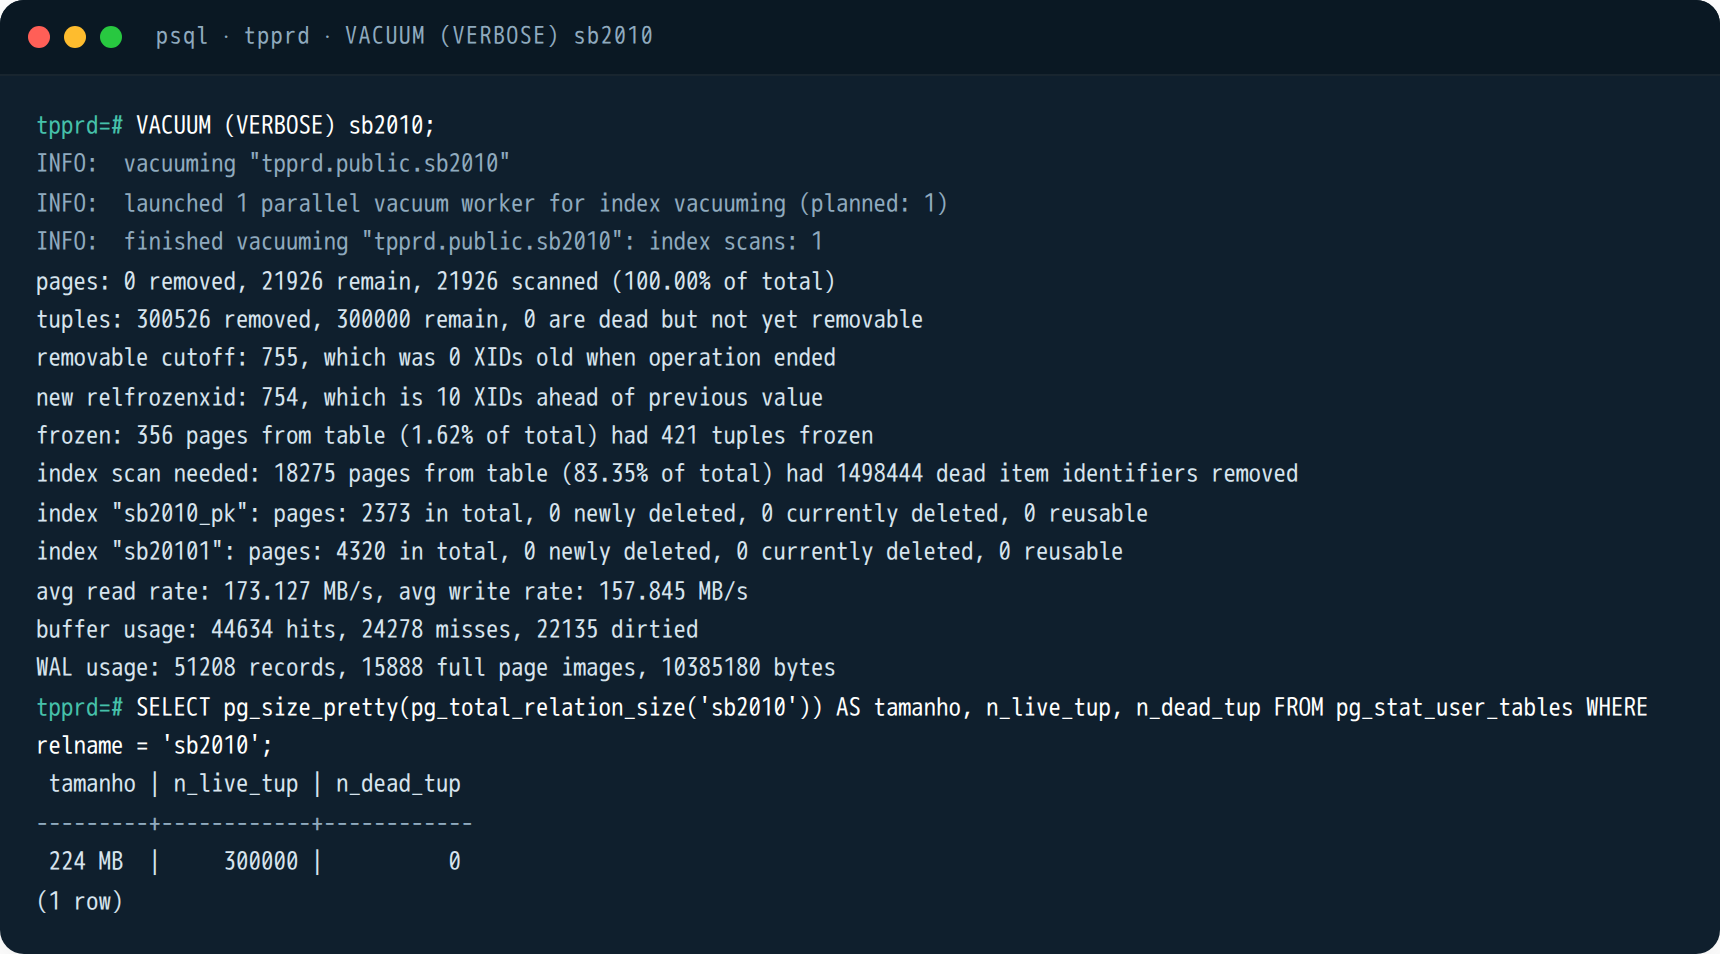
O autovacuum existe pra cuidar disso, e no padrão de fábrica ele é preguiçoso pra tabela grande. O gatilho é 20% da tabela em linhas mortas. Numa SD3 de 100 milhões de linhas, ele espera 20 milhões de linhas mortas pra começar. Numa SB2 que é atualizada em loop, isso é tarde demais. Primeira coisa que eu olho num Protheus em Postgres:
-- quem está inchando e quando o autovacuum passou pela última vez
SELECT relname,
       n_live_tup,
       n_dead_tup,
       ROUND(100.0 * n_dead_tup / NULLIF(n_live_tup + n_dead_tup, 0), 1) AS pct_mortas,
       last_autovacuum,
       last_autoanalyze
  FROM pg_stat_user_tables
 WHERE relname IN ('sb2010', 'sb9010', 'sd3010', 'sd1010', 'cq1010', 'se2010', 'se1010')
 ORDER BY n_dead_tup DESC;
E o ajuste é por tabela, não global. As tabelas que o Protheus martela ganham gatilho próprio. O fillfactor deixa espaço sobrando na página pra versão nova cair na mesma página da antiga, que é o que o Postgres chama de HOT update e poupa o índice:
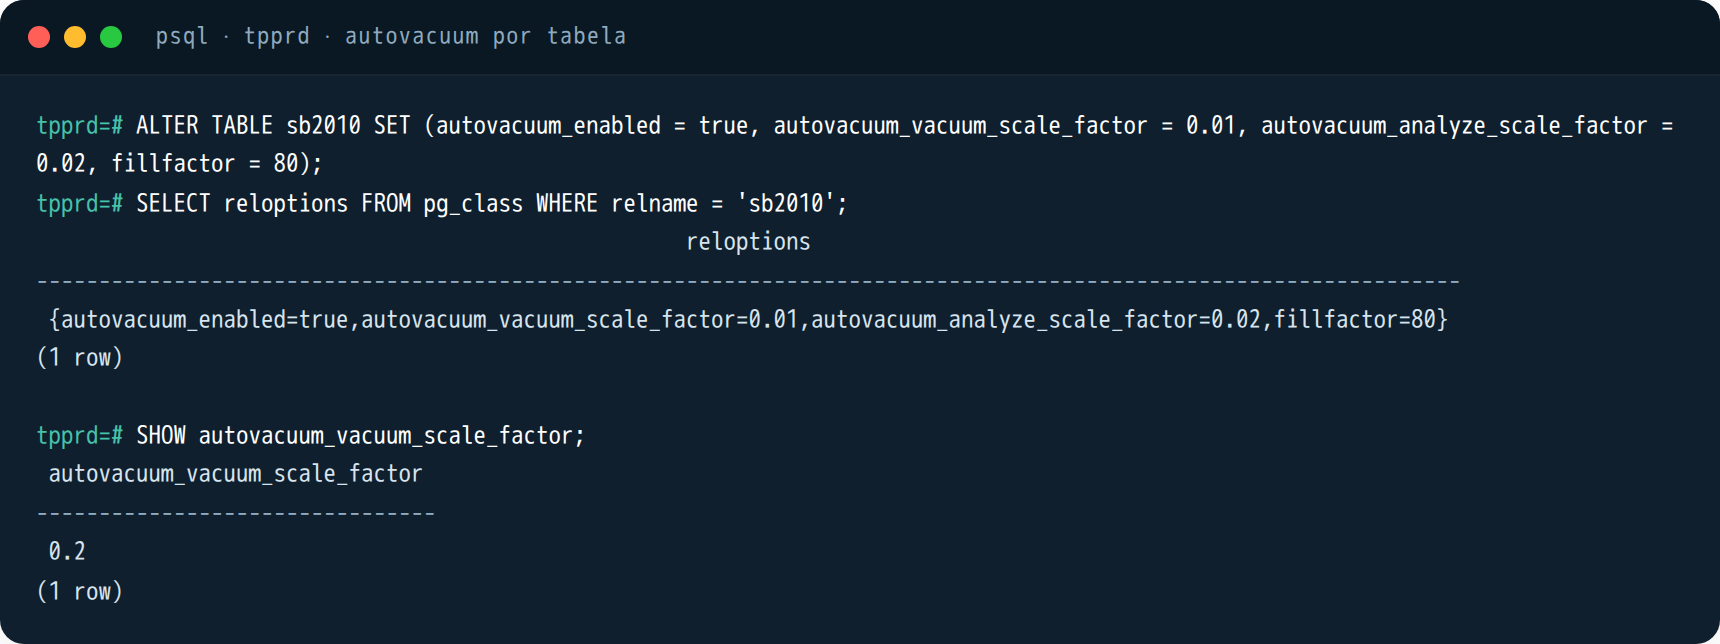
ALTER TABLE sb2010 SET (
  autovacuum_vacuum_scale_factor  = 0.01,
  autovacuum_analyze_scale_factor = 0.02,
  fillfactor = 80
);
ALTER TABLE sd3010 SET (autovacuum_vacuum_scale_factor = 0.02);
ALTER TABLE cq1010 SET (autovacuum_vacuum_scale_factor = 0.01);
Uma observação sobre a página de manutenção da própria TOTVS, que mostra um vacuumdb -z -f -v em bases chamadas tpprd. O -f é o VACUUM FULL. Esse sim devolve espaço, porque reescreve a tabela inteira, mas segura lock exclusivo o tempo todo. Serve pra janela de fim de semana depois de um expurgo grande. Não serve pra rotina, e não serve com gente logada.
Segunda coisa: conexão. No Postgres cada conexão é um processo do sistema operacional, com memória própria. O DBAccess abre conexão por thread do Protheus. O exemplo de dbaccess.ini que a TOTVS publica na página de migração está com ThreadMax=10000. Dez mil processos de Postgres não existem. Então o max_connections e o work_mem têm que ser dimensionados juntos, porque work_mem é por operação de ordenação, por conexão, e a conta explode rápido.
-- quantas conexões o DBAccess está segurando agora, e em que estado
SELECT state, COUNT(*) AS conexoes,
       ROUND(MAX(EXTRACT(EPOCH FROM (now() - state_change))) / 60) AS parada_ha_min
  FROM pg_stat_activity
 WHERE backend_type = 'client backend'
 GROUP BY state
 ORDER BY conexoes DESC;
E não conta com pooler em modo transação (PgBouncer e parecidos) pra resolver isso. O DBAccess depende de estado de sessão, usa tabela temporária, e pool em modo transação quebra exatamente isso. Modo sessão até funciona, mas aí não economiza processo nenhum. A solução é dimensionar o ThreadMax pra realidade de usuários simultâneos e dar memória pro servidor.
Terceira: tamanho. Muita base de Protheus em SQL Server usa compressão de dados, inclusive a TOTVS tem página sobre isso, e o exemplo de migração deles partiu de 600 GB comprimidos. O PostgreSQL não tem compressão de linha. Campo CHAR preenchido com espaço, que é tudo no Protheus, vai ocupar o tamanho declarado. Espera a base crescer no destino. Quanto, só a rodada de teste diz. Não tenho fórmula e desconfio de quem tem.
Quarta: backup e alta disponibilidade. Não existe “backup database to disk” de uma linha. Existe backup físico com arquivamento de WAL, e a ferramenta é pgBackRest ou Barman (a TOTVS cita o Barman na documentação). Always On vira replicação por streaming, e quem orquestra o failover é Patroni, repmgr ou o seu operador de nuvem. Tudo isso é maduro. Tudo isso é diferente. Se o seu runbook de desastre é um .bak numa pasta, ele vai ter que ser reescrito do zero.
Quinta, e essa pega a LGPD: não existe TDE no PostgreSQL comunitário. A TOTVS inclusive avisa na página de homologação:
Com o início da Lei Geral de Proteção de Dados (LGPD), caso seja necessário criptografar o banco de dados, recomendamos o contato com o fornecedor do banco de dados escolhido para verificar se a versão a ser adquirida contempla criptografia de dados nativa.
TOTVS, TDN: DBAccess, página Banco de dados
No Postgres o caminho é criptografar o disco (LUKS, ou o storage da nuvem) ou uma distribuição comercial que traga TDE. No SQL Server eu já mostrei como ligar o TDE, e é uma tarde de trabalho. Se a criptografia em repouso é exigência de auditoria na sua empresa, resolve isso no desenho, antes de migrar.
O que muda pro desenvolvedor
O código padrão da TOTVS já vem com as queries ajustadas pros três bancos. A própria página de migração diz isso, e no mesmo parágrafo manda recompilar as procedures depois:
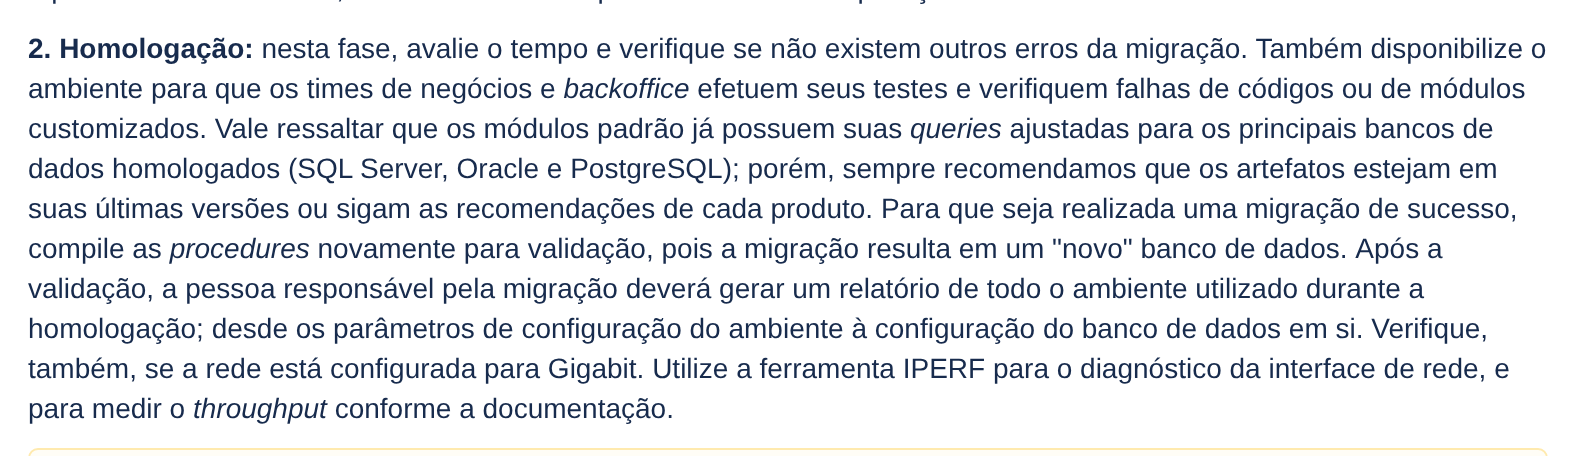
O problema nunca é o padrão. É a customização. Dez anos de ponto de entrada e rotina específica escrita por gente que só conheceu SQL Server deixam T-SQL espalhado pelo fonte. WITH (NOLOCK) é o mais comum, tanto que a TOTVS cita ele nominalmente:
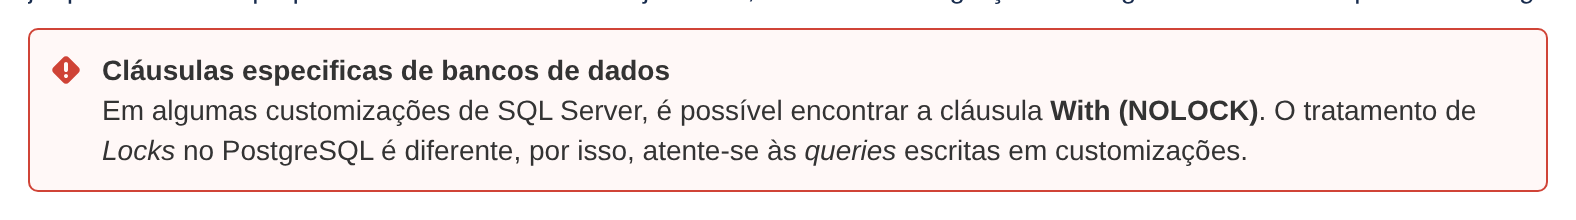
Mas tem mais: GETDATE(), ISNULL(), CONVERT(), TOP 10, DATEADD(), concatenação com +, nome de coluna entre colchetes, tabela temporária com #. Antes de qualquer teste de aplicação, eu faço uma varredura burra no fonte. Burra e eficiente:
# no diretório dos fontes customizados (.prw, .prx, .tlpp)
grep -ril --include='*.prw' --include='*.prx' --include='*.tlpp' \
  -e 'nolock' -e 'getdate' -e 'isnull(' -e 'convert(' -e 'dateadd(' \
  -e ' top ' -e 'datediff(' -e 'charindex(' -e 'with (' . | sort > suspeitos.txt

wc -l suspeitos.txt
Esse número é o tamanho do seu projeto do lado do desenvolvimento. Pode dar dez arquivos, pode dar quatrocentos. É ele que define se a migração é de dois meses ou de um ano, não o tamanho da base.
Duas pegadinhas que não aparecem no grep e que mordem. Testei as duas no laboratório.
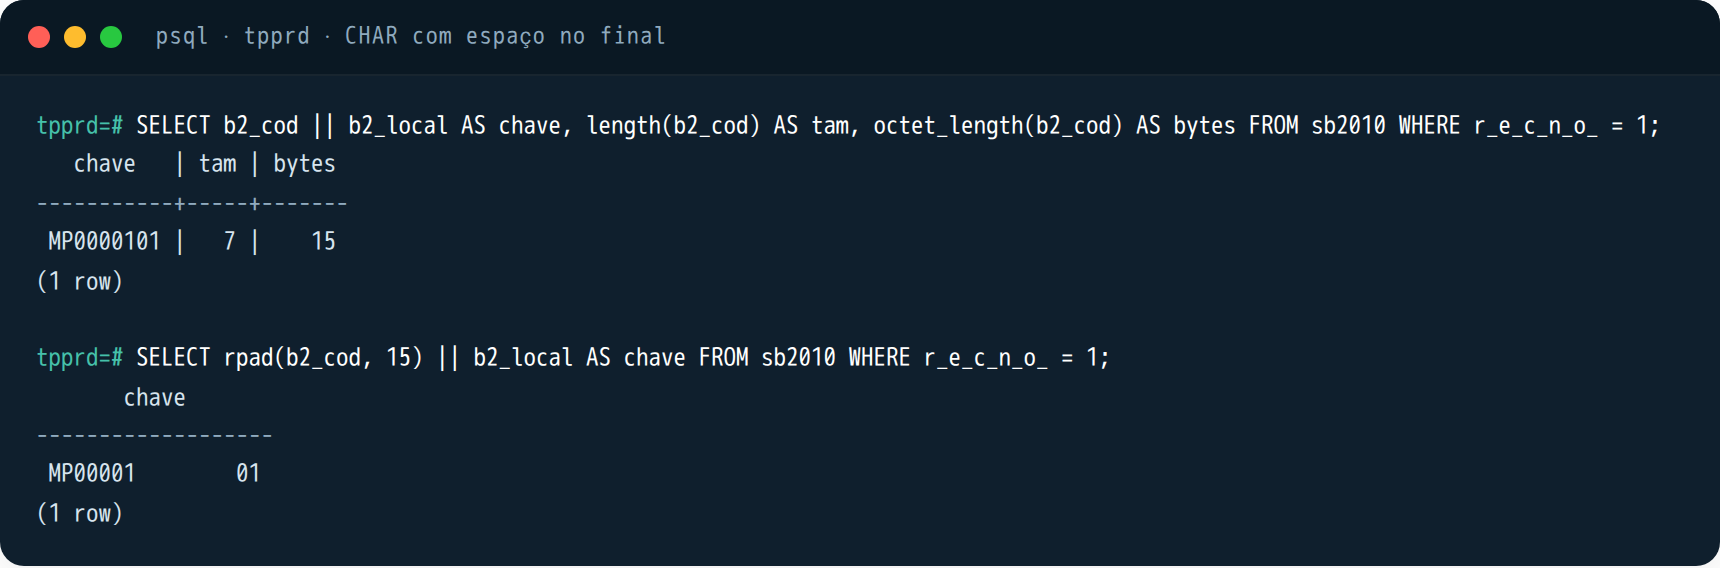
Espaço no final do campo. O Protheus completa todo campo caractere com espaço até o tamanho declarado. No SQL Server, concatenar dois CHAR com + carrega os espaços. No Postgres, o || converte o CHAR pra texto antes, e a conversão descarta os espaços do final. A query não dá erro. Ela devolve outra coisa:
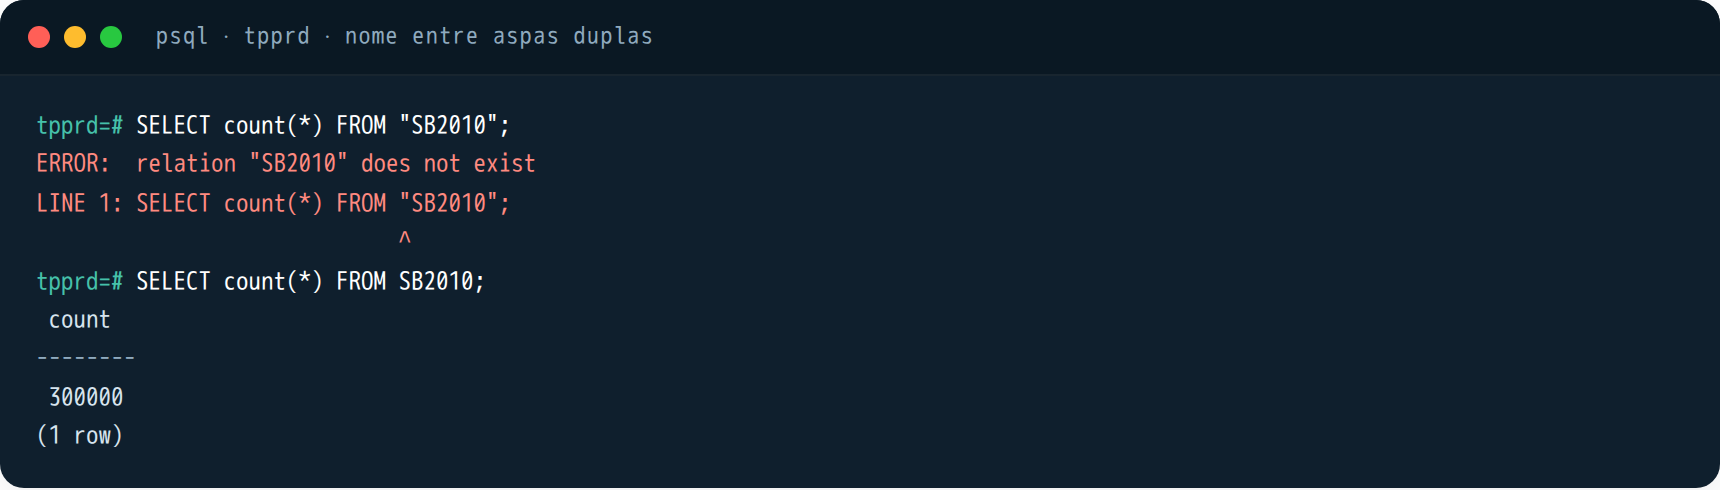
Nome entre aspas duplas. No Postgres, identificador sem aspas vira minúsculo. Tudo que o Protheus manda sem aspas funciona, porque o banco dobra pra minúsculo nos dois lados. Agora uma query que alguém escreveu com "SB2010" entre aspas funciona no SQL Server e quebra no Postgres:
Sobre ordenação e maiúscula, boa notícia: Latin1_General_BIN no SQL Server e collation C no Postgres são as duas ordenações binárias. O ORDER BY sai igual, o LIKE diferencia maiúscula igual, o índice se comporta igual. É exatamente por isso que a TOTVS exige collation C. Quem tenta ser esperto e cria o banco com pt_BR.UTF-8 pra “ordenar bonito” descobre o Protheus se comportando diferente em tela de consulta, e aí já não dá pra mudar sem recriar o banco.
Como a migração acontece de verdade
A ferramenta é da TOTVS, chama DBTools, e mora dentro da pasta de instalação do DBAccess. Ela não fala com banco nenhum diretamente: lê a origem por um DBAccess e grava no destino por outro DBAccess. É cópia, tabela por tabela. Não é replicação, não é CDC, não tem “sincroniza o delta depois”. O desenho é da própria TOTVS:
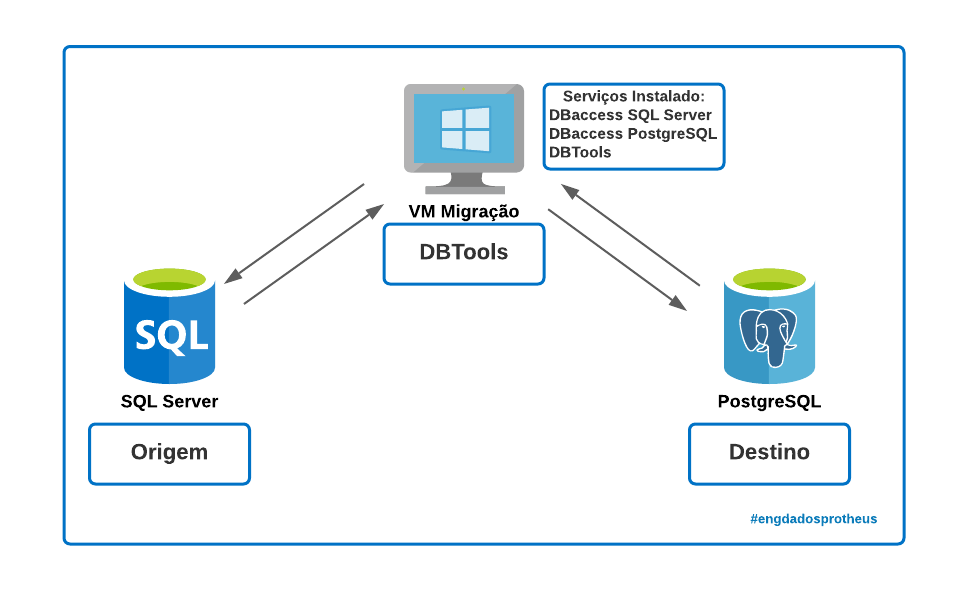
Três regras do migrador que mudam o seu planejamento, nas palavras deles:
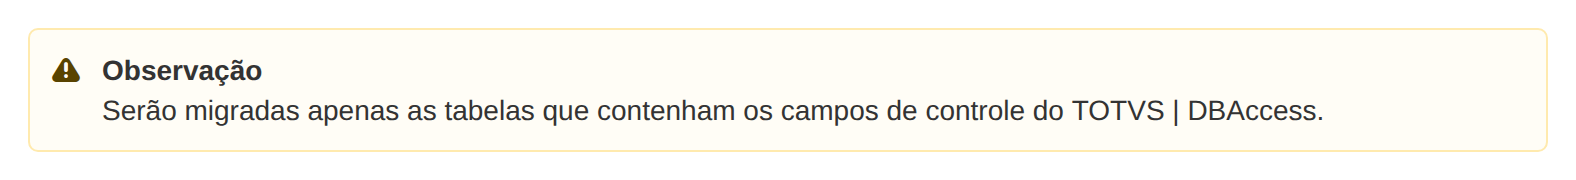
O SGBD de origem não deve ser acessado ou atualizado enquanto os dados estiverem sendo lidos para a cópia.
TOTVS, TDN: DBTools, Migrador de Ambiente (requisitos)

A tela de parâmetros é esta. É modo texto, navega digitando o número da opção:
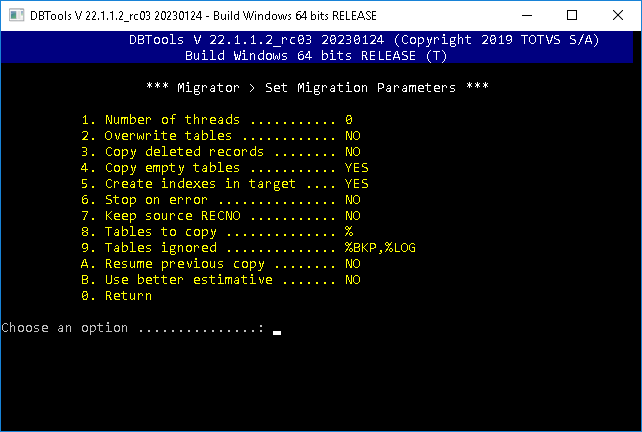
Em produção eu rodo em batch, com arquivo. Esse é o meu ponto de partida, adaptado do exemplo que a TOTVS publicou:
; dbtools.ini
[general]
threads=0          ; deixa ele escalar sozinho; depois da rodada 1 você fixa
overwrite=0
resume=0
copydeleted=1      ; leva os registros com D_E_L_E_T_ = '*' (expurga ANTES, não durante)
copyempty=1
createindex=1
errorstop=0        ; não para na primeira tabela com erro; o log diz quais falharam
keeprecno=1        ; mantém o R_E_C_N_O_ de origem nas tabelas sem numeração automática
copymask=%
ignoremask=%BKP,%LOG

[sourcedb]
dbserver=10.0.0.10
dbport=7898
dbdatabase=MSSQL
dbalias=TPPRDSQL
dbuser=
dbpsw=

[targetdb]
dbserver=10.0.0.10
dbport=7899
dbdatabase=POSTGRES
dbalias=TPPRD
dbuser=
dbpsw=
C:\totvs\dbaccess\dbtools>dbtools.exe /batch /log migracao-rodada1.logDois parâmetros merecem um minuto. copydeleted=1 leva o lixo junto. Se a base tem 30% de registro morto, você vai copiar 30% de lixo e criar índice em cima dele. O caminho certo é expurgar na origem, do jeito certo, com o módulo e o dicionário, semanas antes da rodada 1. Migração não é hora de limpar base. E keeprecno=1: por padrão ele vem desligado e a TOTVS diz que não é necessário. Eu ligo, porque tem integração por aí que guardou R_E_C_N_O_ como se fosse chave, mesmo a TOTVS dizendo, na página de campos UUID, que “o valor do R_E_C_N_O_ não deve ser usado como chave estrangeira”.
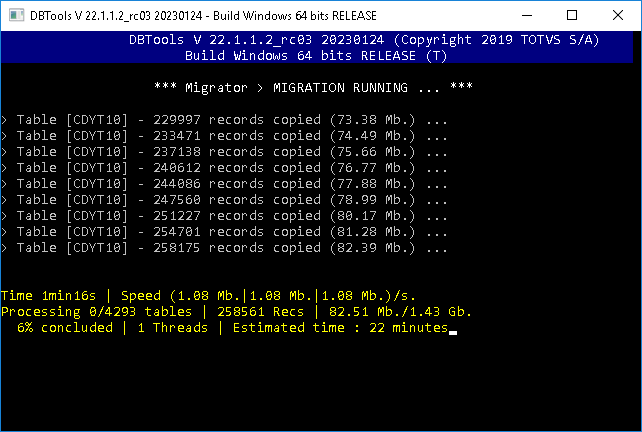
Rodando, a tela é esta. Repara no “Threads”: com threads=0 ele sobe um processo, mede 90 segundos, sobe outro, e só para de subir quando o próximo não aumentar a vazão, que normalmente é quando a rede ou o disco do destino saturam:
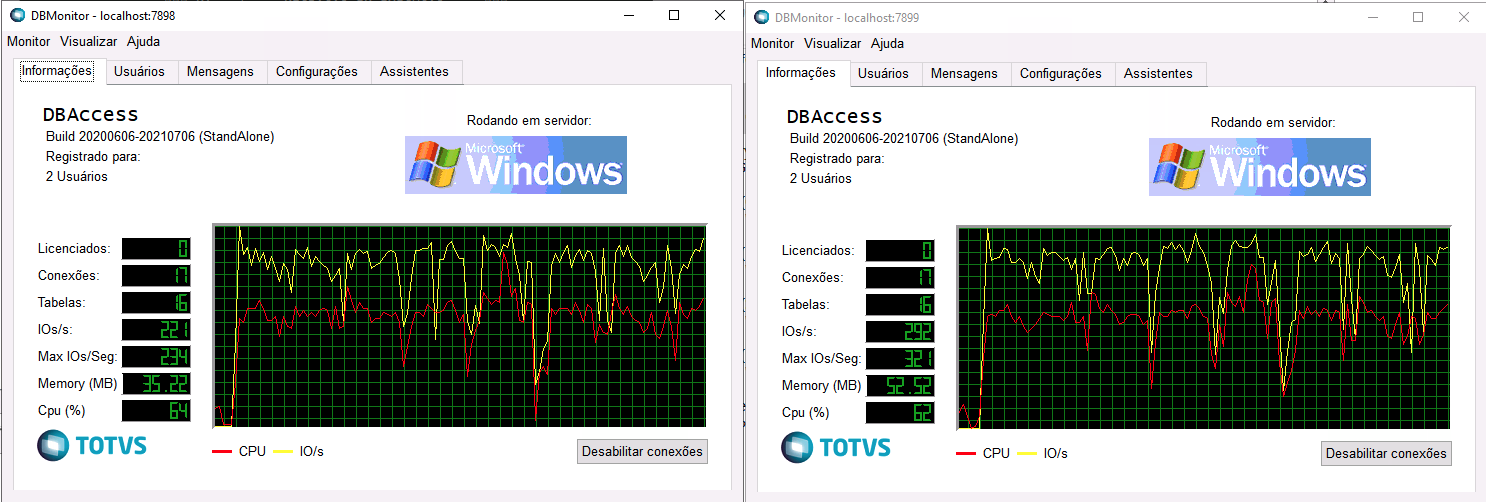
Do lado do Postgres, a carga inicial é a única hora em que eu mexo em parâmetro de durabilidade. Volta tudo antes de abrir pra usuário:
# postgresql.conf, SÓ durante a carga do DBTools
maintenance_work_mem = 2GB          # criação de índice depois de cada tabela
max_wal_size = 16GB                 # menos checkpoint no meio do insert em massa
checkpoint_timeout = 30min
synchronous_commit = off            # commit não espera o fsync do WAL
autovacuum = off                    # ele só atrapalha enquanto a tabela está nascendo
wal_level = minimal                 # exige max_wal_senders = 0; sem réplica durante a carga
max_wal_senders = 0

# depois da carga: volta tudo, reinicia, e roda
# VACUUM (ANALYZE, VERBOSE);   -- estatística do banco inteiro antes do primeiro teste
Quanto tempo leva? A TOTVS publicou o laboratório deles: “o tempo previsto estava em torno de 5h38min para migrar em torno de 600GB”, com máquinas de 8 cores, rede de 4 Gbit e discos entre 800 e 2.000 IOPS. A sua conta vai ser outra. A rodada 1 existe pra descobrir qual. E a TOTVS manda medir a rede com iperf antes, porque o gargalo da cópia costuma ser rede ou IOPS do destino, não CPU.
Esse tempo é a sua janela de produção, porque a origem tem que ficar parada do começo ao fim. Se a janela não cabe no fim de semana, as opções são emagrecer a base antes (expurgo, tabelas de backup que ninguém usa, log de integração de cinco anos) ou aceitar uma parada maior. O que não existe é “copia durante a semana e sincroniza o resto na virada”. Não com essa ferramenta.
E quantas vezes? A TOTVS responde:

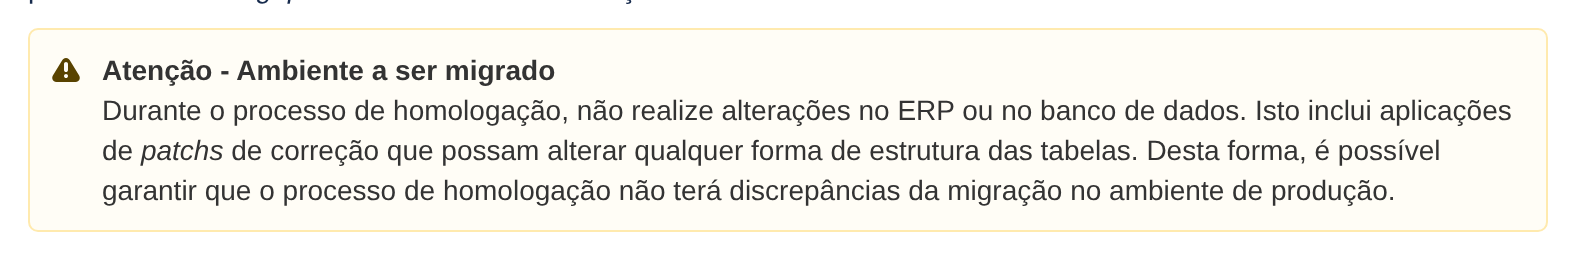
O aviso da fase 2 é o que mais vejo ser ignorado. Alguém aplica um patch de correção no meio da homologação, a estrutura de uma tabela muda, e a rodada de produção migra uma base diferente da que foi testada:
Quando eu não migraria
Se o motivo é só o fim de suporte do 2016 ou do 2017. Fugir de prazo é o pior motivo pra trocar de SGBD. Nesse caso o caminho curto é subir pro SQL Server 2022 ou 2025, que é upgrade de versão, e decidir o PostgreSQL com calma, no ano que vem, com uma rodada de teste feita sem pressão.
Se o time de infra é 100% Windows e não tem ninguém pra operar Linux. A TOTVS não recomenda Postgres em Windows pra produção, e eu também não. Você vai trocar licença por dependência.
Se tem meio mundo lendo o banco direto. Power BI apontado na SB2, linked server de outro sistema, pacote de SSIS, integração que faz SELECT na SA1 de madrugada. Cada um desses é um projeto paralelo que ninguém orçou. Faz o inventário antes de prometer data.
Se o suspeitos.txt deu centenas de arquivos e não tem desenvolvedor pra revisar. A base migra em um fim de semana. A customização, não.
Agora, se você tem quatro ambientes com o mesmo motor, a renovação de licença está na mesa, o time já opera Linux em outras coisas, e o grep voltou pequeno, aí a conta fecha rápido. E fecha todo ano de novo.
Quando chamar um especialista
Se a sua renovação do SQL Server está chegando, ou o seu 2016 já está sem suporte, o passo certo não é escolher banco. É fazer o inventário: versão do DBAccess, varredura das customizações, quem lê o banco por fora, tamanho real da base sem o lixo, e uma rodada 1 de cópia pra medir a janela. Com isso na mão a decisão vira conta, não aposta. É isso que a Furushima faz na frente de consultoria de banco de dados e de sustentação de Protheus: assessment do ambiente, as três rodadas de migração com a ferramenta oficial da TOTVS, e o DBA do outro lado quando o autovacuum resolver aparecer.
Foto de capa: Bernard Dupont, CC BY-SA 2.0, via Wikimedia Commons (recorte). Prints marcados como TDN são da documentação pública da TOTVS, reproduzidos para citação, com link na lista abaixo. Prints do psql são de um PostgreSQL 16 de laboratório.
Referências
- TOTVS TDN: Bancos de dados homologados para o TOTVS DBAccess (versões, política de homologação, ODBC30, driver ODBC, LGPD)
- TOTVS TDN: Banco de Dados Homologados para o Protheus (encoding, collation, contrib)
- TOTVS TDN: PostgreSQL na Linha Microsiga Protheus (stored procedures suportadas)
- TOTVS TDN: DBTools, Migrador de Ambiente (parâmetros, modo batch, retomada, telas)
- TOTVS TDN: DBTools, dicas de migração (três rodadas, NOLOCK, Linux, sizing, tempo de 600 GB, arquitetura)
- TOTVS TDN: Protheus com PostgreSQL em Linux (instalação, cluster, DBAccess, backup)
- TOTVS TDN: Campos UUID no DBAccess (e por que R_E_C_N_O_ não é chave estrangeira)
- TOTVS TDN: Stored Procedures, novo gerenciador de pacotes
- Microsoft: fim de suporte do SQL Server 2016 e 2017
- Microsoft: SQL Server 2025 Pricing Datasheet (preços de lista por pacote de 2 cores)
- PostgreSQL: Routine Vacuuming (autovacuum, scale factor, bloat)
- PostgreSQL: Populating a Database (parâmetros pra carga em massa)