
O que é busca vetorial, e qual banco de dados faz melhor esse papel? Hoje os quatro bancos que mais aparecem em empresa no Brasil dizem que fazem busca vetorial: Oracle 26ai, SQL Server 2025, PostgreSQL com pgvector e MySQL 9.7. Coloquei o MariaDB 11.8 junto, porque ele nasceu do MySQL, roda em muita empresa no lugar dele e tem índice vetorial nativo. Eu fui testar o que cada um faz de verdade. Peguei a tabela de produtos (SB1) de um Protheus de desenvolvimento, fiz as mesmas 100 perguntas em cada banco, no mesmo servidor, e medi. Antes de mostrar os resultados, explico do zero o que é essa busca e quais ferramentas usei, porque sem isso os números não dizem nada. O SQL Server 2025 ficou de fora do lab por uma questão de licença: a parte dele saiu da documentação da Microsoft, e eu aviso onde.
O que é busca vetorial, explicado do zero
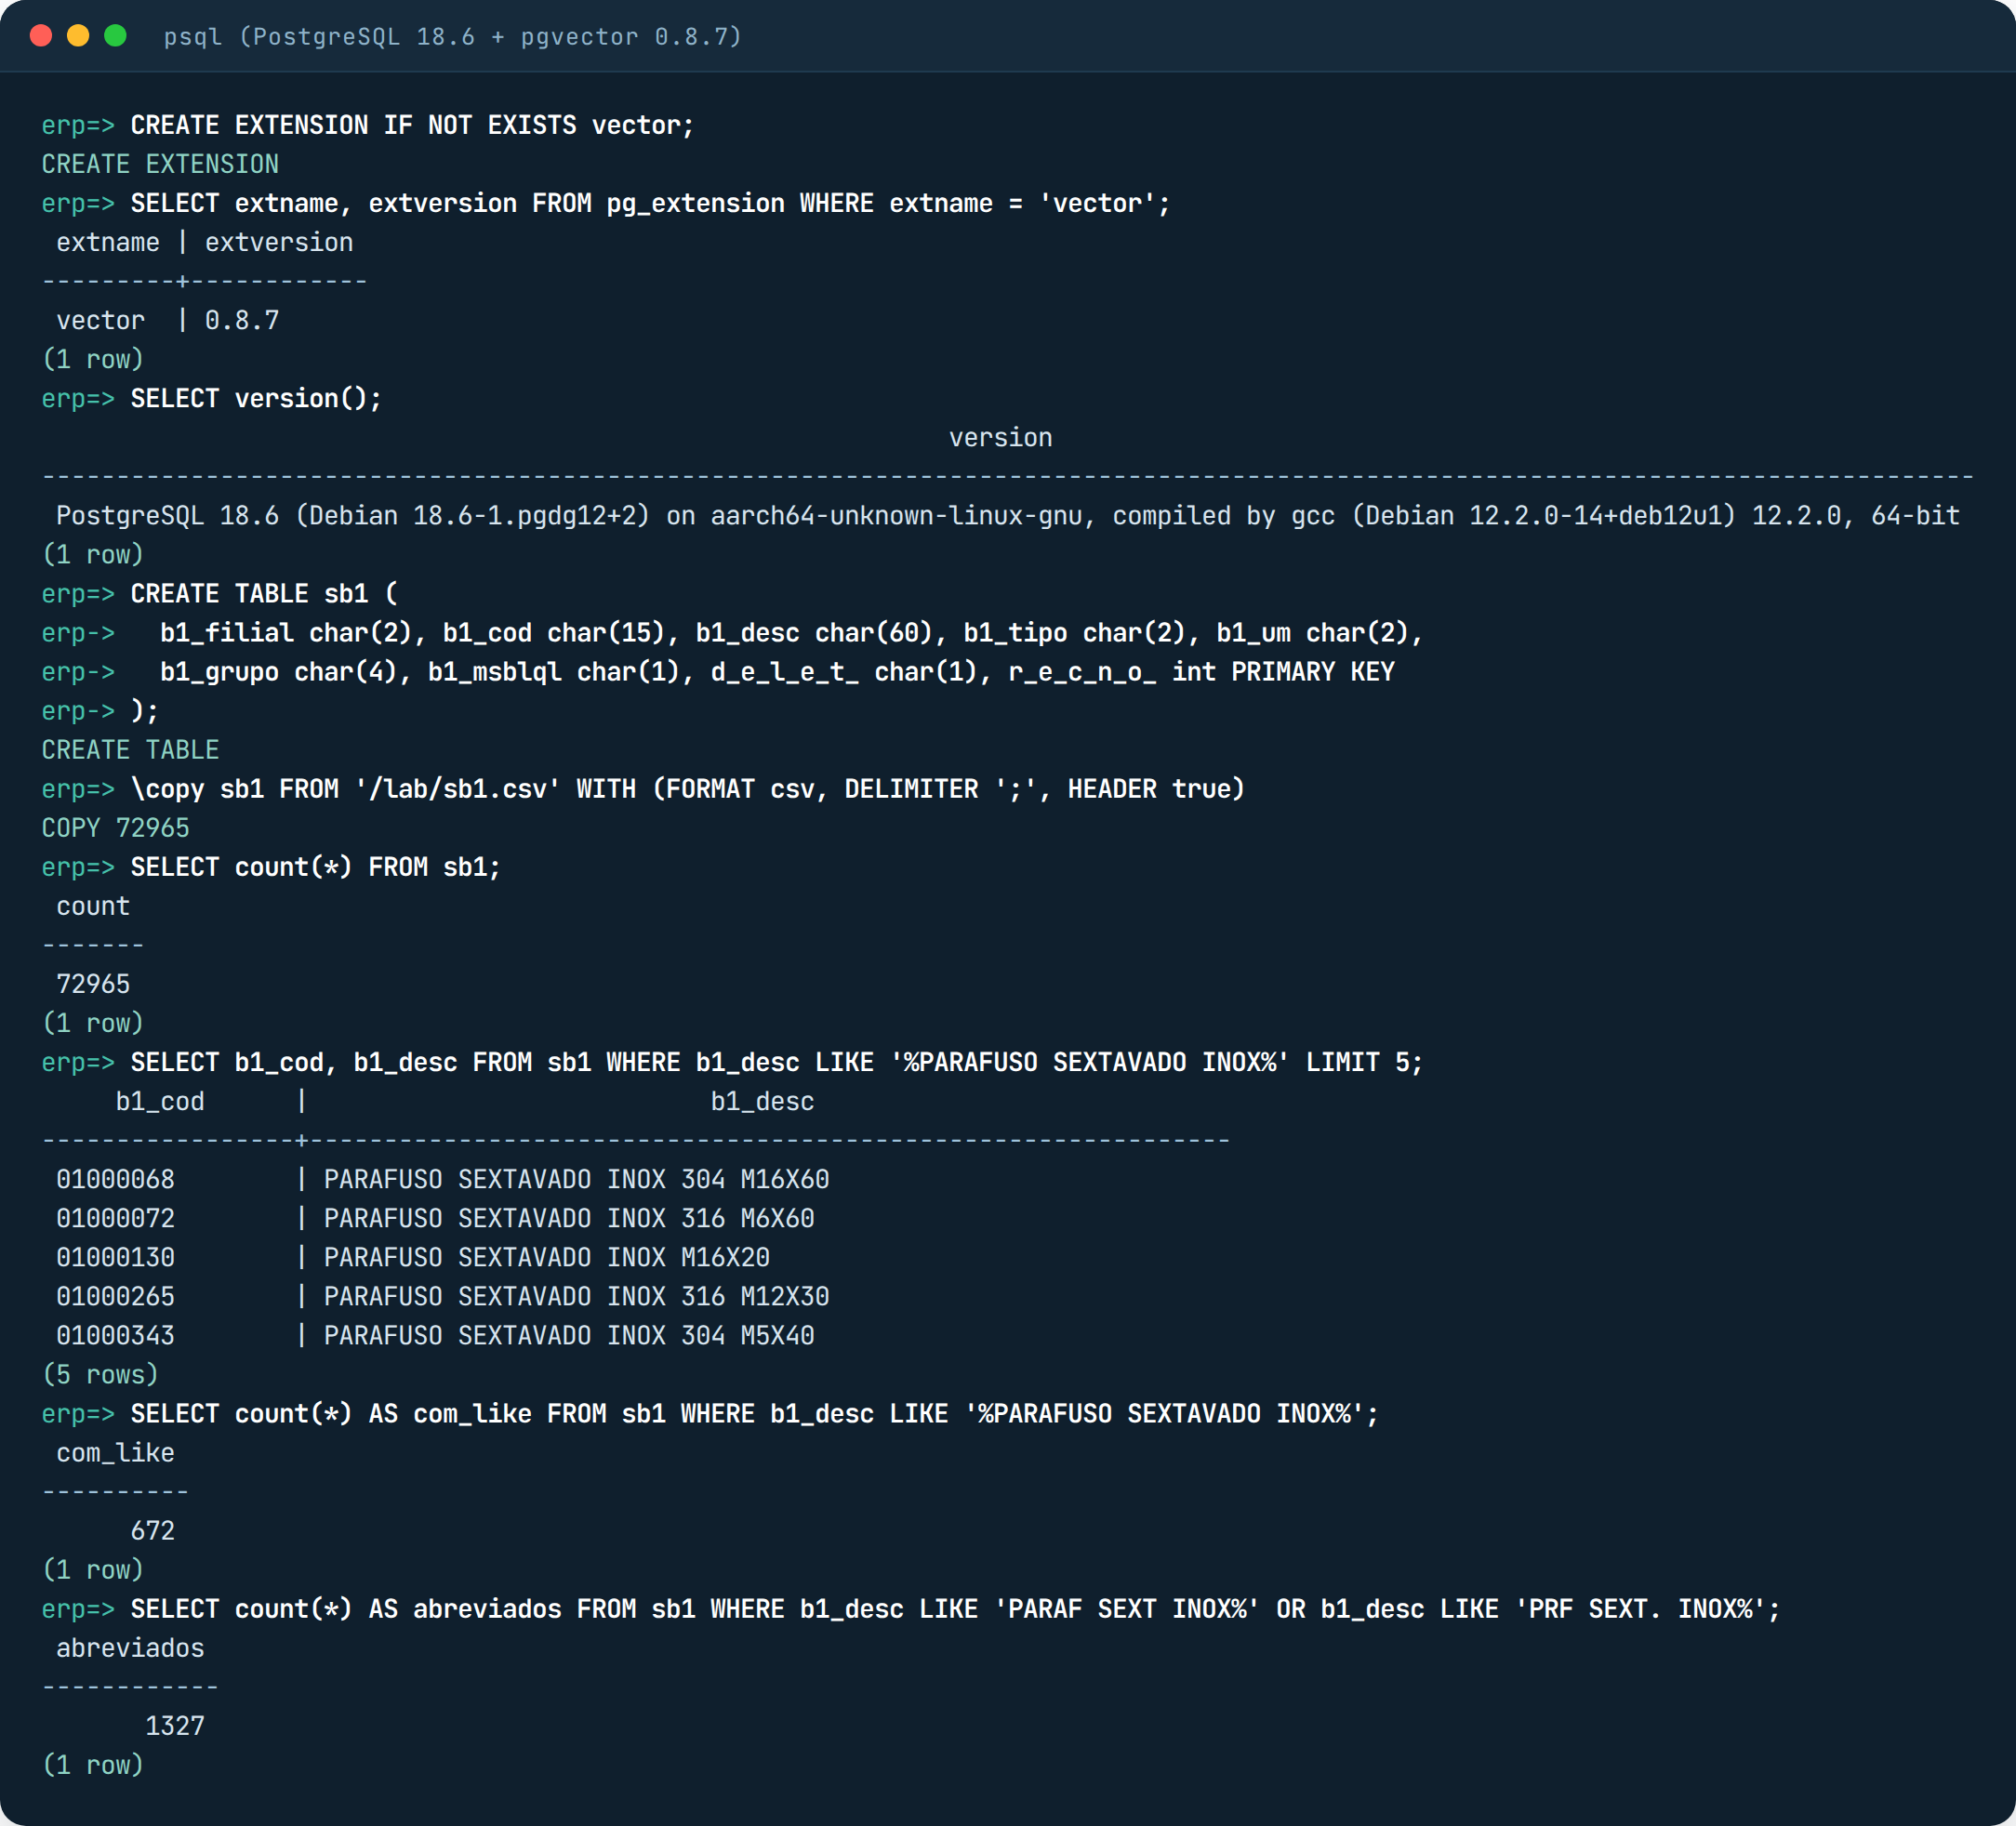
A busca que todo sistema tem é por palavra escrita. No banco ela é o LIKE: você procura ‘%PARAFUSO SEXTAVADO INOX%’ e ele devolve as linhas que tem exatamente esse pedaço de texto. Se o produto foi cadastrado como PARAF SEXT INOX, ele não aparece, mesmo sendo o mesmo parafuso. Cadastro de ERP é cheio disso.
Busca vetorial é a busca por sentido. Em vez de comparar letras, ela compara o significado. Pra isso cada texto vira um vetor, que é só uma lista de números. Essa lista é gerada por um modelo, um programa treinado pra ler texto e devolver números de um jeito que textos com sentido parecido viram listas parecidas. “Parafuso sextavado inox” e “PARAF SEXT INOX M8X30” viram listas quase iguais, mesmo escritos diferente. O nome em inglês desse vetor é embedding; é a mesma coisa.
Com os vetores guardados na tabela, a busca funciona assim: a pergunta da pessoa também vira um vetor, e o banco procura os produtos cujo vetor está mais perto do vetor da pergunta. “Perto” é uma conta de distância entre as duas listas, e quanto menor a distância, mais parecido o sentido. Os 10 mais perto são a resposta.
Essa conta pode ser feita de dois jeitos. O jeito completo compara a pergunta com todos os produtos, um por um. Nunca erra, mas em tabela grande fica lento, porque o tempo cresce junto com a tabela. O jeito com índice usa um atalho que o banco prepara antes, e aí a busca olha só uma parte dos produtos. É rápido, mas pode deixar passar alguém. Cada banco tem o seu tipo de atalho, e eu explico cada um numa seção só pra isso, antes de entrar nos testes.
Por isso existe uma nota pro atalho, que chama recall. Dos 10 produtos que o atalho devolveu, quantos são tão bons quanto os 10 da busca completa? Recall 100% é o atalho acertando tudo. Recall 75% quer dizer que, dos 10, uns 2 ou 3 não deviam estar ali. Vou usar essa palavra o tempo todo daqui pra frente.
As ferramentas do lab e como eu usei cada uma
O dado. Montei uma SB1 de mentira, mas com cara de verdade: 72.965 produtos em 21 grupos (parafusos, cabos, tintas, EPI e por aí vai). As descrições vêm misturadas do jeito que o cadastro real tem, o mesmo parafuso como PARAFUSO SEXTAVADO INOX M8X30, PARAF SEXT INOX M8X30 e PRF SEXT. INOX 8X30MM. Também tem 3% de registro deletado (D_E_L_E_T_ = ‘*’) e 4% bloqueado, porque é assim que a tabela vive. O LIKE mostra o problema logo de cara: procurar ‘%PARAFUSO SEXTAVADO INOX%’ acha 672 itens e deixa 1.327 abreviados de fora.
O modelo. Usei o all-MiniLM-L12-v2, que gera listas de 384 números (a gente diz 384 dimensões). Pra rodar o modelo usei o ONNX Runtime, que é um motor leve pra executar esse tipo de programa, sem precisar instalar o PyTorch, que é pesado. Gerei o vetor de cada um dos 72.965 produtos uma vez só, fora dos bancos, e gravei tudo num arquivo. Fiz assim de propósito: se cada banco gerasse o próprio vetor, eu não saberia se a diferença no resultado era do banco ou do vetor. Com o mesmo arquivo nos quatro, a comparação é justa. Vetorizar tudo levou 16 minutos nos 2 núcleos, uns 75 produtos por segundo.
Testei também um segundo modelo, o multilíngue e5-small, achando que ia ganhar por entender português. Perdeu de pouco: 92,4% contra 94,3% do MiniLM. Essa porcentagem é uma conta simples que fiz pra escolher: pego os 10 produtos mais parecidos que o modelo devolve pra cada pergunta e conto quantos caem no grupo certo (perguntei de parafuso, voltou parafuso?). Fiquei com o MiniLM, que ainda por cima é o modelo que a Oracle distribui pronto pra rodar dentro do banco (volto nisso).
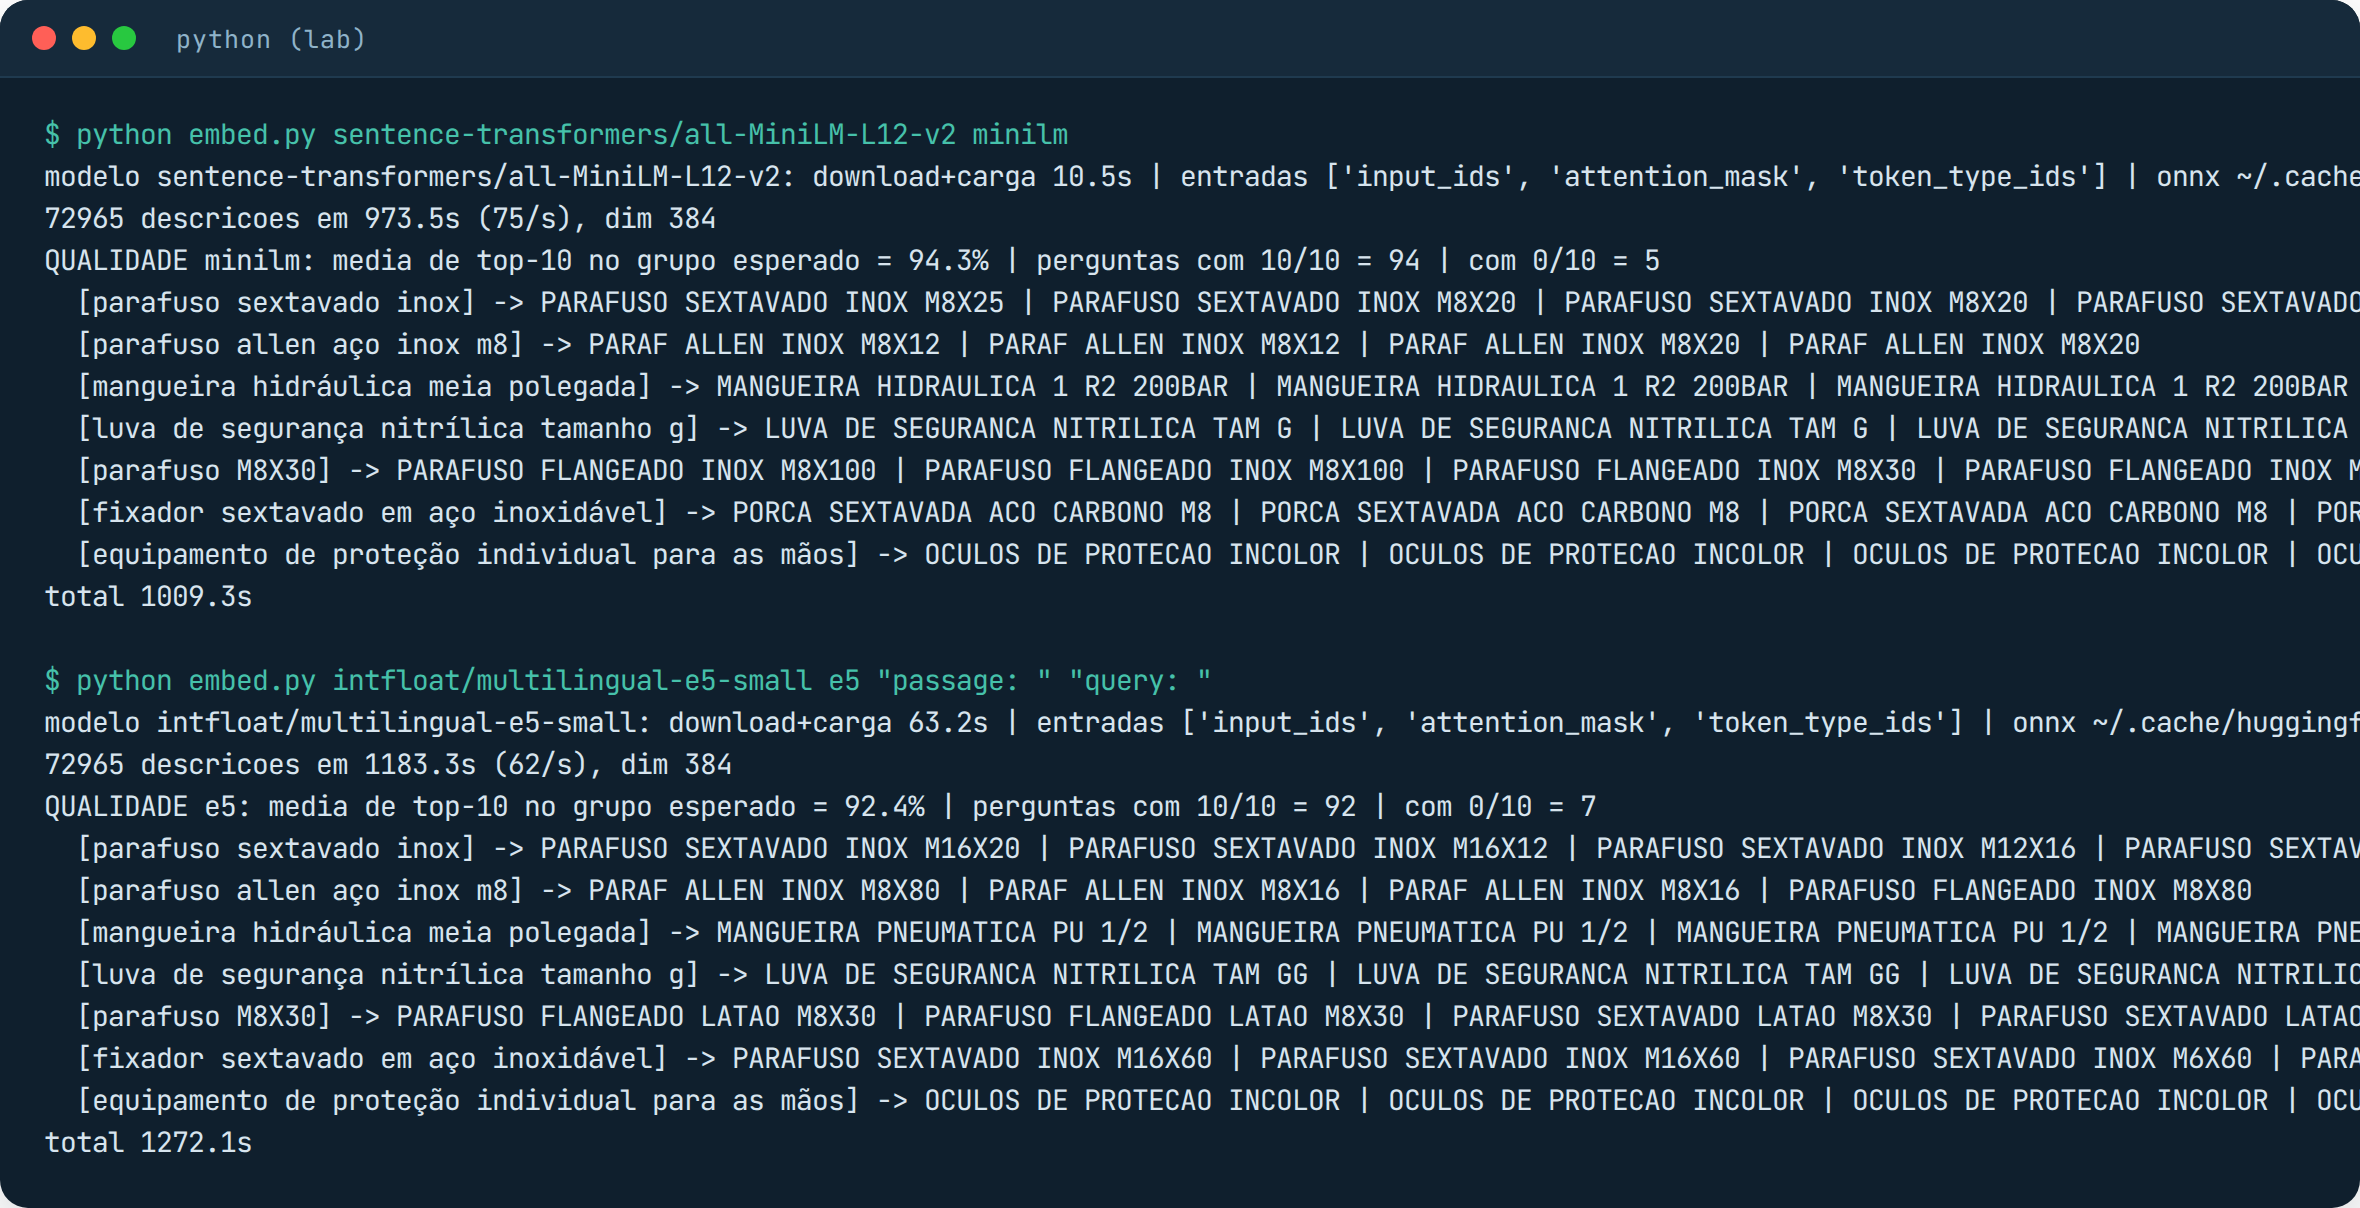
As perguntas. São 100, em português de gente: “parafuso sextavado inox”, “mangueira hidráulica meia polegada”, “luva de segurança nitrílica tamanho g”. Cada uma virou um vetor com o mesmo modelo, e esse vetor foi gravado numa tabelinha em cada banco, pra consulta não depender de nada de fora.
A medição. Um script em Python faz as mesmas 100 perguntas em cada banco, três vezes, joga fora a primeira rodada (que é a de aquecimento) e anota três coisas: a mediana, que é o tempo “do meio” (metade das perguntas foi mais rápida, metade mais lenta); o p95, que é o tempo que só 5% das perguntas passaram; e o recall, comparando a resposta do banco com a busca completa feita fora, nos mesmos vetores. Como tem muita descrição repetida no cadastro (vetor igual), o recall compara pela distância e não pelo código do produto, senão o empate derruba a nota sem motivo.
Os bancos. PostgreSQL 18.6 com pgvector 0.8.7, Oracle AI Database 26ai Free (versão 23.26.3), MySQL 9.7.4 Community e MariaDB 11.8.8, cada um em container Docker, um de cada vez, no mesmo servidor de 2 vCPU e 6,7 GB de RAM. O SQL Server 2025 entra só pela documentação. Agora, um por um.
Os índices que aparecem neste lab, e a diferença entre eles
Primeiro, o que é um plano de execução, porque ele aparece em vários prints. Quando você manda um SELECT, o banco decide sozinho por onde vai buscar o dado: ler a tabela inteira, ir por um índice, em que ordem. Essa decisão é o plano. O comando EXPLAIN mostra o plano sem precisar adivinhar. Nos prints do PostgreSQL, quando aparece Seq Scan quer dizer que ele leu as 72.965 linhas uma por uma; quando aparece Index Scan using sb1_emb_hnsw, ele foi pelo índice. Na Oracle é a mesma coisa com outros nomes: TABLE ACCESS FULL é ler tudo, VECTOR INDEX HNSW SCAN é ir pelo índice. É assim que eu sei se o banco usou o atalho ou não, em vez de confiar no tempo.
Sem índice nenhum, a busca é a completa: o banco calcula a distância da pergunta pra cada um dos 72.965 vetores e fica com os 10 menores. Foi o que deu 49 ms no PostgreSQL e 200 ms na Oracle. Acerta sempre. O problema é só o tempo, que dobra se a tabela dobrar.
O HNSW é o índice que PostgreSQL e Oracle usam, e a ideia é a de um mapa de vizinhança. Na hora de montar o índice, o banco liga cada produto aos poucos produtos mais parecidos com ele, como uma rede de amigos. Na busca, ele entra num ponto qualquer da rede, olha os vizinhos, pula pro que está mais perto da pergunta, olha os vizinhos desse, e vai assim até não achar ninguém mais perto. Em vez de 72.965 comparações, faz algumas centenas. Por isso 0,6 ms em vez de 50. O preço é que ele pode parar num canto do mapa achando que chegou, quando o produto certo estava em outro canto; é daí que vem o recall abaixo de 100%. O ajuste ef_search, no pgvector, é quantos candidatos ele carrega no bolso enquanto anda: com 40 (o padrão) acertou 75%, com 400 acertou 94,5%, gastando mais tempo.
O HNSW do pgvector e o da Oracle são o mesmo tipo de mapa, mas moram em lugares diferentes. O do pgvector é gravado em disco, como qualquer índice do PostgreSQL (deu 36 MB), e o banco traz pra memória o pedaço que usa. O da Oracle só existe na memória RAM: o nome completo é ORGANIZATION INMEMORY NEIGHBOR GRAPH, e ele vive numa área reservada chamada vector pool. É por isso que na Oracle eu precisei configurar o vector_memory_size antes, que a montagem demorou quase 2 minutos (ela constrói a rede inteira na memória e ainda ajusta a precisão) e que, se o banco reiniciar, o índice é montado de novo. Em troca, a Oracle deixa você dizer o quanto pode errar, WITH TARGET ACCURACY 95, e cumpre: deu 96%.
Tem uma diferença que importa mais que a velocidade: como cada um trata o WHERE. O pgvector primeiro anda no mapa, separa os candidatos, e só depois aplica o filtro; se nenhum candidato passar no filtro, volta vazio. A Oracle olha o filtro antes de decidir, e quando acha que ele deixa poucas linhas, desiste do mapa e faz a busca completa só nessas linhas. Um erra pra menos, o outro gasta mais. Isso aparece nos testes de cada banco.
O índice híbrido, que só a Oracle tem, é outra coisa: são dois índices em um. Um de texto, do Oracle Text, que acha palavra exata (o “M8X30”); e um de vetor, que acha pelo sentido (“parafuso inox”). Na busca os dois dão nota, e a nota final junta as duas. E ele gera os vetores sozinho, com o modelo que está dentro do banco, por isso demorou 33 minutos pra montar: estava vetorizando 73 mil descrições.
O do SQL Server 2025 chama DiskANN. Também é um mapa de vizinhança, mas desenhado pra ficar em disco SSD, não só na memória, pra caber tabela maior que a RAM. É o que está em preview. Eu não medi.
O MariaDB tem o seu, que chama MHNSW. É o mesmo tipo de mapa de vizinhança do HNSW, gravado dentro do InnoDB como um índice normal da tabela, e com um detalhe bom: o MariaDB guarda os vetores do índice de um jeito compacto, então a busca é rápida e a precisão veio alta sem mexer em nada (99% no padrão). O ajuste de quantos candidatos olhar chama mhnsw_ef_search, e o padrão é 20. O que ele não tem é um jeito de corrigir o problema do WHERE, como o iterative scan do pgvector; você vai ver isso nos testes.
O MySQL Community não tem índice nenhum pra vetor, então não entra nessa conversa. Agora os testes, um banco por vez.
PostgreSQL com pgvector: funcionou de primeira, até chegar o filtro
pgvector é a extensão que dá ao PostgreSQL o tipo de coluna vector e as contas de distância. Criei a coluna vector(384), carreguei os vetores do arquivo por uma tabela temporária e fiz um UPDATE pra casar cada vetor com o seu produto: 11 segundos, 155 MB no total.
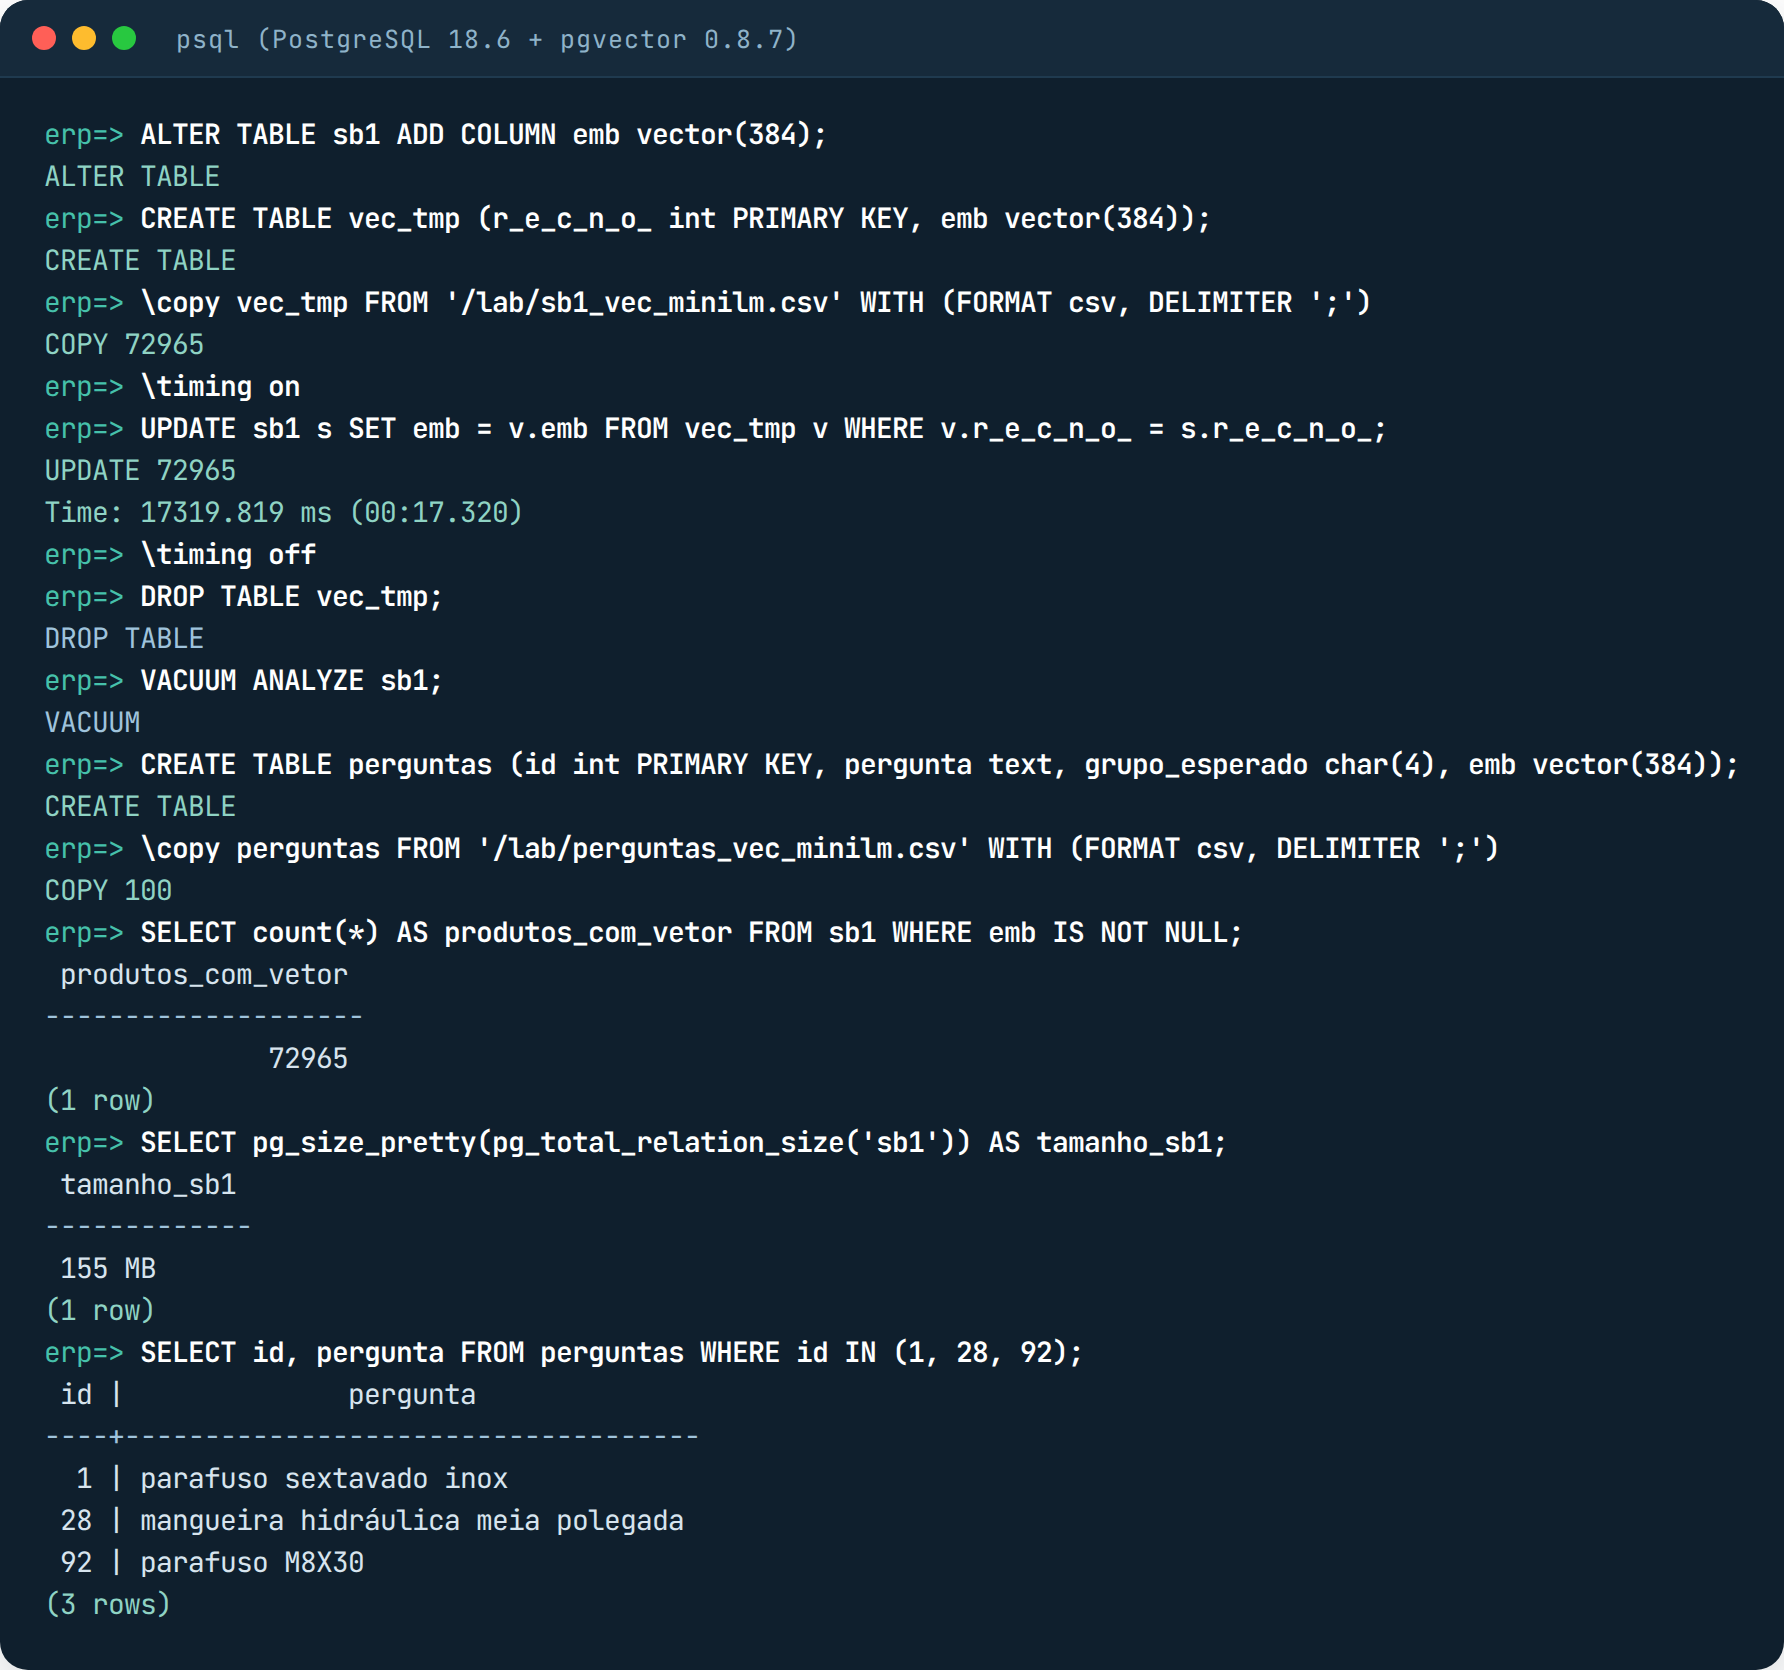
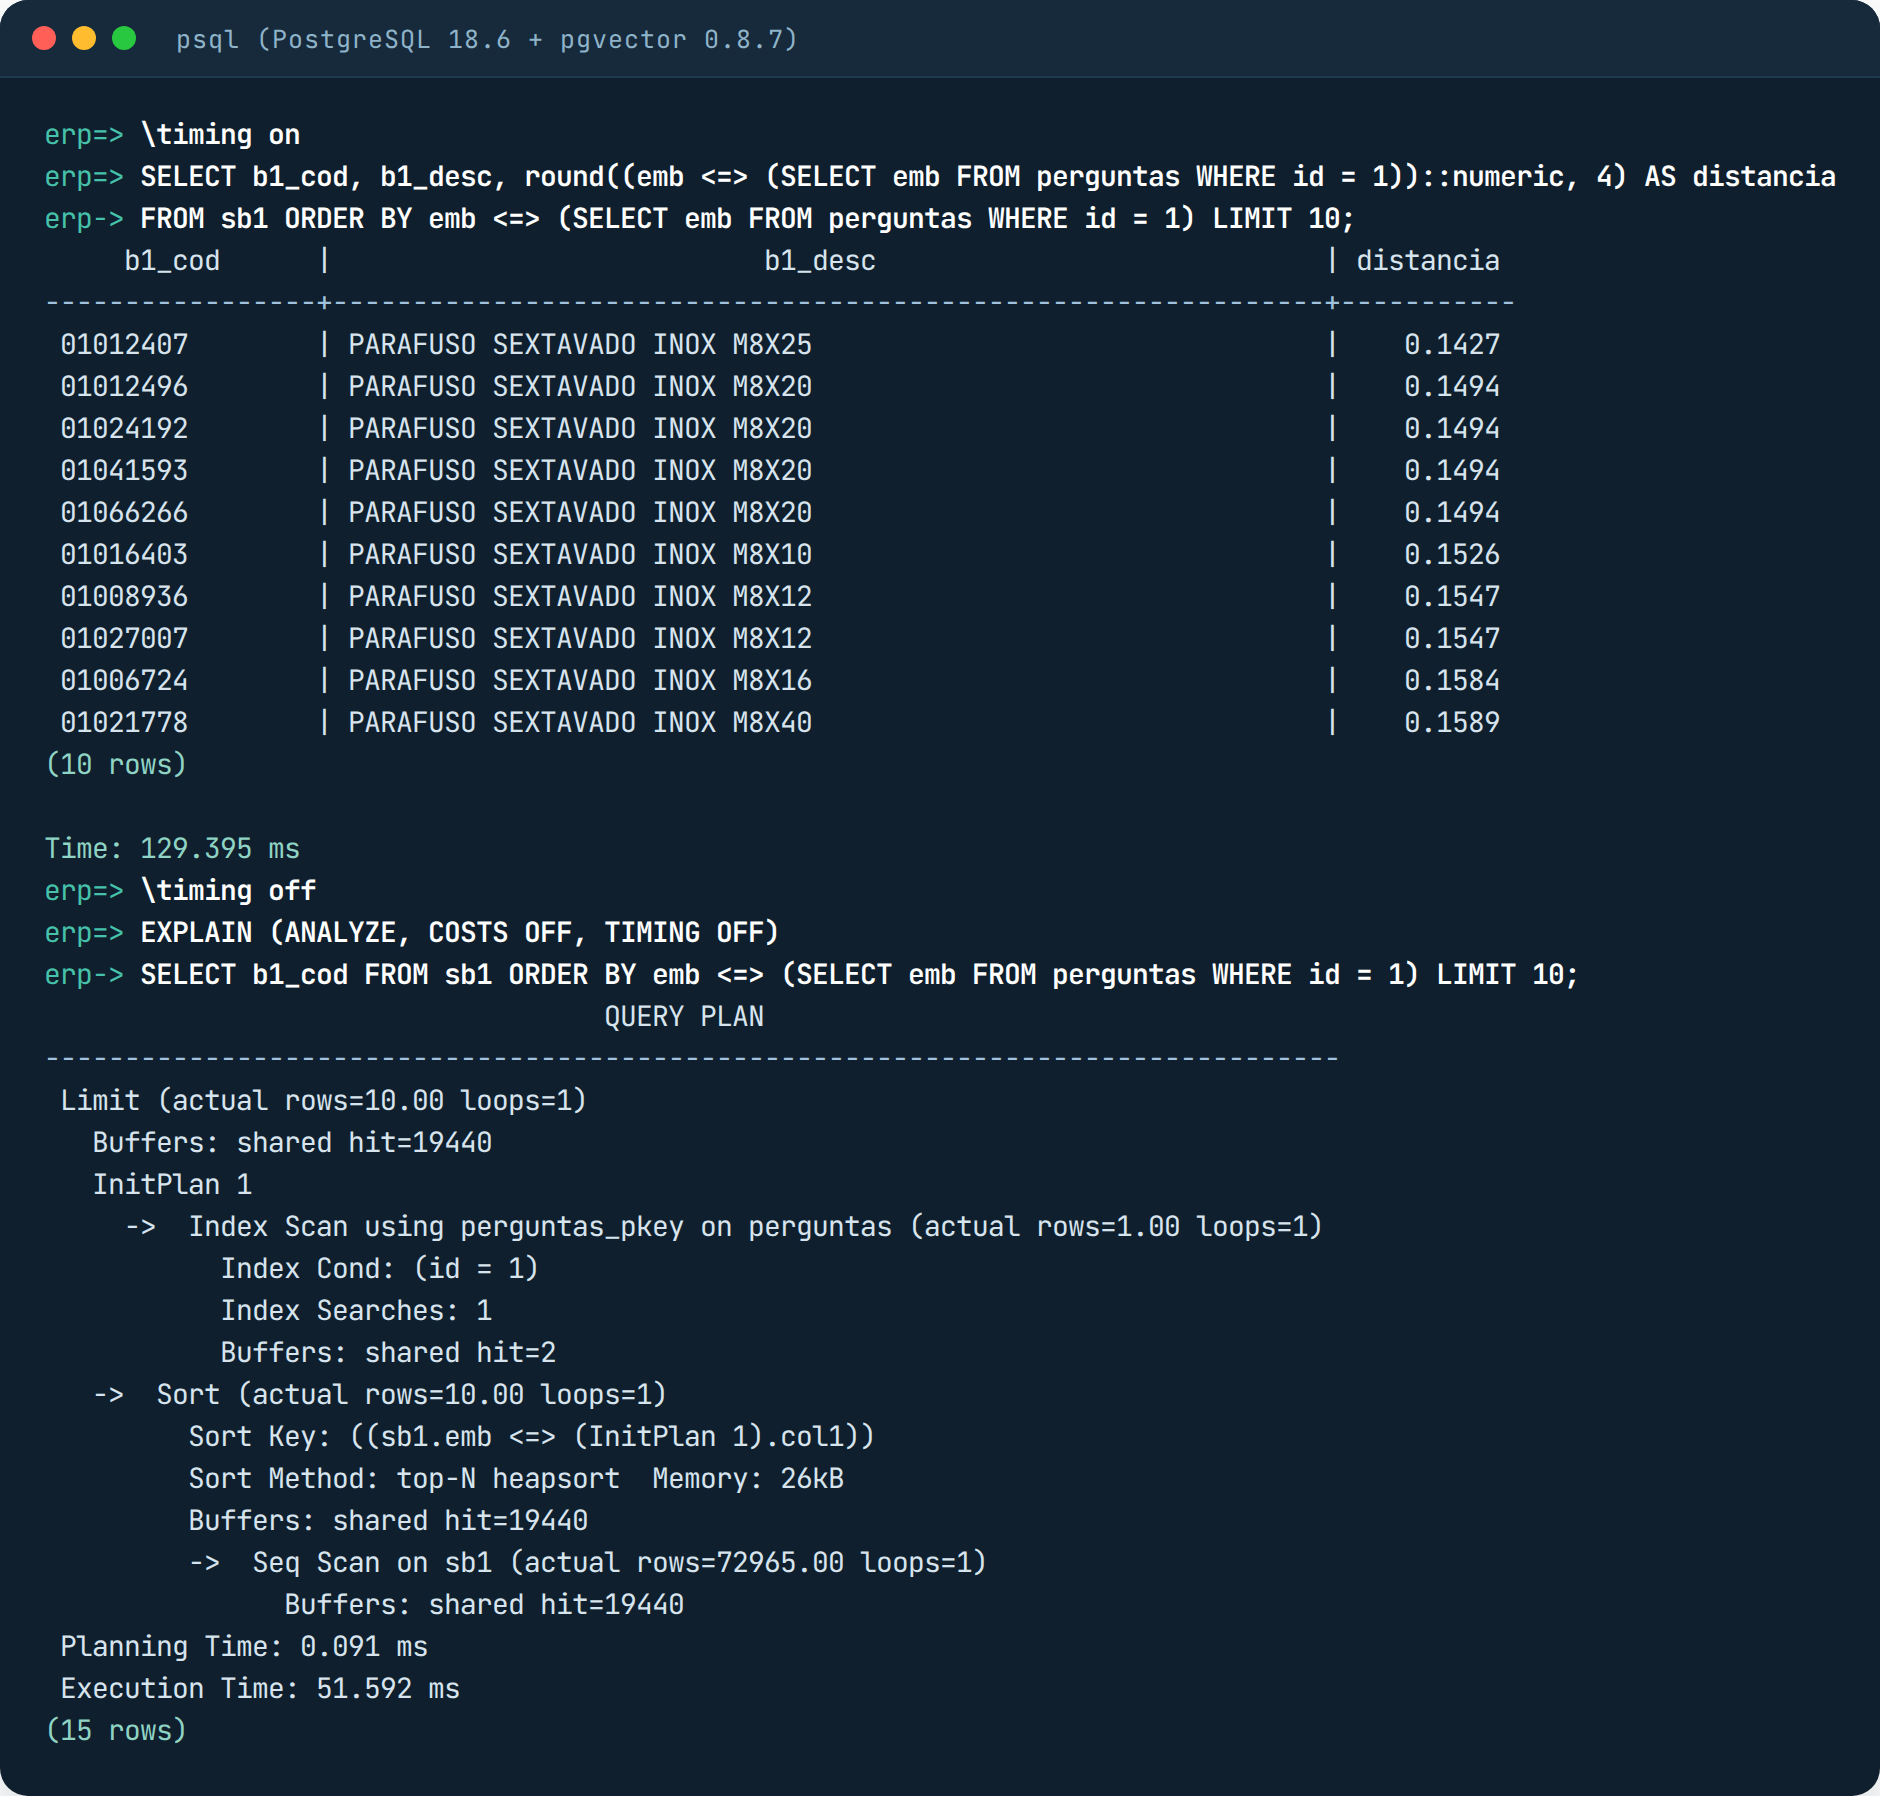
Sem índice nenhum a busca já funciona. O operador <=> calcula a distância entre dois vetores, então ORDER BY emb <=> vetor LIMIT 10 é “me dá os 10 mais perto”. Devolveu os parafusos sextavados inox M8 em 50 ms. No print, embaixo do resultado, está o plano: Seq Scan on sb1, ou seja, leu as 72.965 linhas, e Buffers: shared hit=19440, que são os blocos de disco que ele passou pra fazer isso. Guarde esse número.
Aí fui criar o índice HNSW e tomei o primeiro erro do dia:
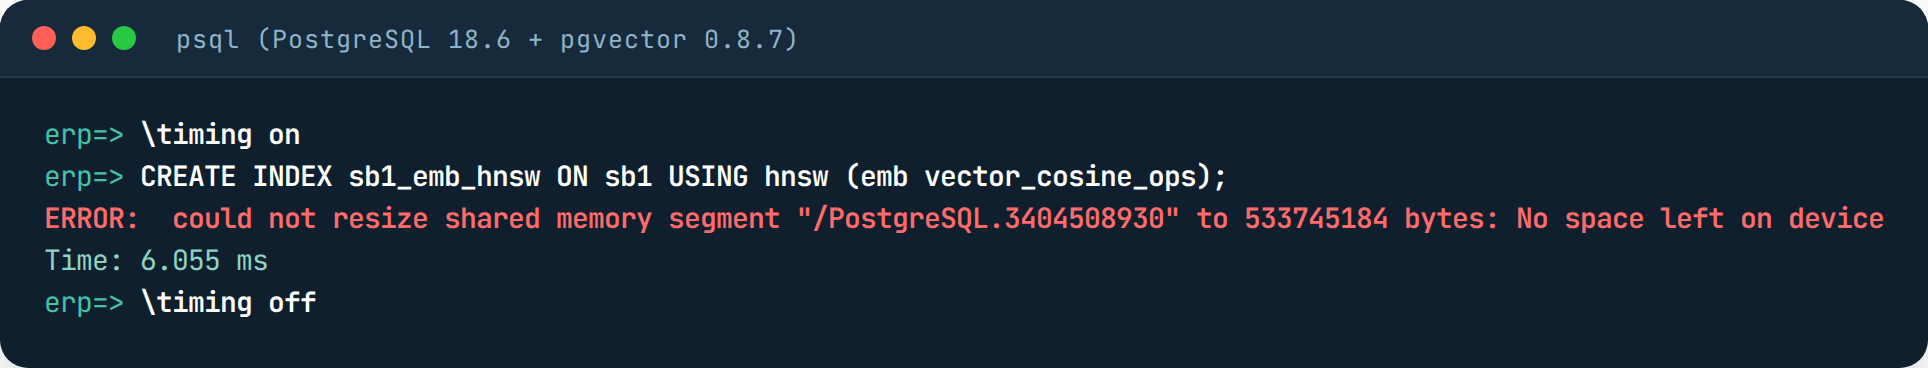
Esse erro não é do pgvector, é do Docker. O container vem com uma área de memória compartilhada (/dev/shm) de só 64 MB, e a montagem do índice pede mais que isso pra trabalhar em paralelo. Subi o container de novo com –shm-size=1g:
docker run -d --name pgvec --memory=2g --shm-size=1g -e POSTGRES_PASSWORD=lab \
  -p 55432:5432 -v /lab:/lab pgvector/pgvector:pg18 \
  -c shared_buffers=512MB -c maintenance_work_mem=512MB -c max_parallel_maintenance_workers=2

CREATE INDEX sb1_emb_hnsw ON sb1 USING hnsw (emb vector_cosine_ops);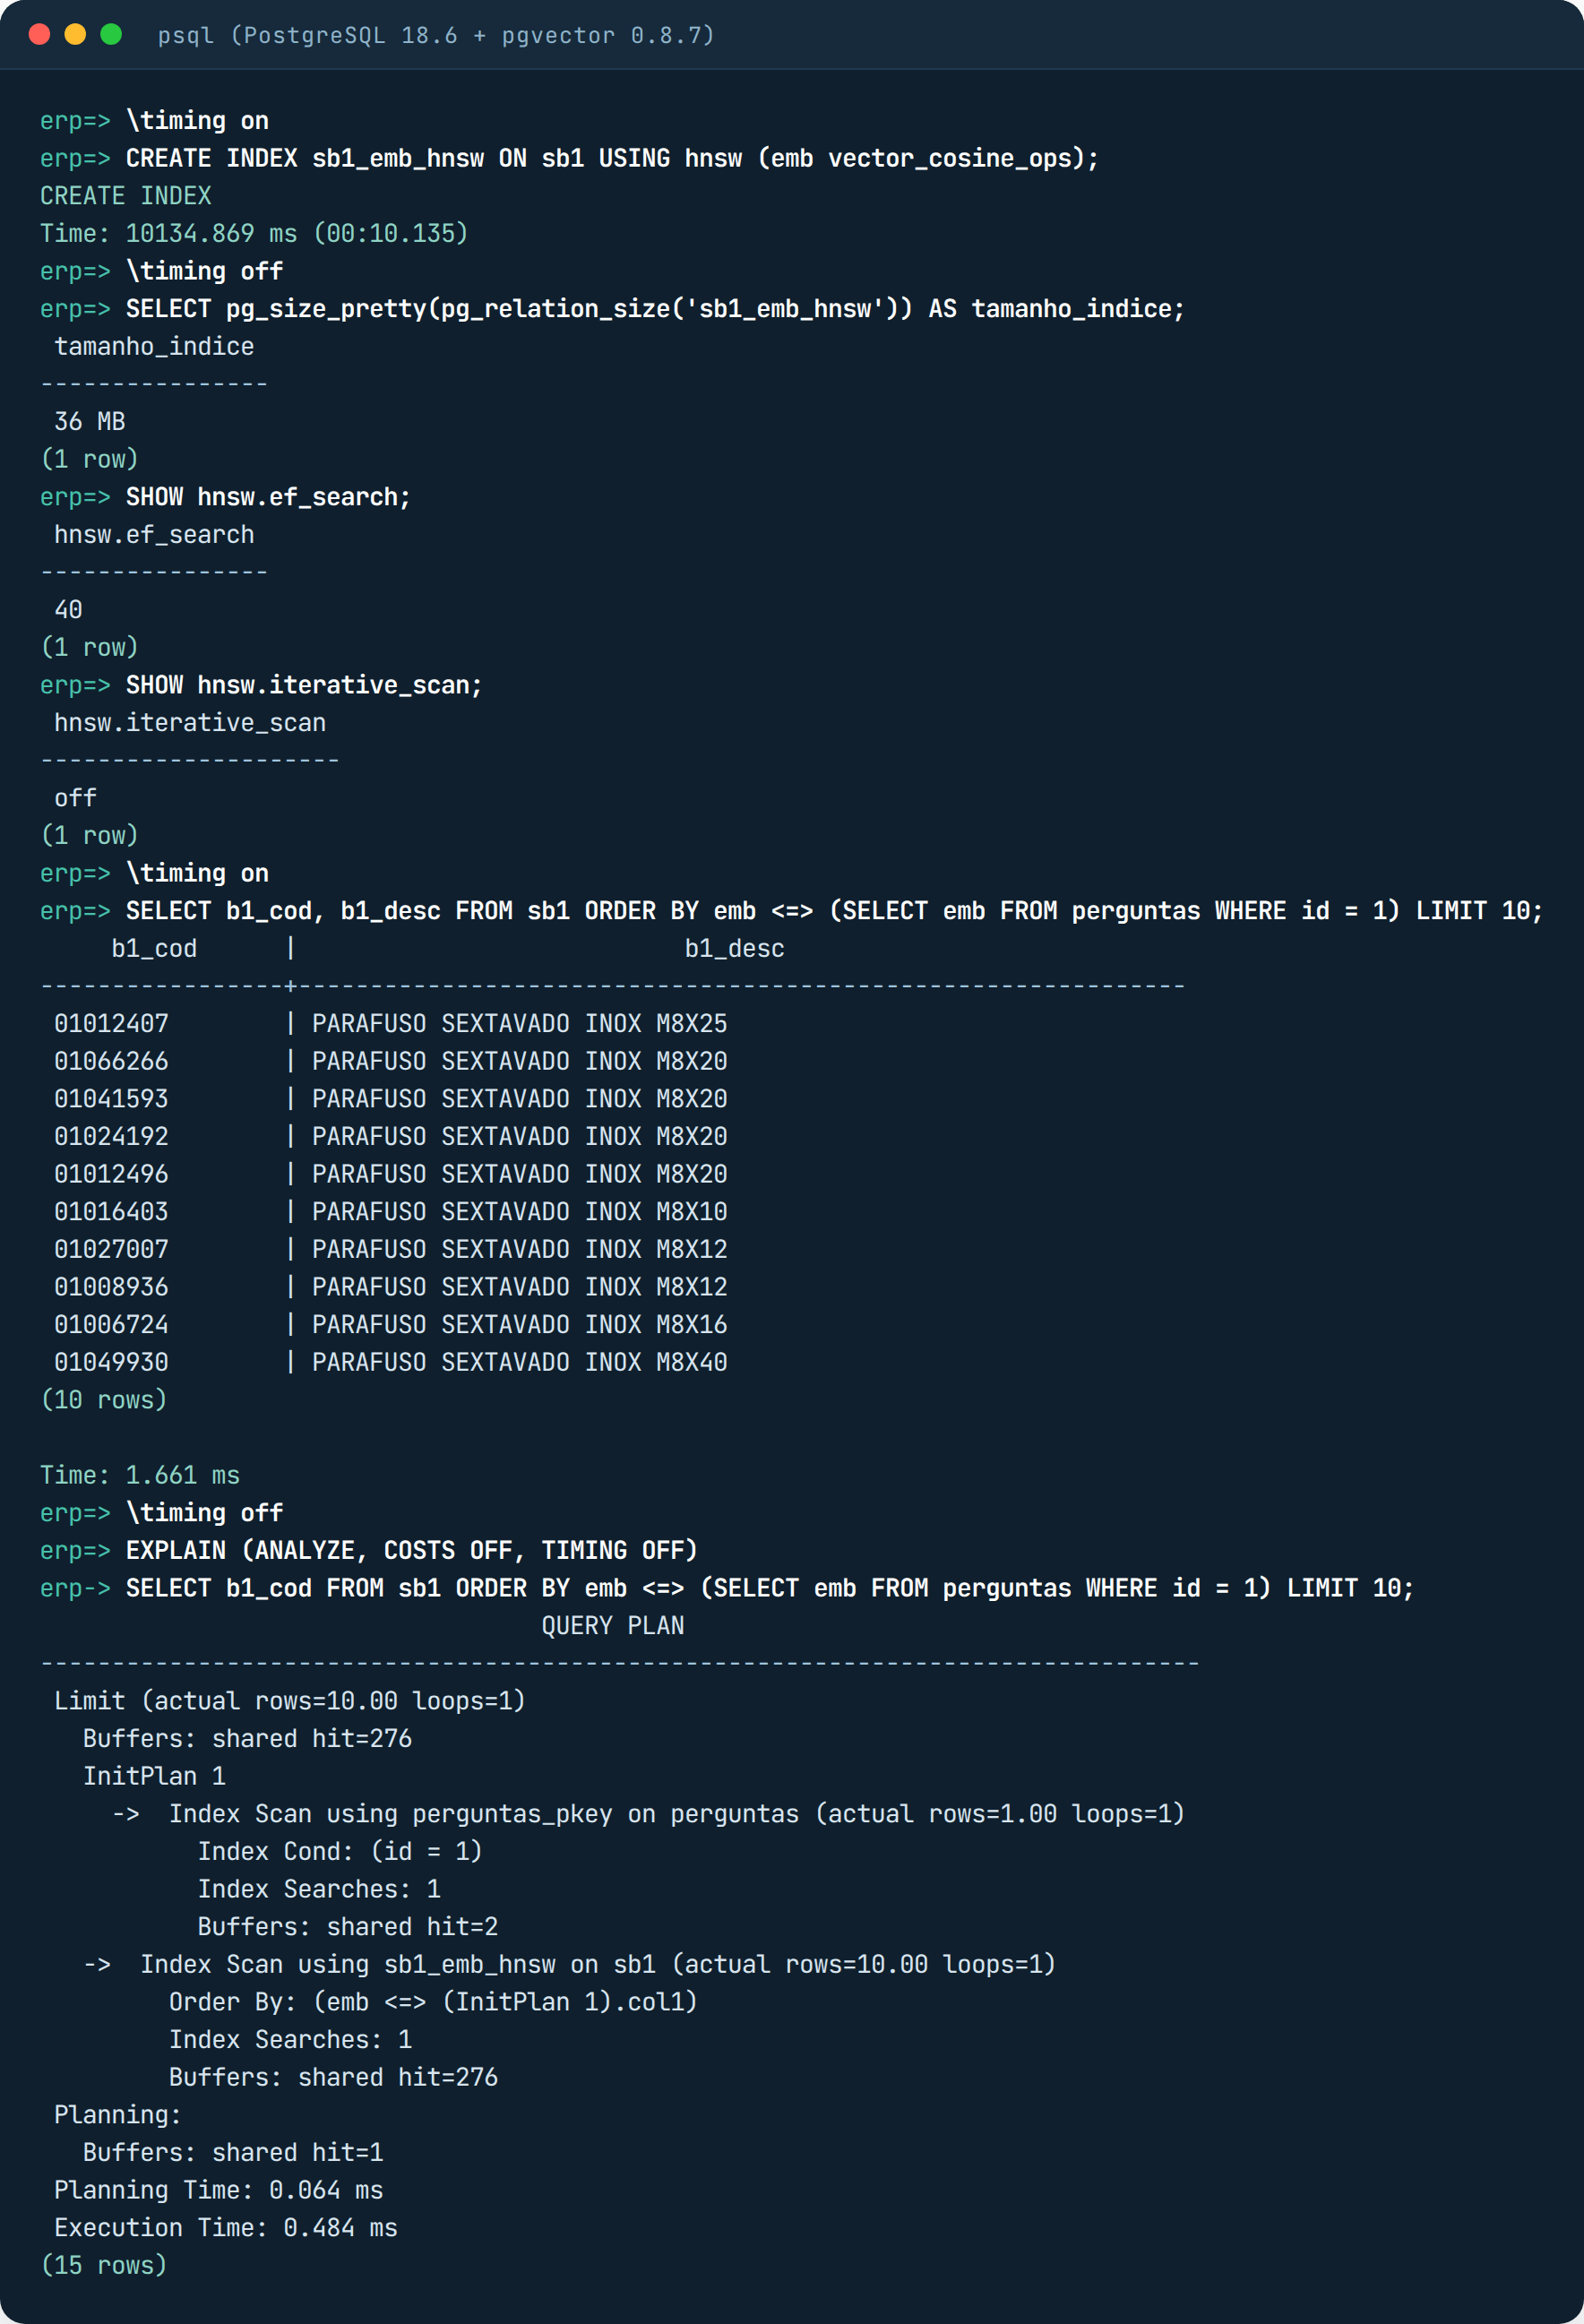
Índice pronto em 10 segundos, 36 MB. Olha o plano agora: Index Scan using sb1_emb_hnsw, e os blocos caíram de 19.440 pra 276. A mesma consulta passou de 50 ms para 0,6 ms. Só que o recall ficou em 75,6%, com o ef_search no padrão de 40. Subindo pra 100 vai a 84%, com 200 vai a 91%, com 400 vai a 94,5% e a consulta ainda fica em 2 ms. Tem outro motivo pro recall baixo no padrão: cadastro de ERP tem muita descrição repetida, e vetor repetido atrapalha a rede de vizinhos do HNSW.
Agora o que importa de verdade: filtro. Nenhum SQL de Protheus roda sem WHERE D_E_L_E_T_ = ‘ ‘ (só registro não apagado), e quase sempre tem grupo, filial, tipo junto. Pedi “correia dentada” dentro do grupo 0020, que é o grupo de correias e transmissão e tem 207 correias dentadas cadastradas:
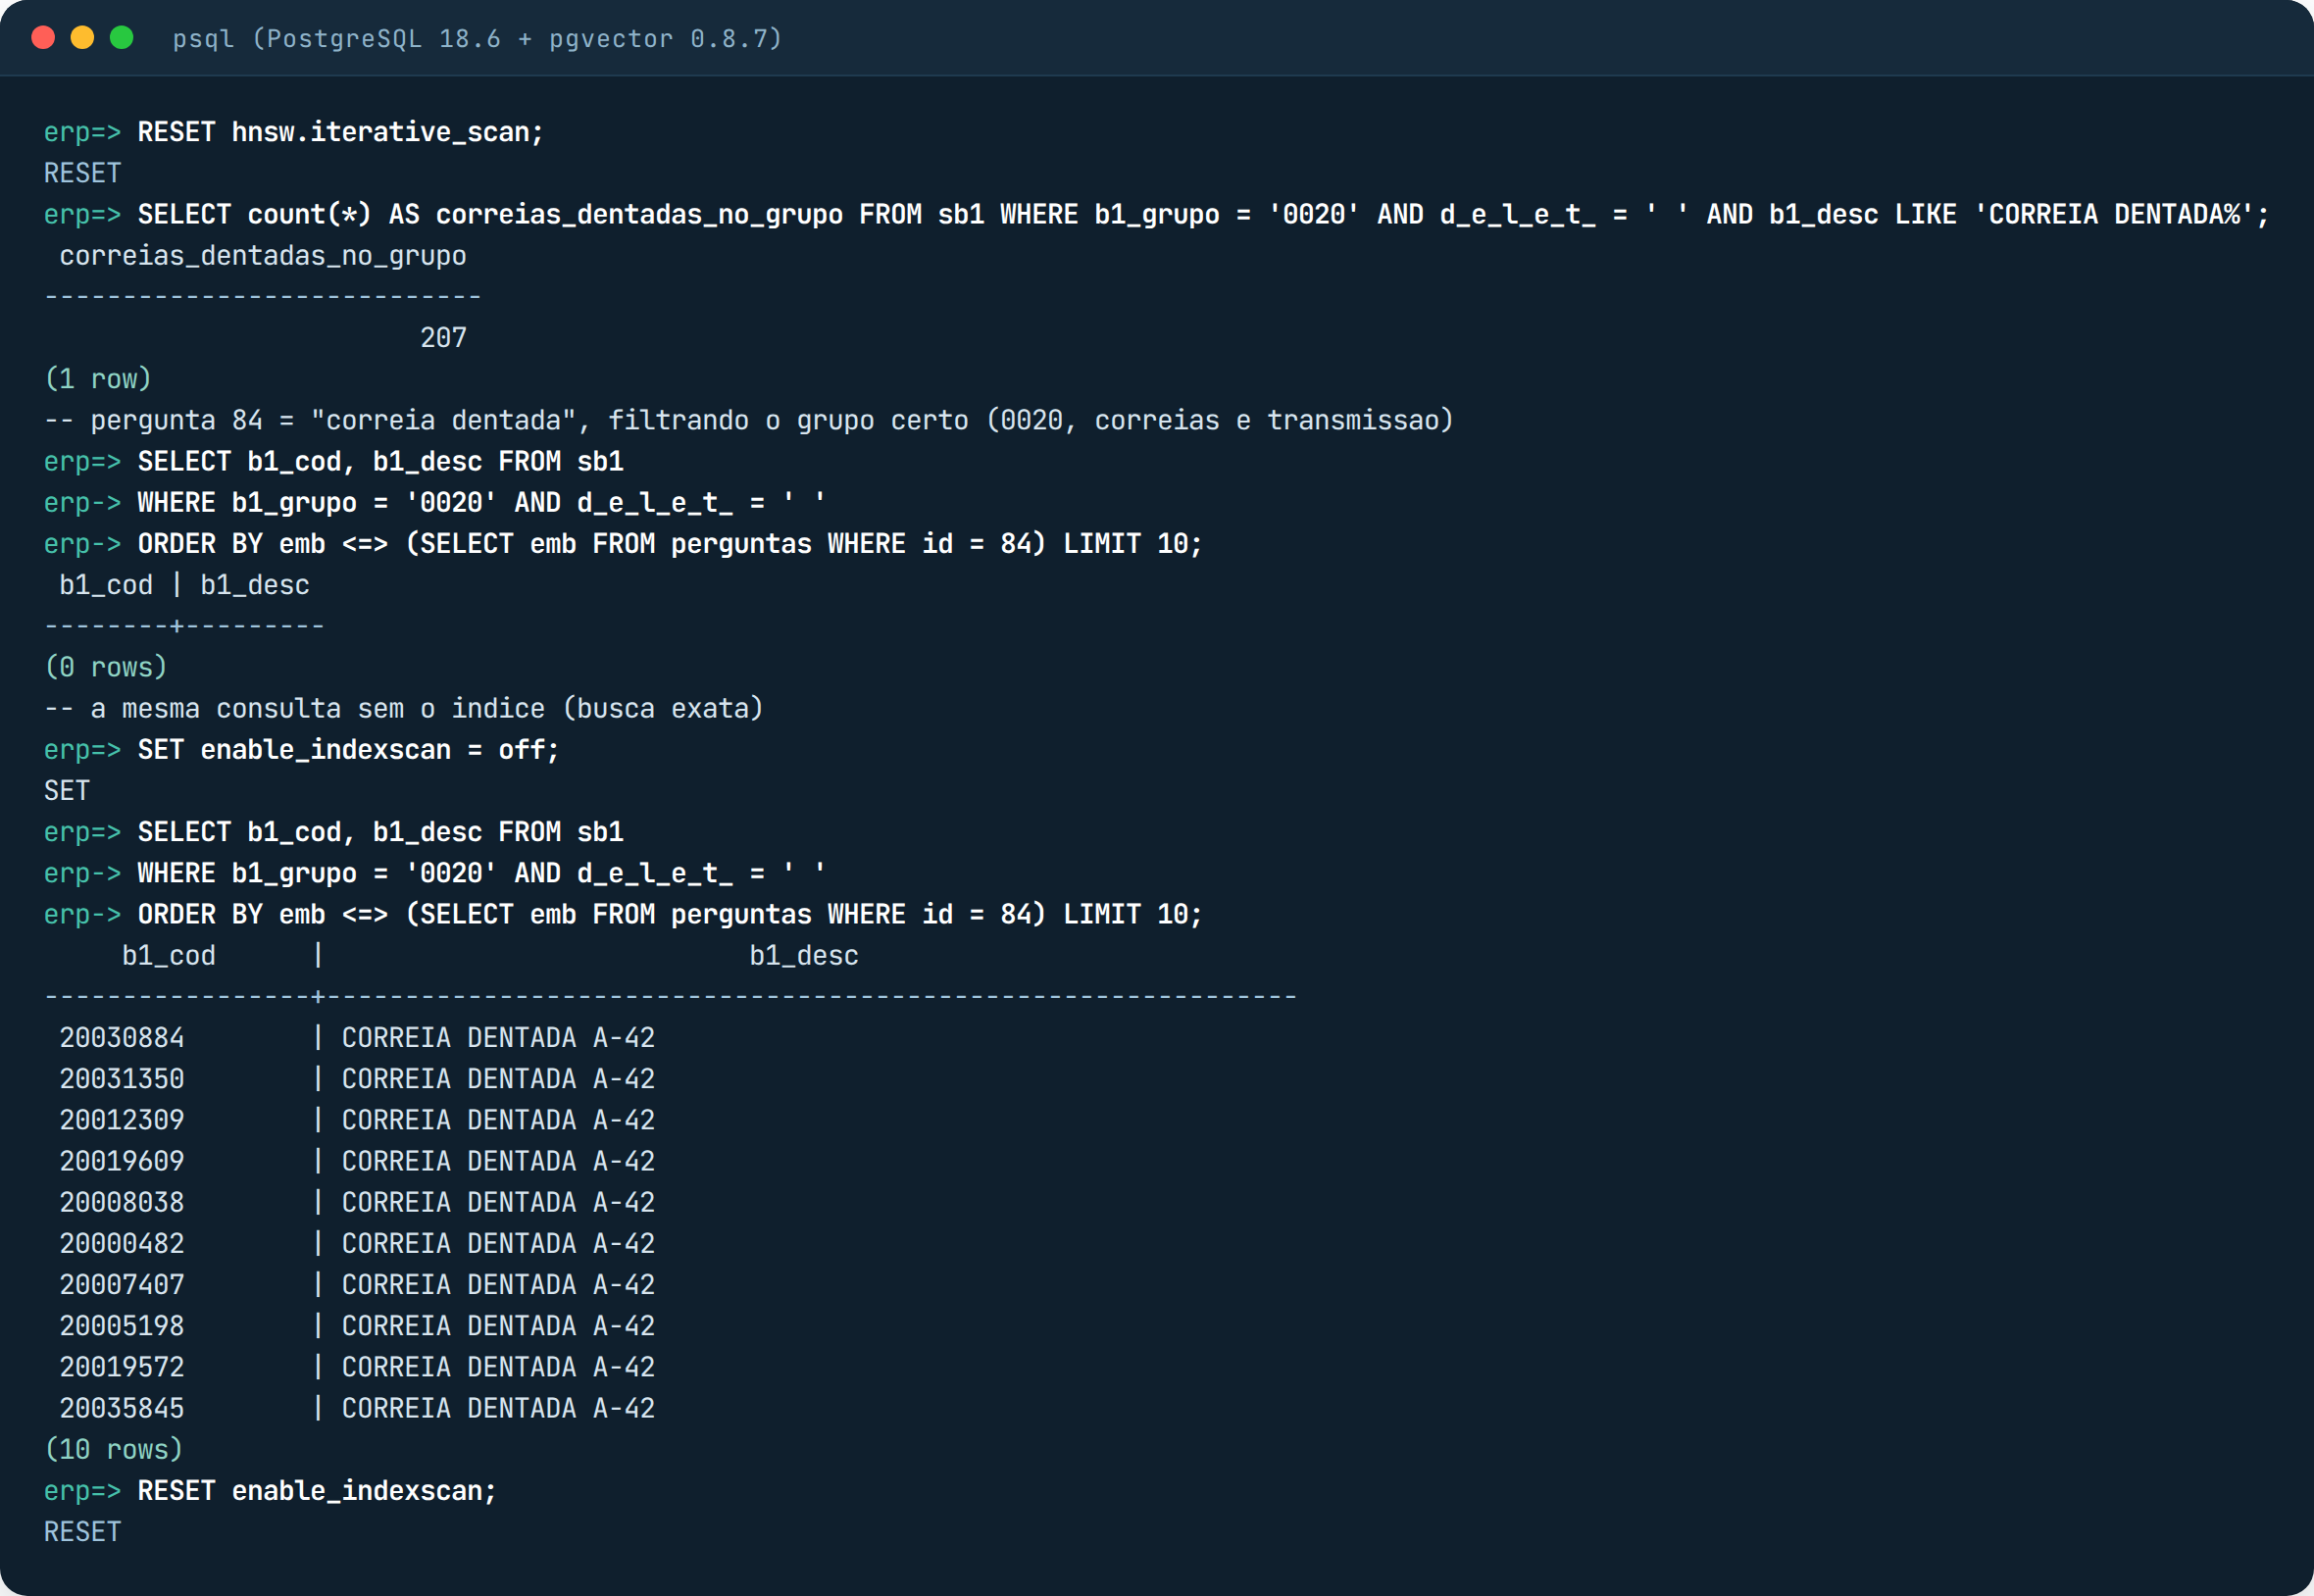
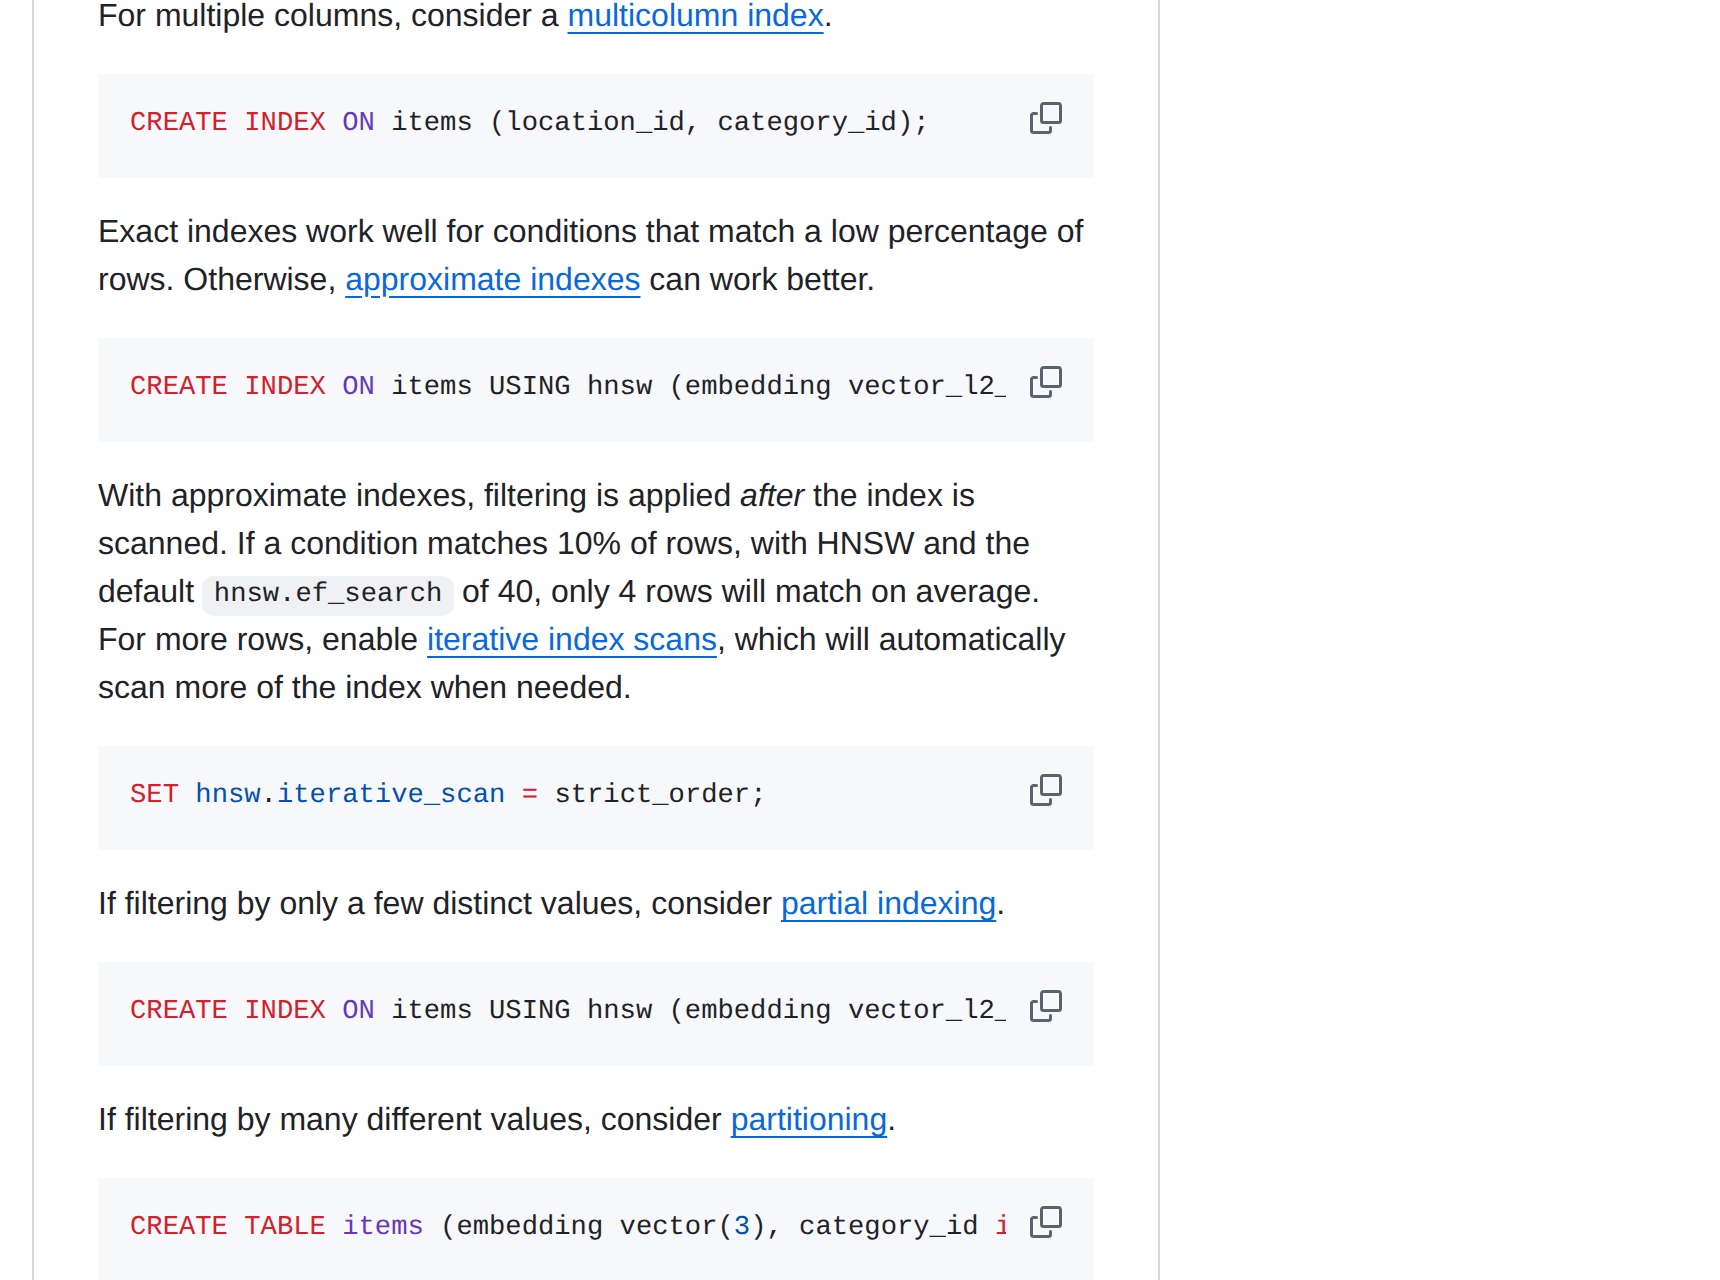
Zero linhas. Sem erro, sem aviso. A busca completa, na mesma consulta, devolve 10 correias dentadas. O que aconteceu: o HNSW separou os 40 candidatos mais parecidos com “correia dentada” na tabela inteira, e só depois o PostgreSQL aplicou o WHERE. Nenhum dos 40 era do grupo 0020 e não apagado, então sobrou nada. Pra quem está na tela do sistema, parece que não existe correia dentada no cadastro. A própria documentação do pgvector descreve isso:
A correção existe desde a versão 0.8.0 e vem desligada: o iterative scan. Com SET hnsw.iterative_scan = relaxed_order, o banco continua andando no mapa até juntar 10 produtos que passam no filtro, em vez de parar nos primeiros 40.
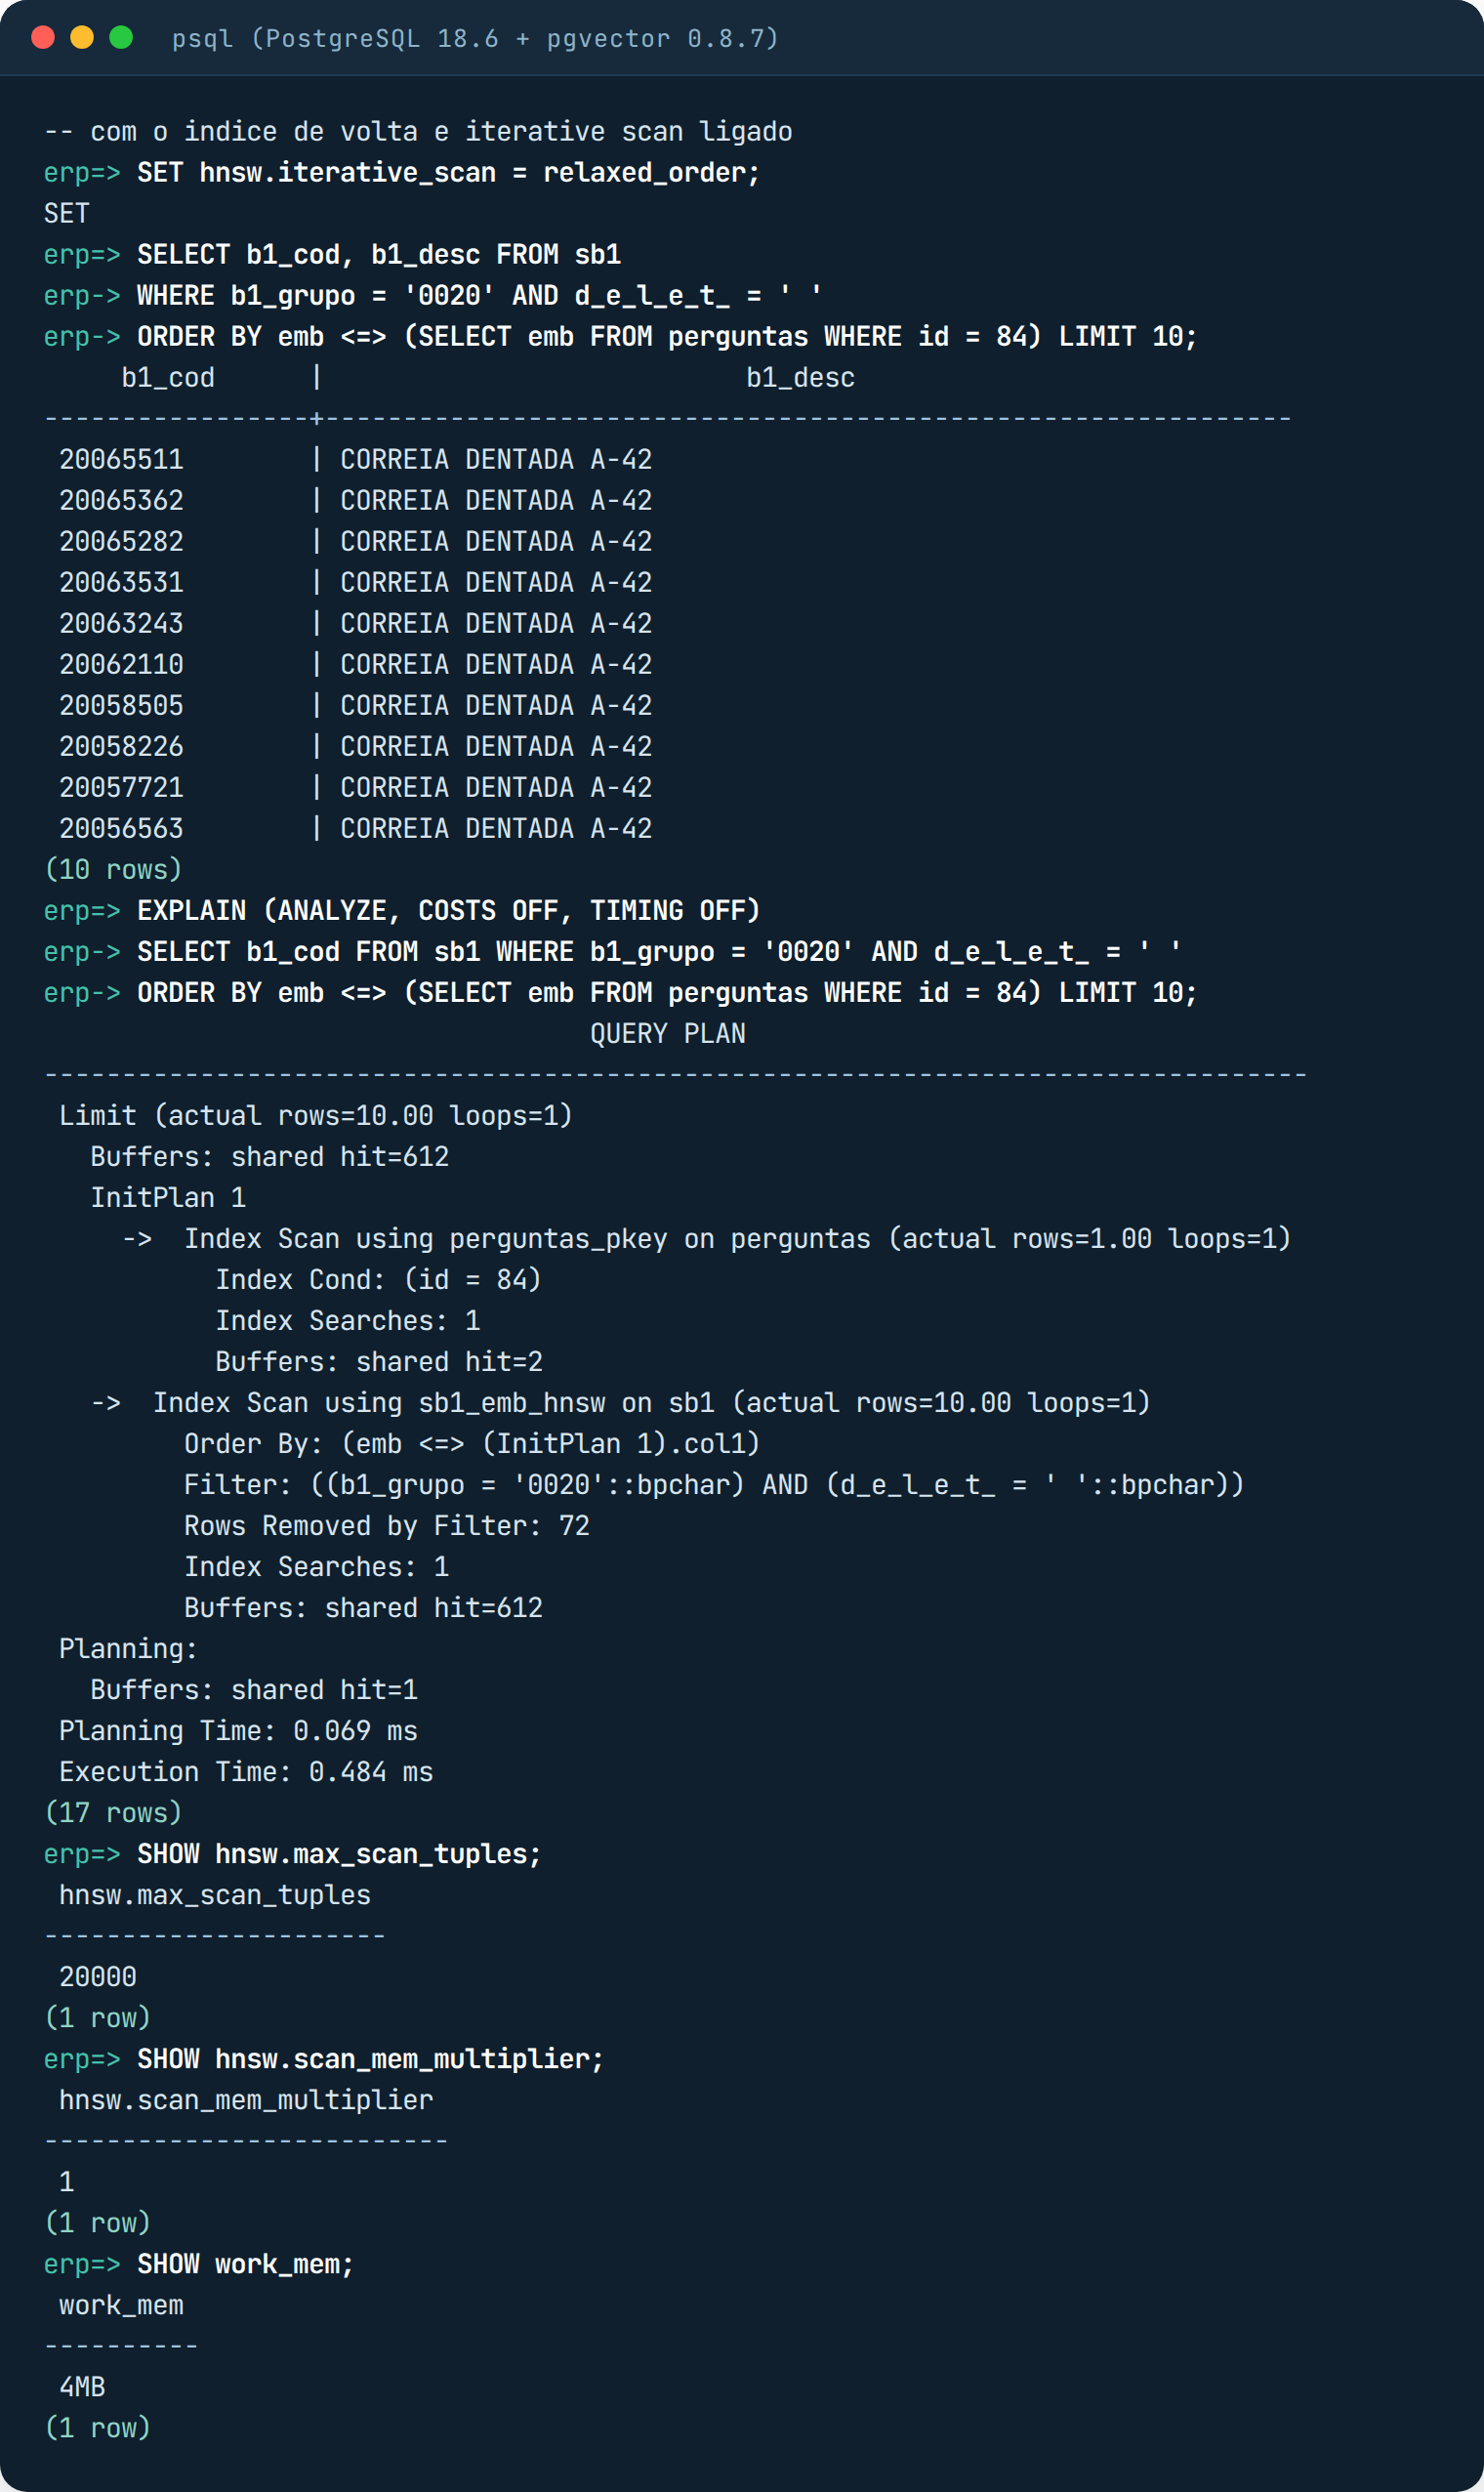
Nas 100 perguntas com esse filtro, a média de linhas devolvidas foi de 0,3 com o padrão (ou seja, quase sempre vazio), 9,2 com strict_order e 9,3 com relaxed_order, este com recall de 91% e 12 ms por pergunta. Sete perguntas continuaram em zero mesmo com os limites bem mais altos; são perguntas que não tem nada a ver com o grupo (“cabo de rede”, “graxa”), mas a busca completa devolve 10 mesmo assim. Nunca vi um ambiente ligar o iterative_scan antes de passar por esse susto.
Oracle 26ai AI Vector Search: o vetor nasce dentro do banco, mas a memória não vem pronta
Imagem completa do Oracle AI Database 26ai Free em container, nada pra instalar. A coluna é do tipo VECTOR(384, FLOAT32): 384 números, cada um guardado com 4 bytes. O DESC mostra DENSE, que quer dizer que todos os 384 números são gravados.
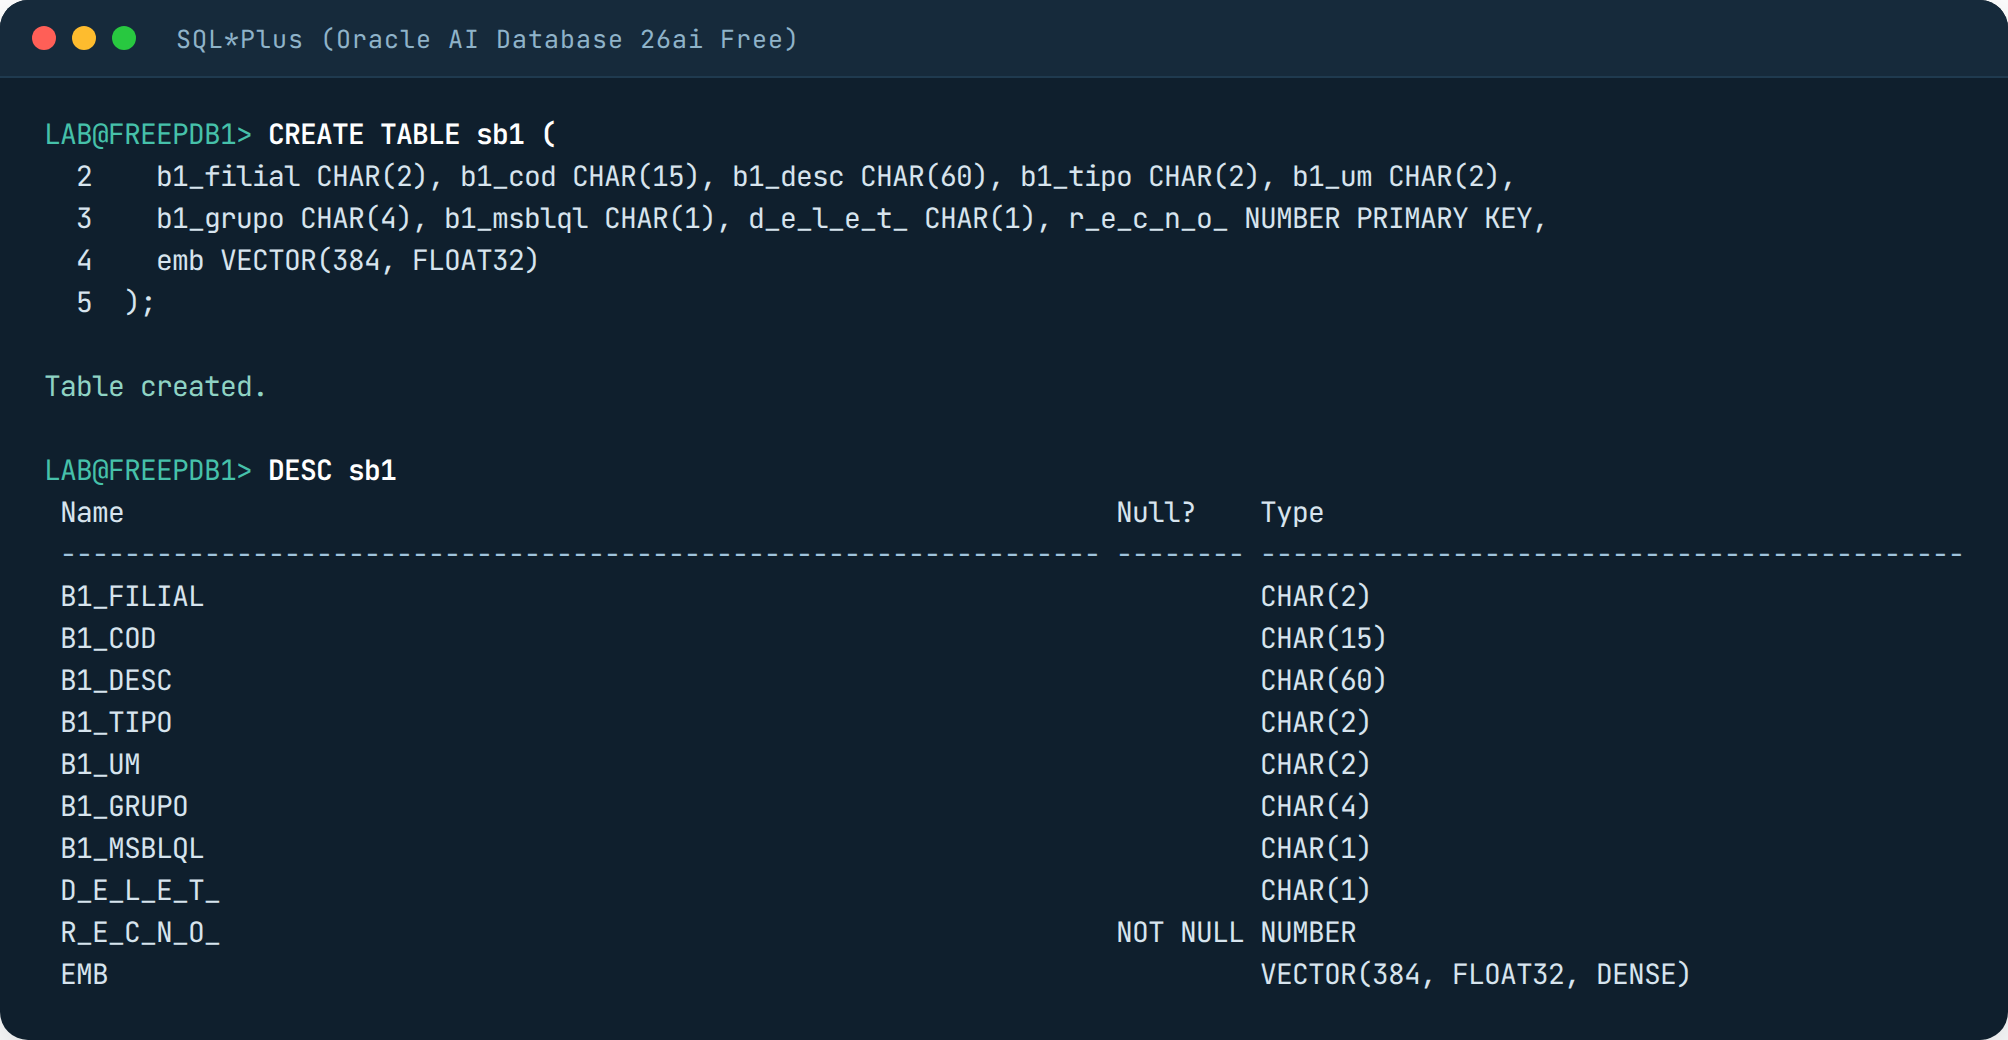
Carreguei os mesmos vetores do arquivo com um script Python (python-oracledb), usando TO_VECTOR pra converter o texto em vetor: 18 segundos, 144 MB. Primeira bobagem minha: COUNT(emb) numa coluna VECTOR dá ORA-22849, o COUNT não aceita esse tipo; conta com IS NOT NULL. A busca completa, com VECTOR_DISTANCE, devolveu os mesmos 10 parafusos que o PostgreSQL.
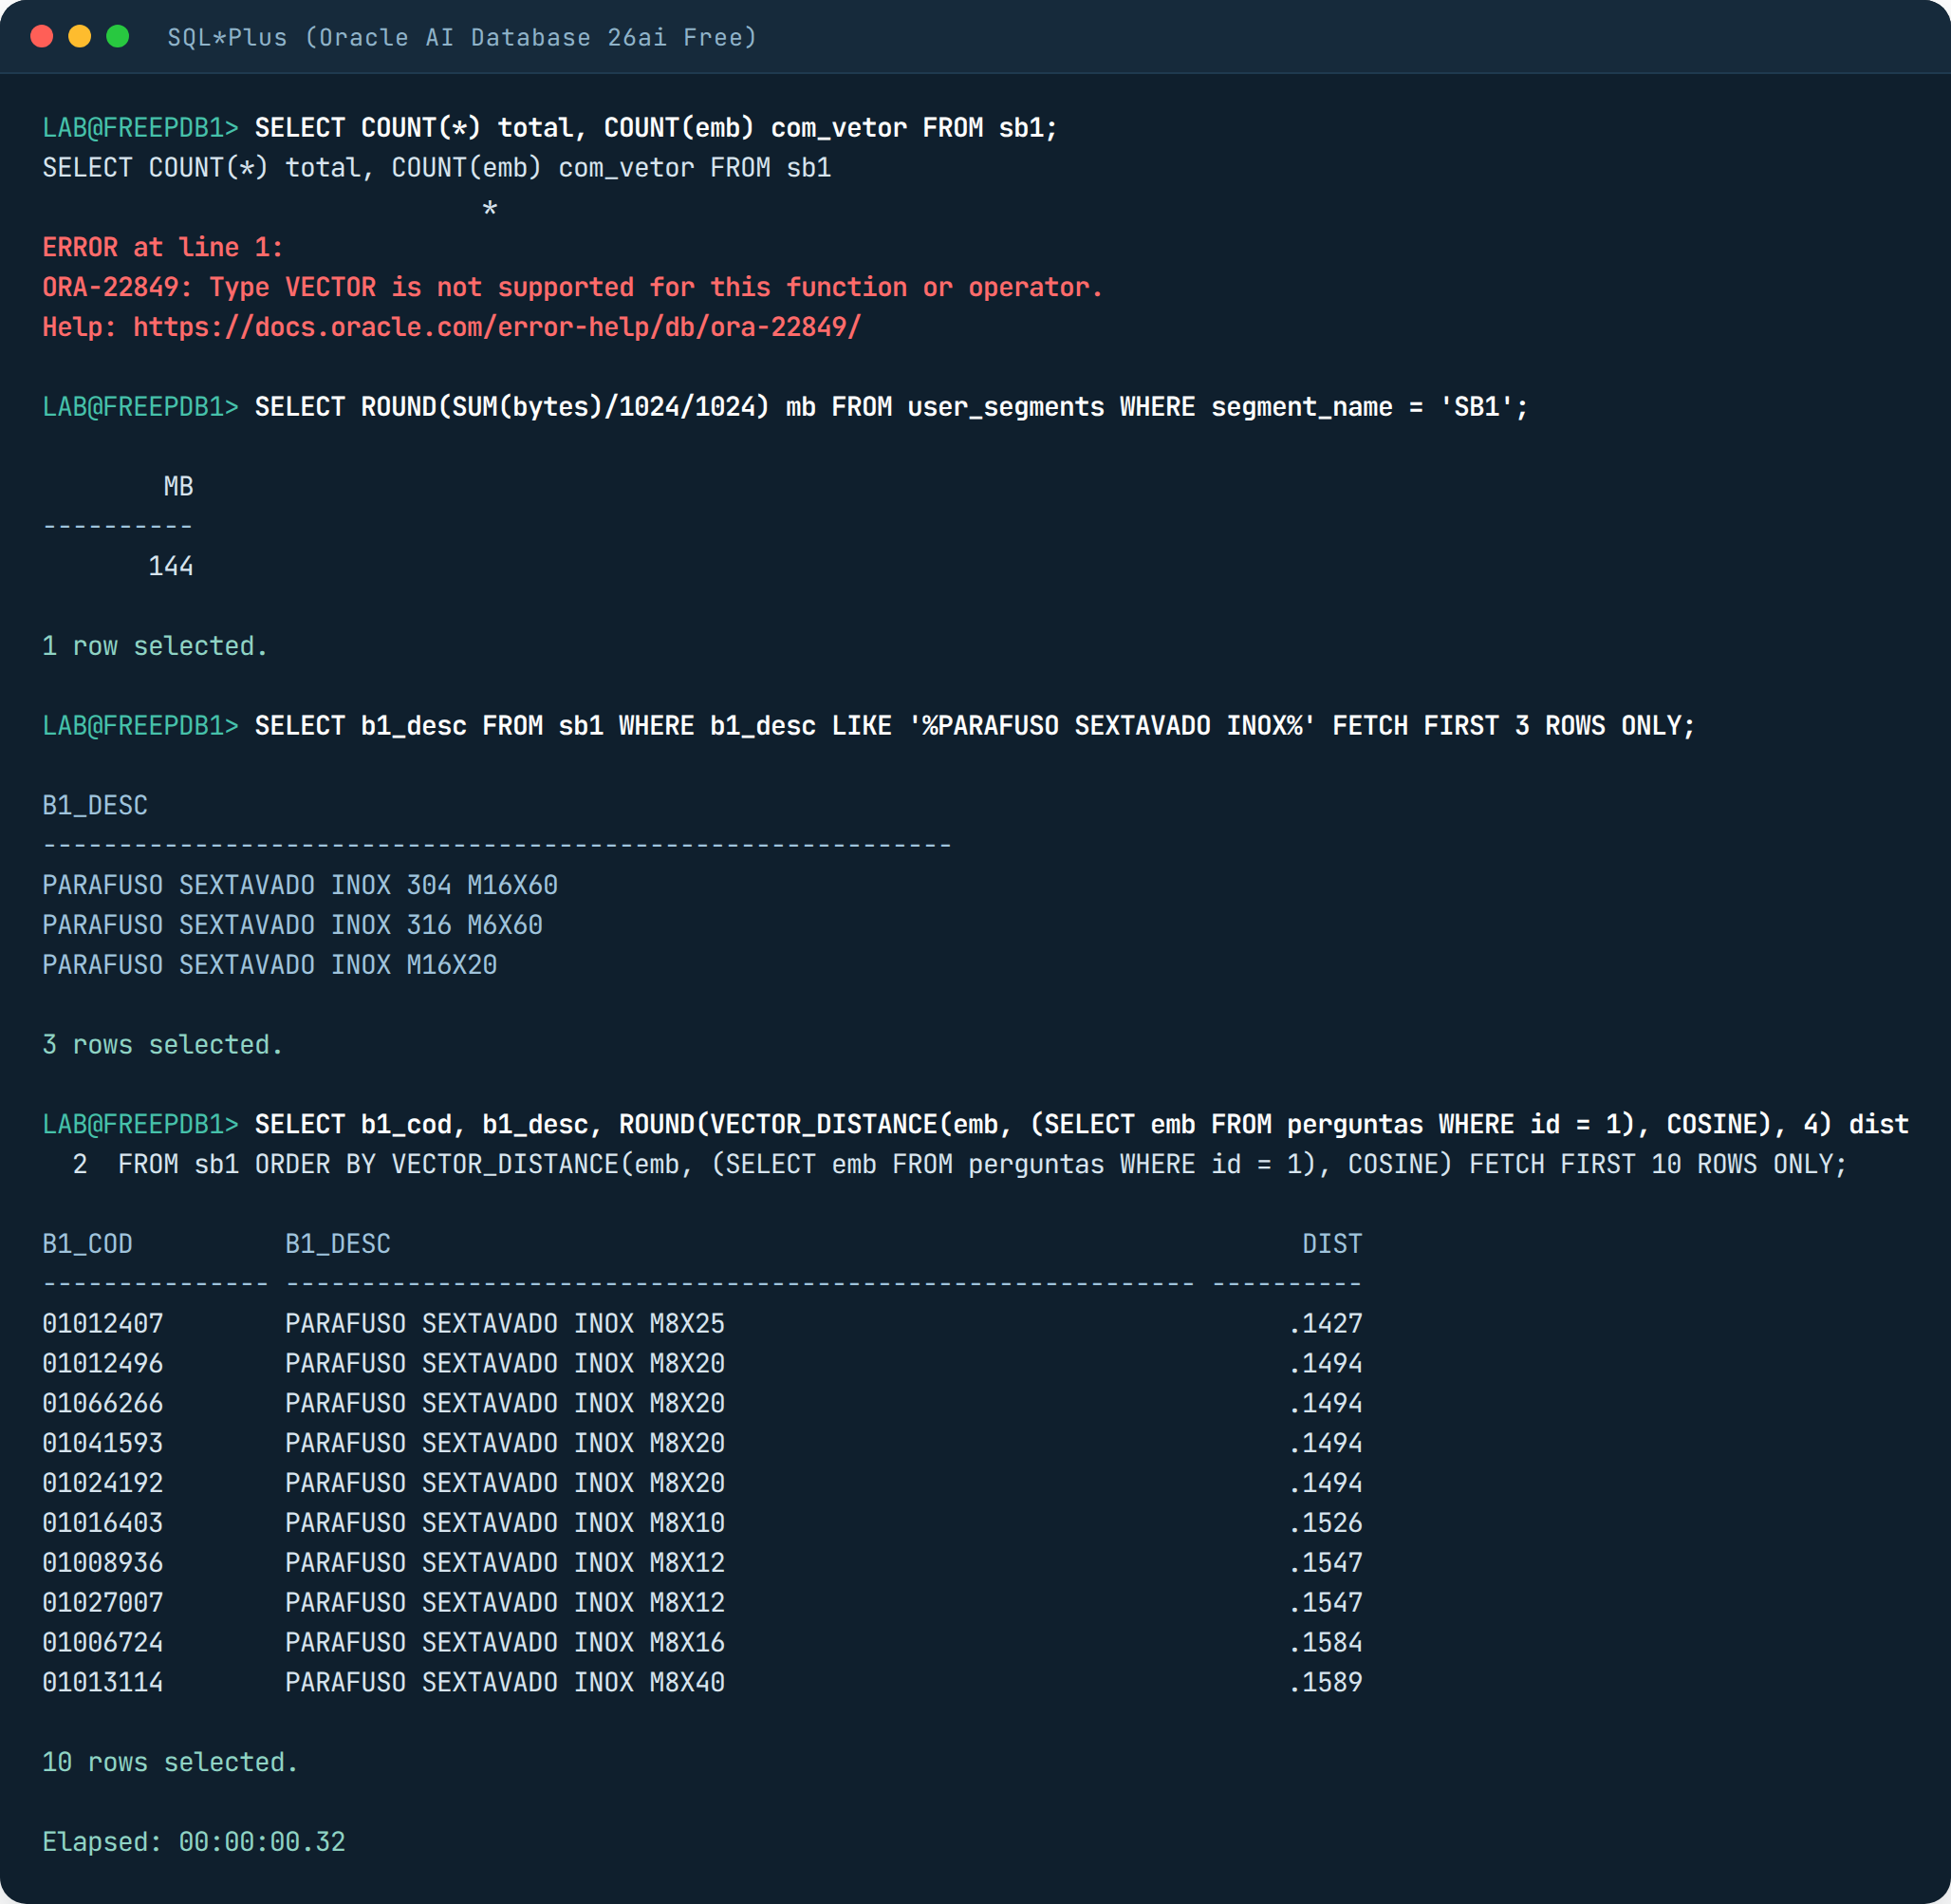
Medindo as 100 perguntas, a busca completa deu 200 ms por pergunta, quatro vezes o PostgreSQL na mesma máquina.
O índice HNSW na Oracle mora na memória RAM, num pedaço reservado chamado vector pool. Na Free esse pedaço vem com tamanho zero, e sem ele não dá pra criar o índice:
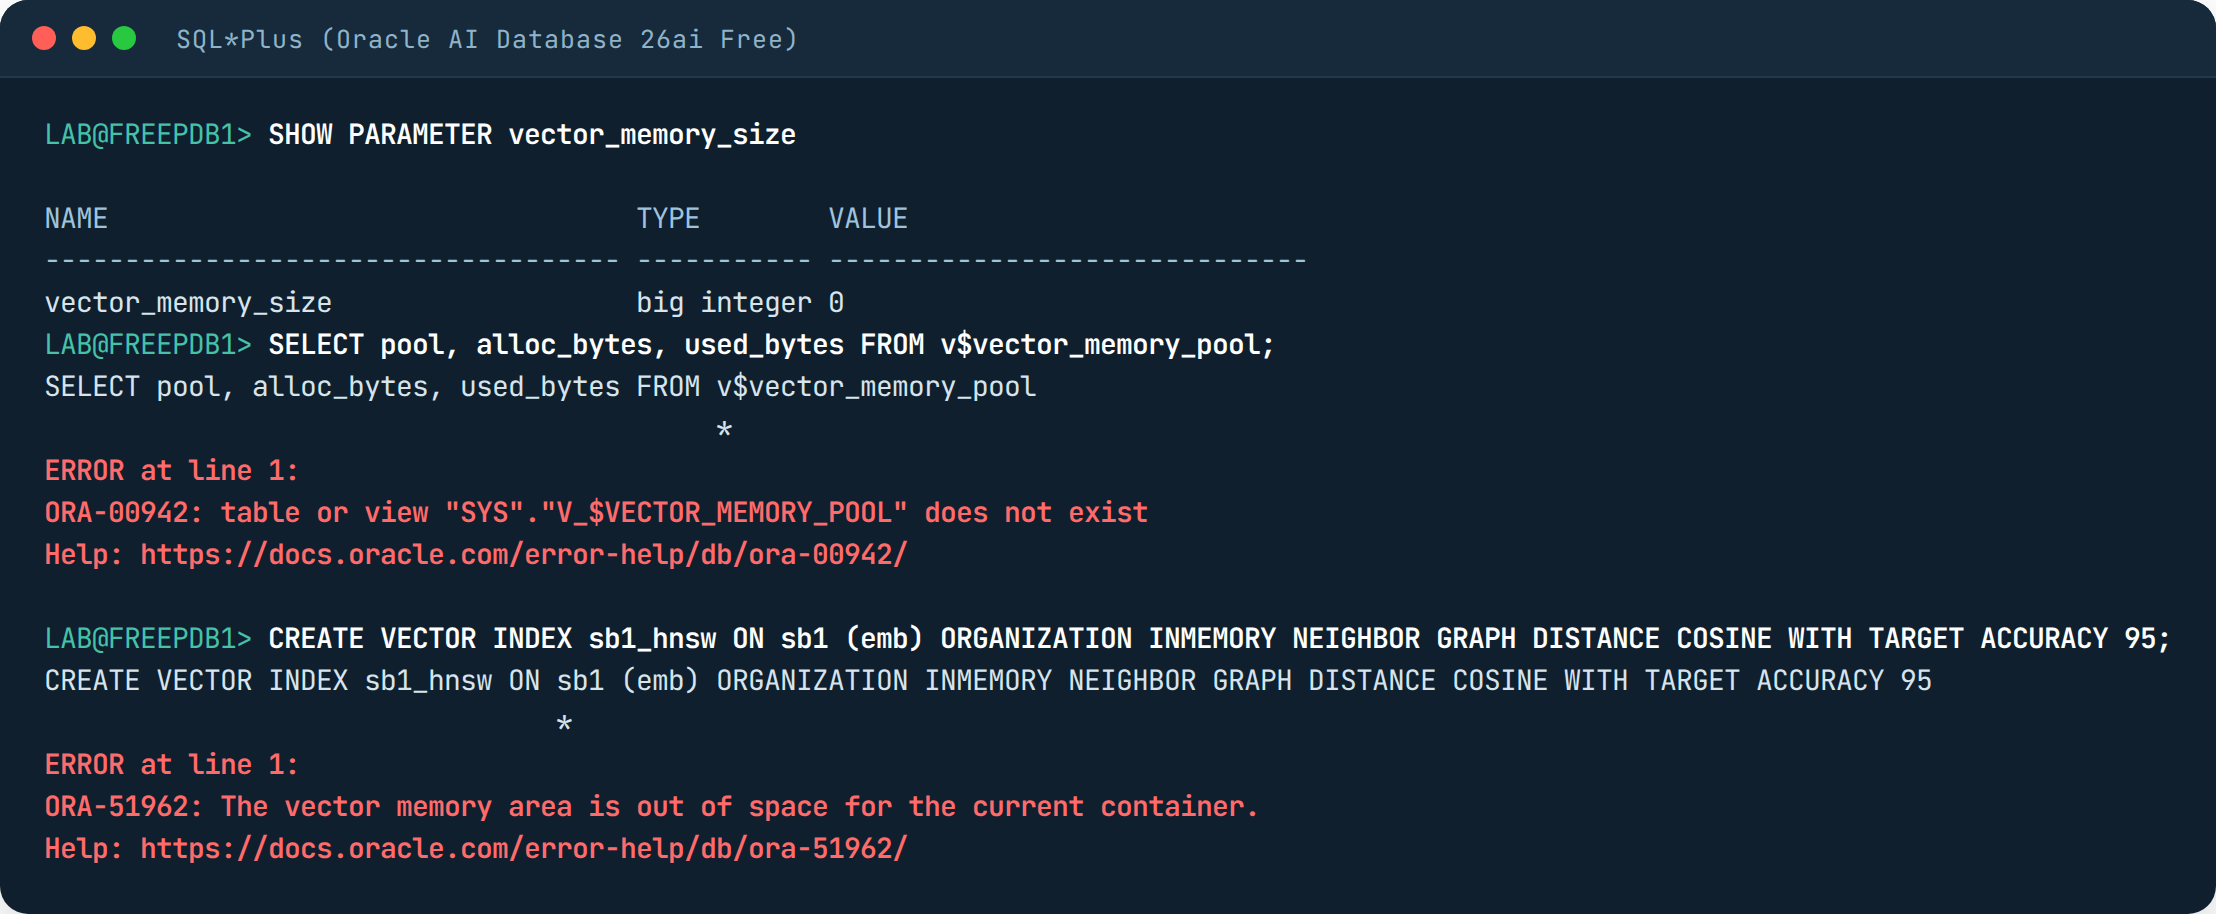
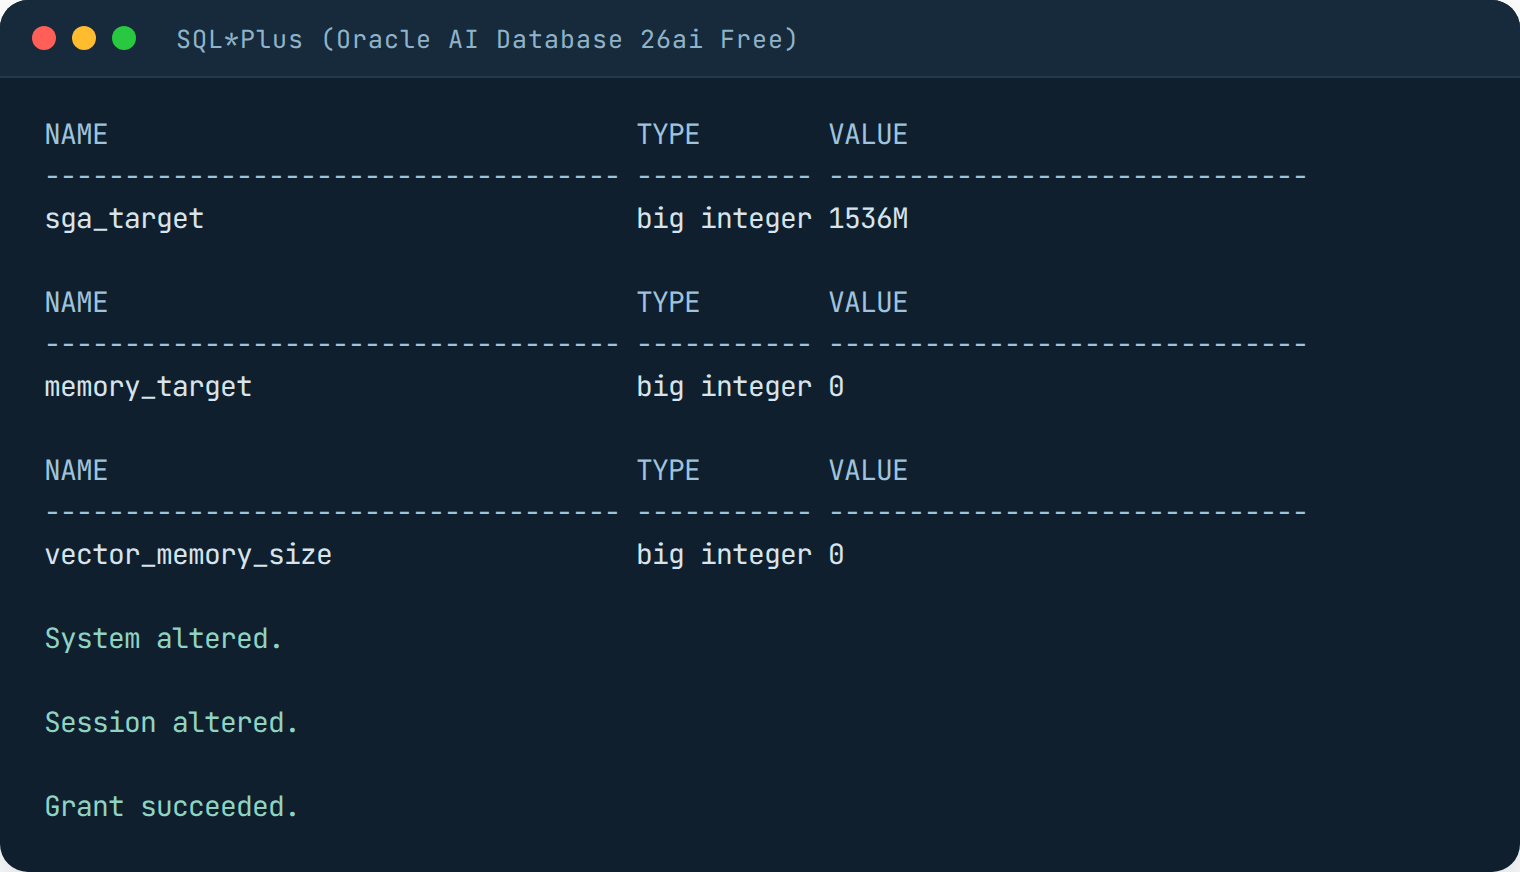
O ajuste é no banco raiz (o CDB), como usuário SYS, e só vale depois de reiniciar. A memória total do banco na Free (sga_target) é 1536M, então reservar 512M pro pool cabe. Reiniciar o container levou 25 segundos.
Com o pool de pé o índice saiu, mas demorou 1 minuto e 47 segundos (o pgvector fez em 10 segundos) e ocupou 131 MB do pool. Como ele vive na memória, se o banco reiniciar ele é montado de novo.
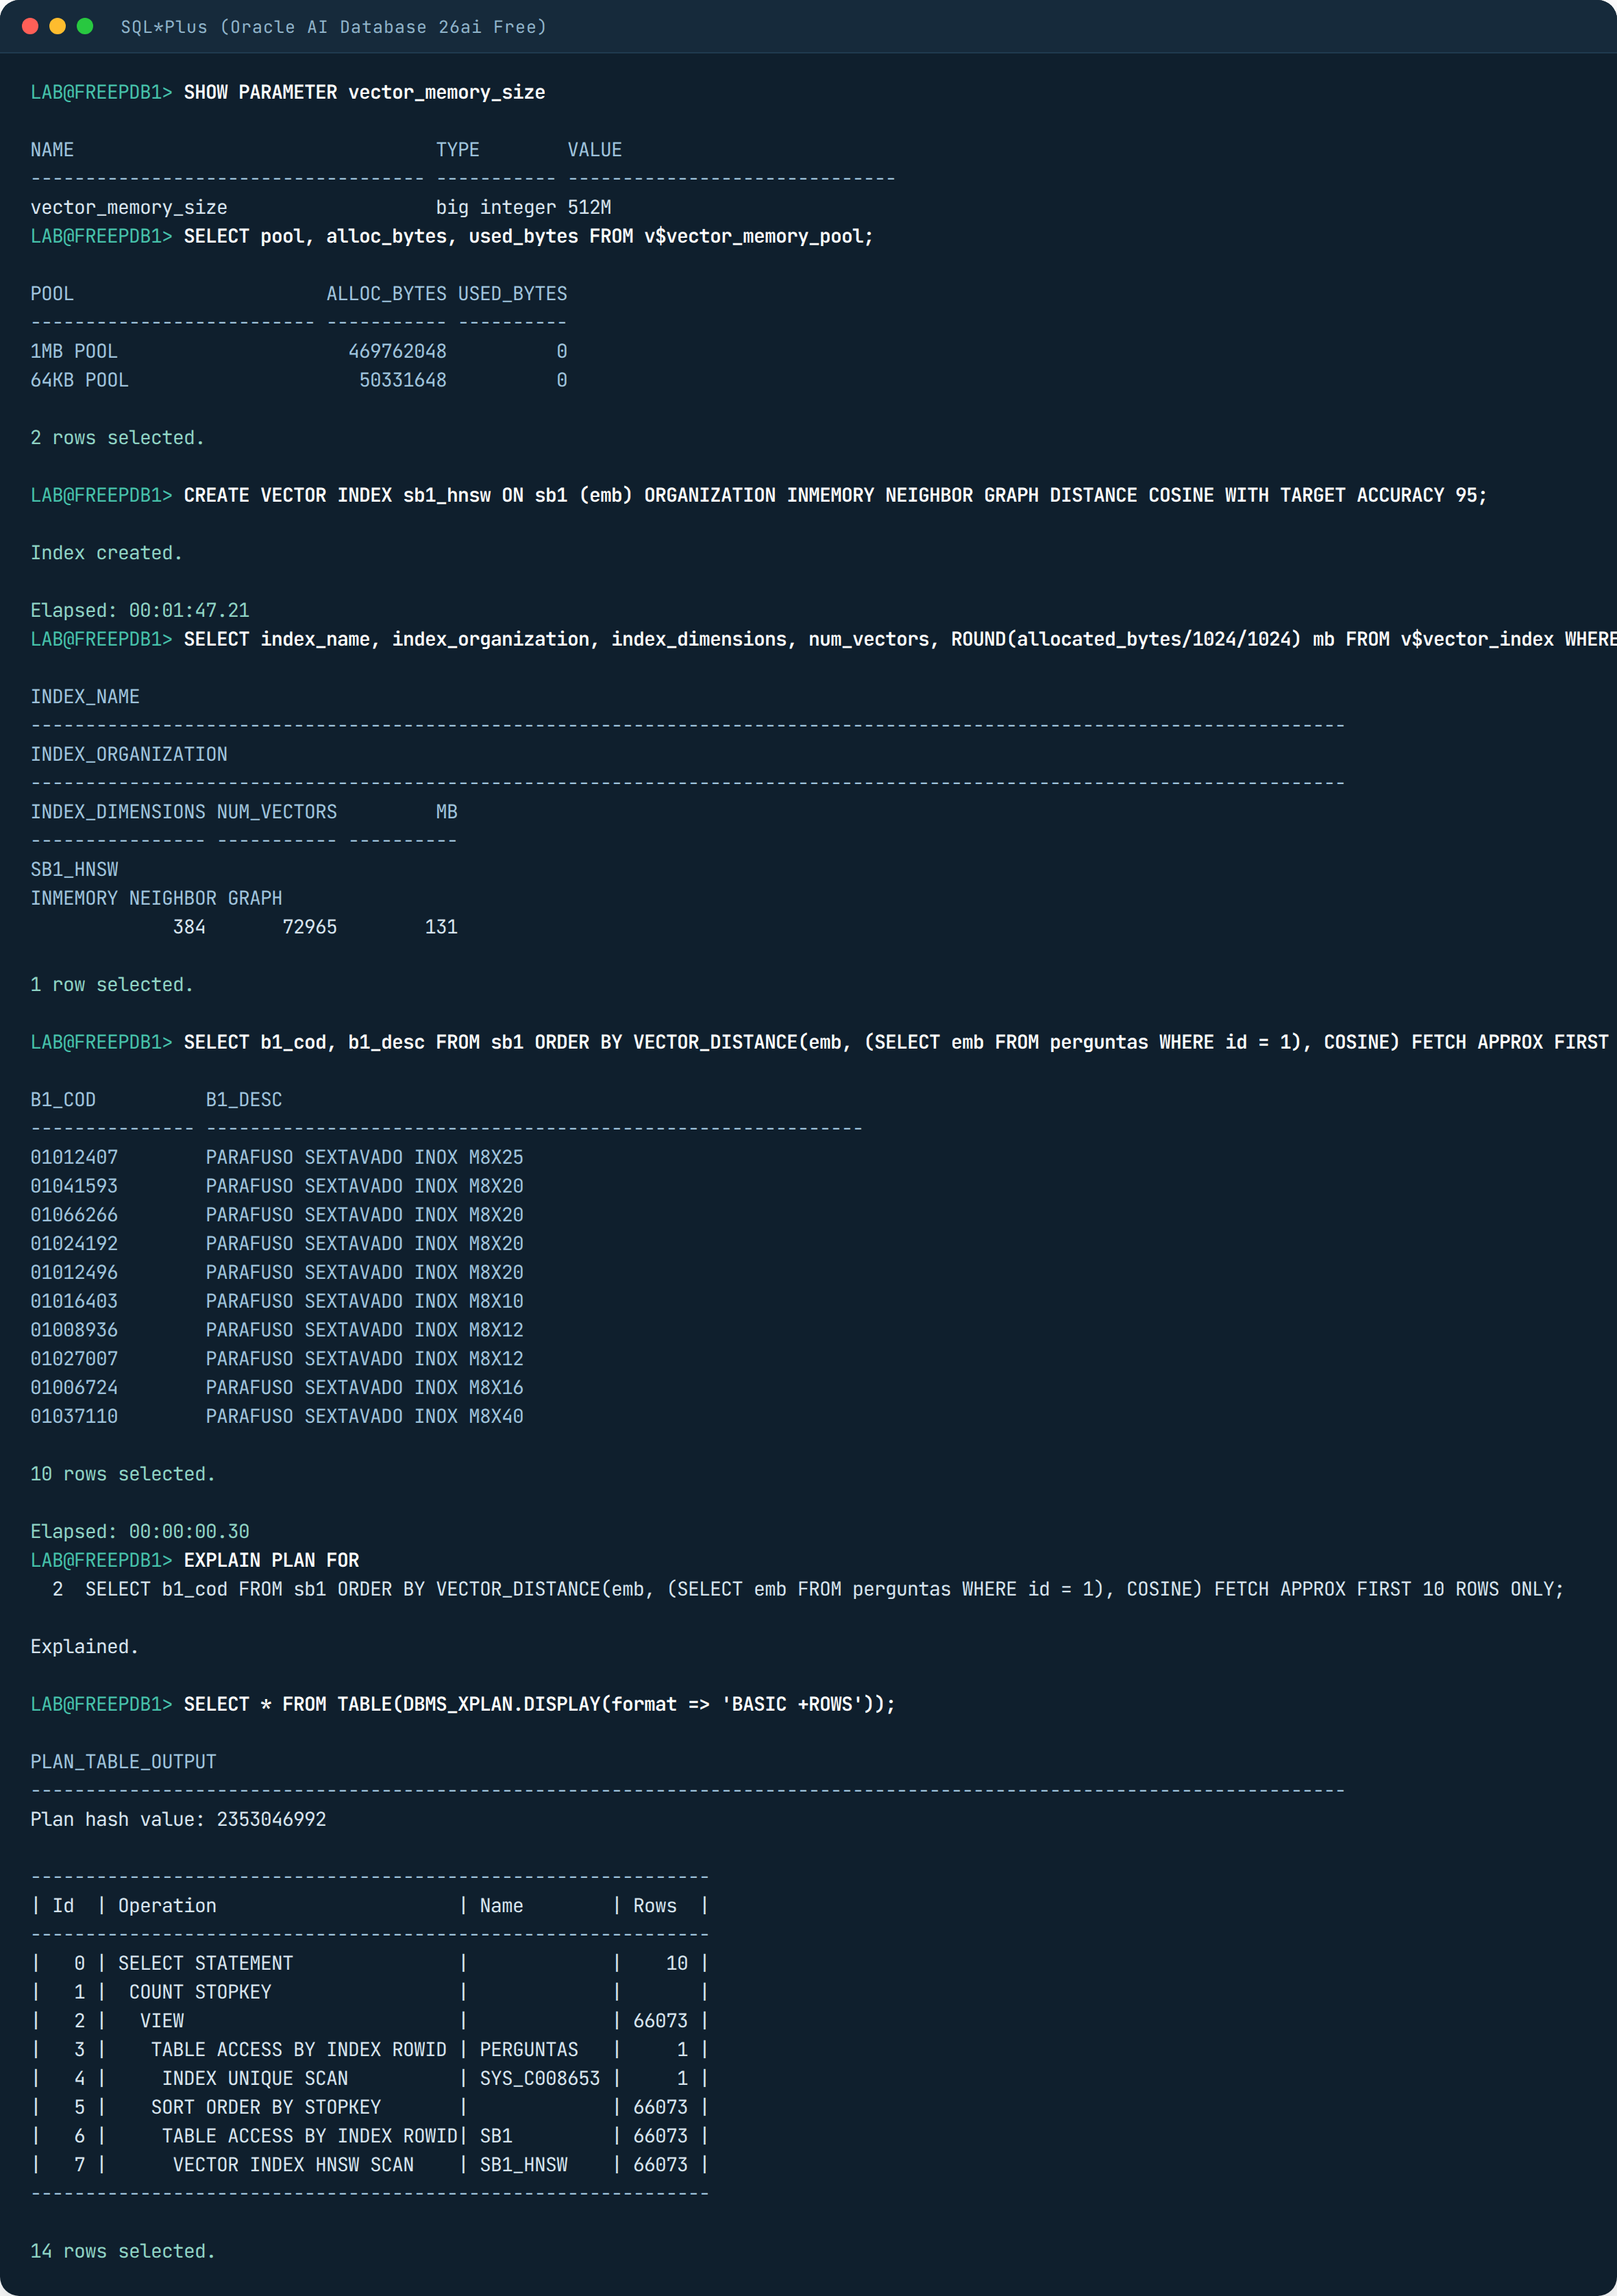
Em compensação a consulta ficou boa. Na Oracle você pede pra usar o índice com FETCH APPROX FIRST 10 ROWS ONLY (o APPROX é “pode ser aproximado”), e o plano confirma: VECTOR INDEX HNSW SCAN. Deu 1,36 ms por pergunta e recall de 96%. Na hora de criar o índice eu pedi WITH TARGET ACCURACY 95, que é “quero pelo menos 95% de acerto”, e ele entregou exatamente isso.
E o filtro? A mesma “correia dentada” no grupo 0020:
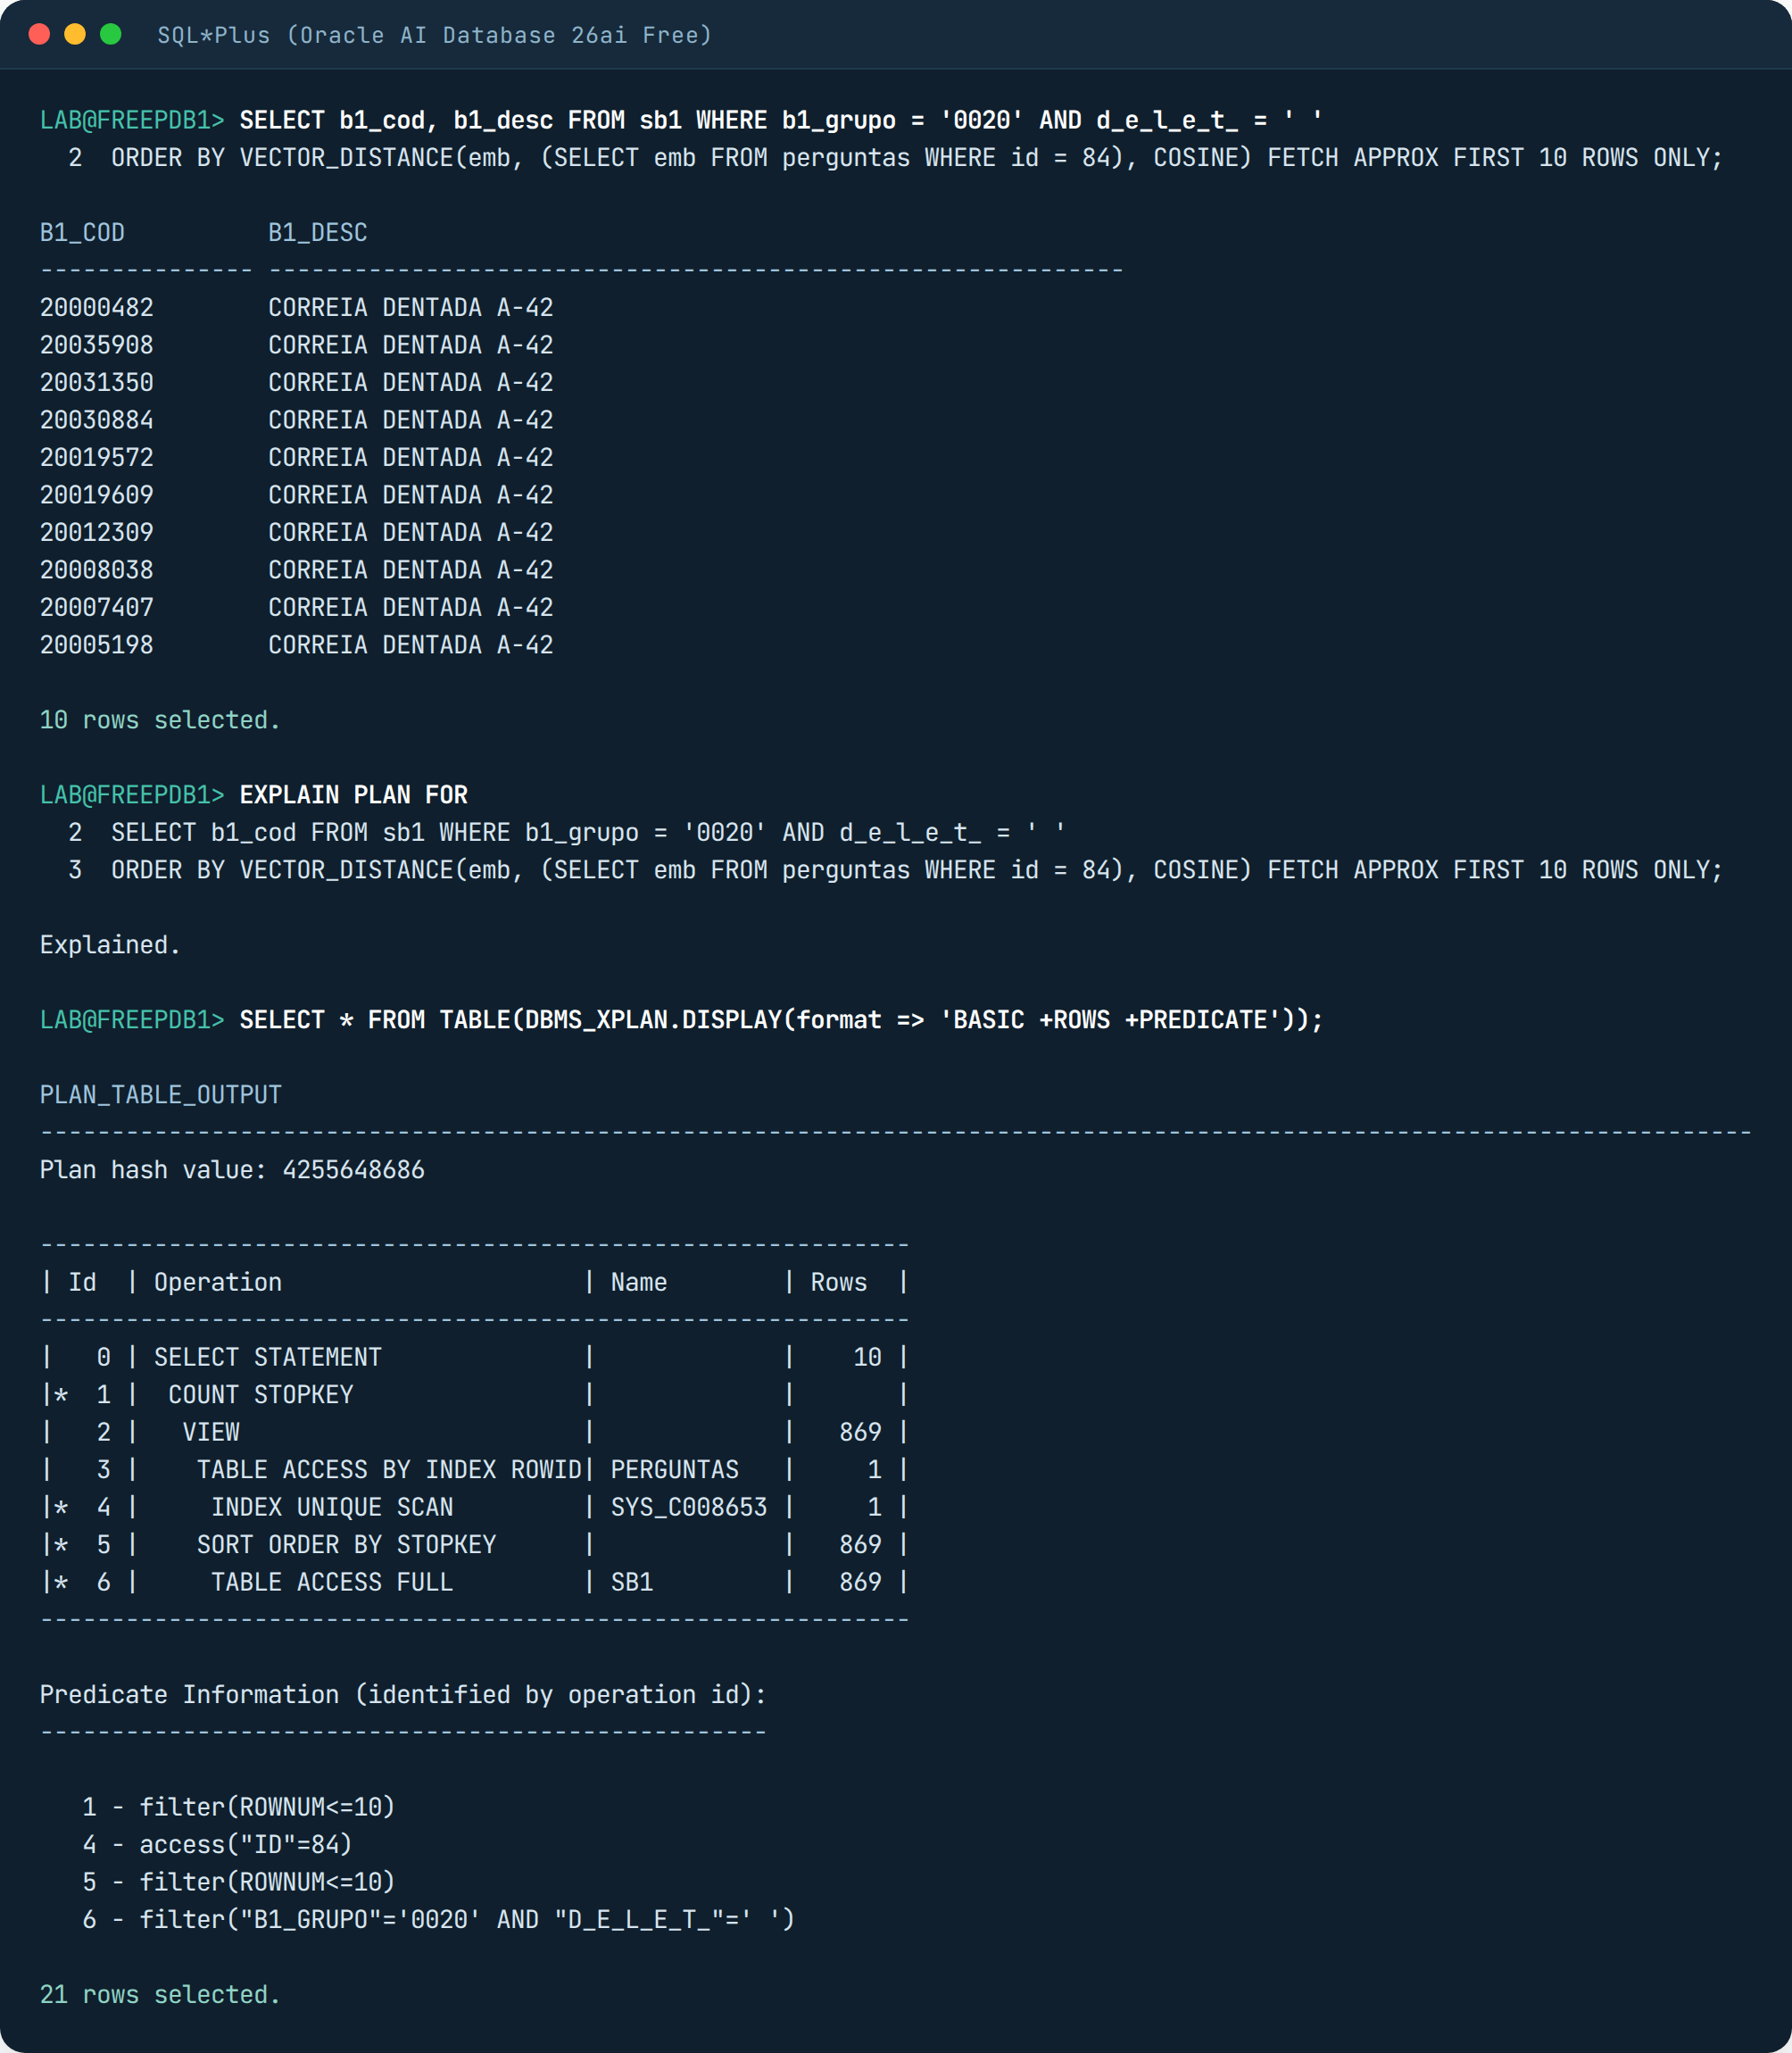
Dez linhas certas. Só que olha o plano: TABLE ACCESS FULL, e nenhum VECTOR INDEX na lista. O otimizador, que é a parte do banco que escolhe o plano, viu o filtro, deixou o índice de lado e fez a busca completa nas 1.206 linhas do grupo. Nas 100 perguntas com filtro, 66 ms por pergunta e recall 100%. Ou seja: o PostgreSQL respondeu rápido e vazio, a Oracle respondeu certo e devagar. Nenhum dos dois faz o que a gente quer sozinho. É decisão de DBA, e tem que ser tomada antes de ir pra produção, não depois.
Agora a parte que só a Oracle tem: o modelo dentro do banco. Lembra que o modelo é o programa que transforma texto em vetor? No PostgreSQL e no MySQL ele fica do lado de fora, num Python, e a aplicação precisa chamar esse Python antes de perguntar ao banco. Na Oracle dá pra carregar o modelo no próprio banco. Baixei o all_MiniLM_L12_v2.onnx que a Oracle distribui no formato dela (133 MB), coloquei numa pasta que o banco enxerga (um DIRECTORY) e carreguei com DBMS_VECTOR.LOAD_ONNX_MODEL. A partir daí o SQL gera o vetor sozinho:
BEGIN
  DBMS_VECTOR.LOAD_ONNX_MODEL(directory => 'LAB_DIR', file_name => 'all_MiniLM_L12_v2.onnx', model_name => 'MINILM');
END;
/
SELECT VECTOR_EMBEDDING(minilm USING 'parafuso sextavado inox' AS data) FROM dual;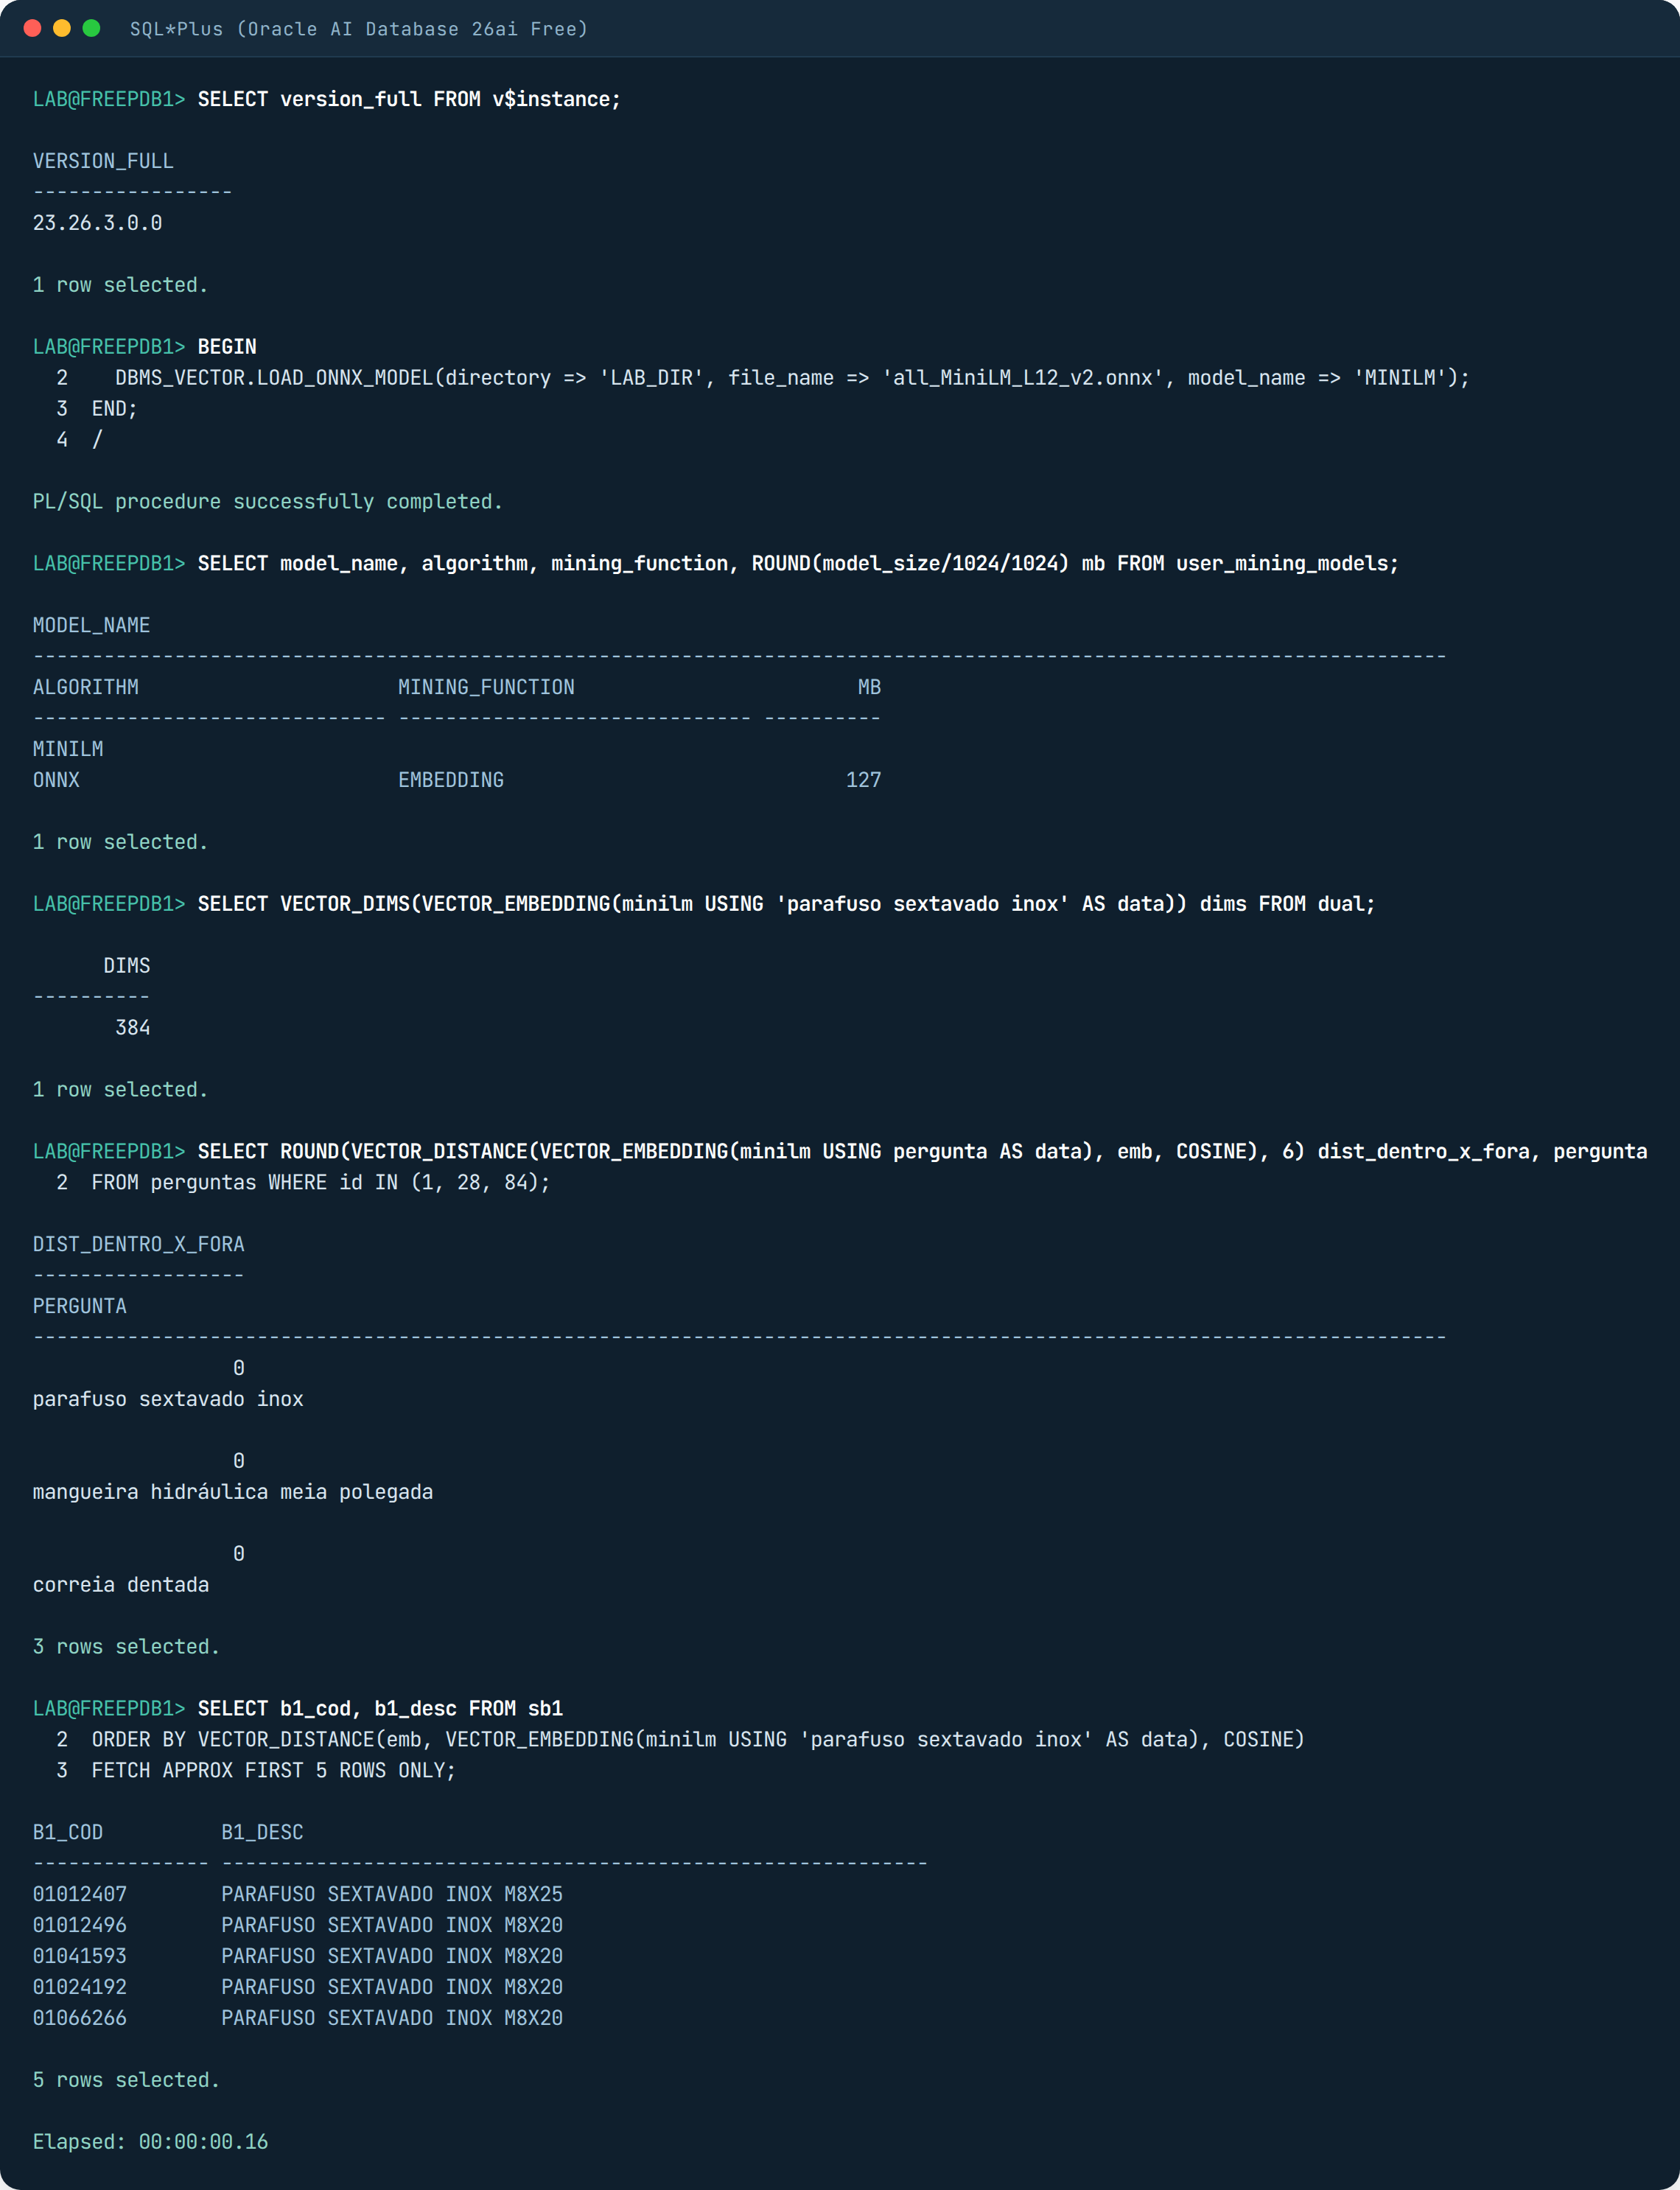
Comparei o vetor que o banco gerou com o que eu tinha gerado fora, com ONNX Runtime, pro mesmo texto. Distância zero nas três perguntas que testei: é o mesmo modelo, dá o mesmo vetor. Na prática isso resolve uma dor: a aplicação manda o texto da busca e o banco faz o resto, sem precisar de um serviço Python no meio. Gerar o vetor da pergunta e buscar, tudo junto, levou 0,16 segundos.
E tem o índice híbrido. Híbrido aqui quer dizer que ele junta duas buscas numa só: a busca por palavra exata (do Oracle Text, que é o mecanismo de busca de texto da Oracle) e a busca por sentido (o vetor). Um único comando, CREATE HYBRID VECTOR INDEX em cima da coluna B1_DESC apontando o modelo, faz a Oracle gerar o vetor das 73 mil descrições dentro do banco e montar o índice de texto junto. Levou 32 minutos e 59 segundos nesta máquina, e o índice ficou com 171 MB.
CREATE HYBRID VECTOR INDEX sb1_hib ON sb1 (b1_desc) PARAMETERS ('MODEL MINILM');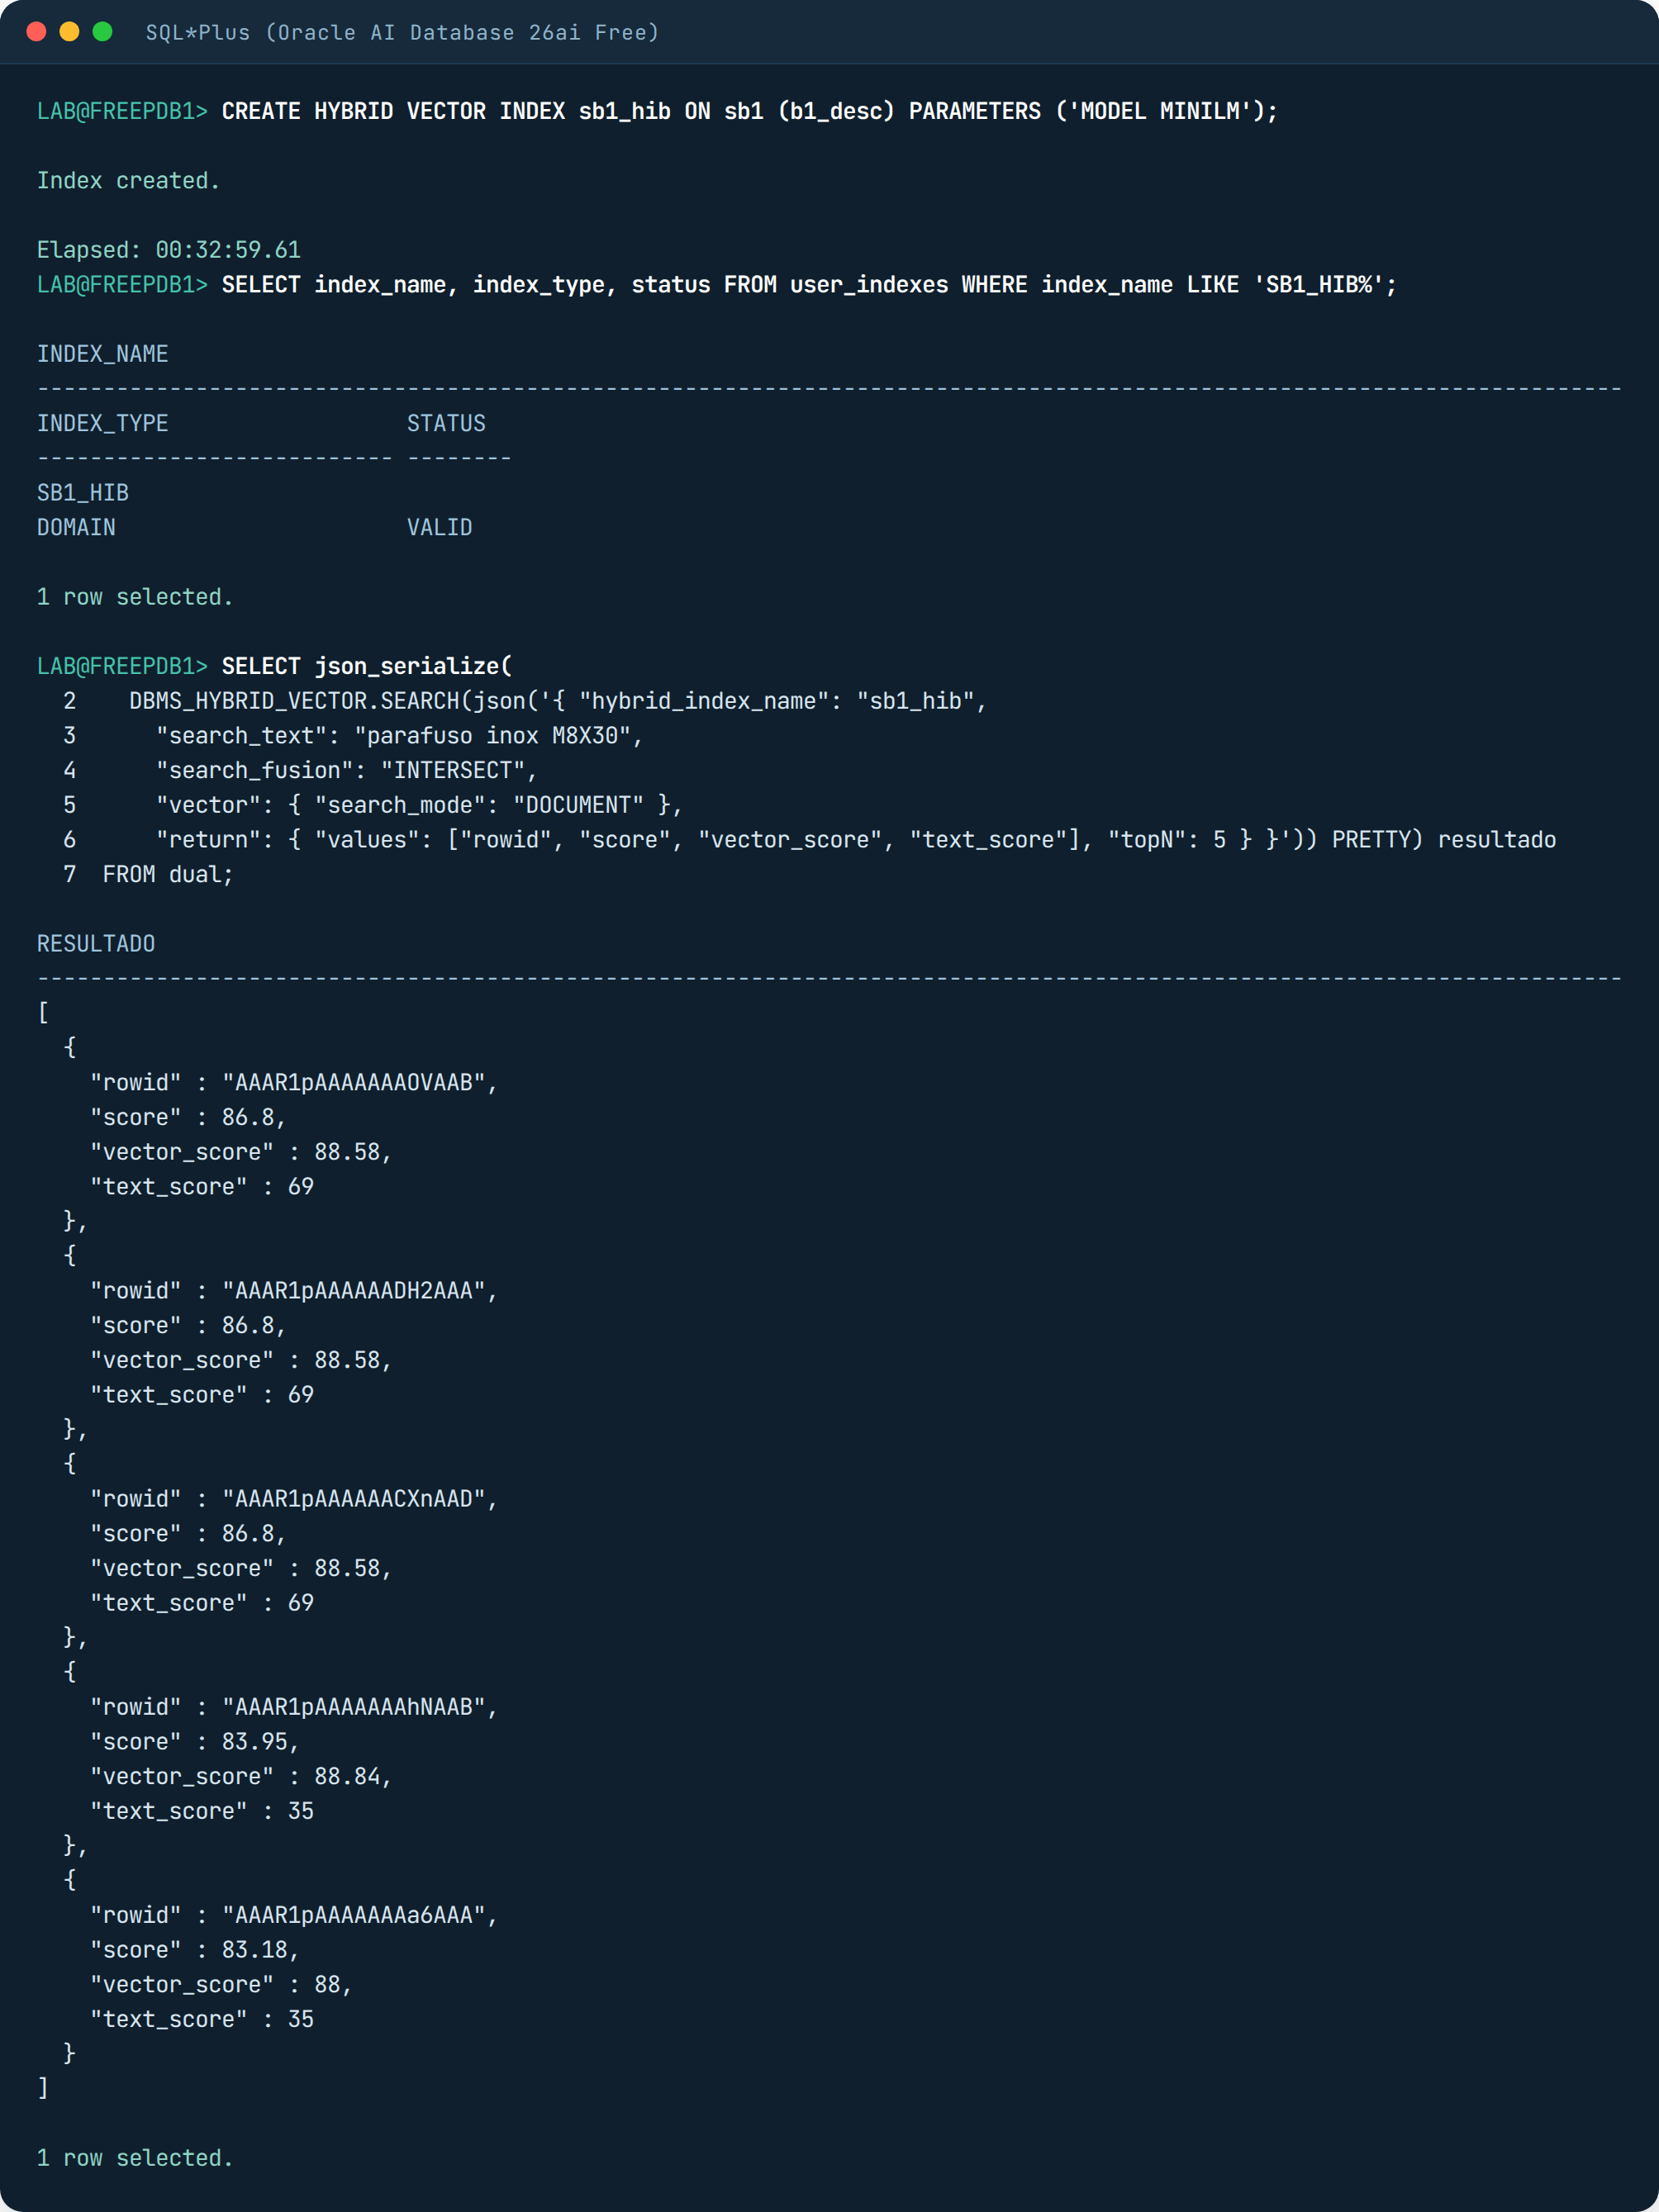
A busca é pela função DBMS_HYBRID_VECTOR.SEARCH. Você passa os parâmetros num texto em formato JSON e ela devolve, também em JSON, a nota de texto e a nota de vetor de cada produto, separadas. Cruzei os rowids (o endereço de cada linha) com a SB1 pra ler as descrições. A pergunta foi “parafuso inox M8X30”: o M8X30 é código de medida, tem que bater exato; “parafuso inox” é sentido.
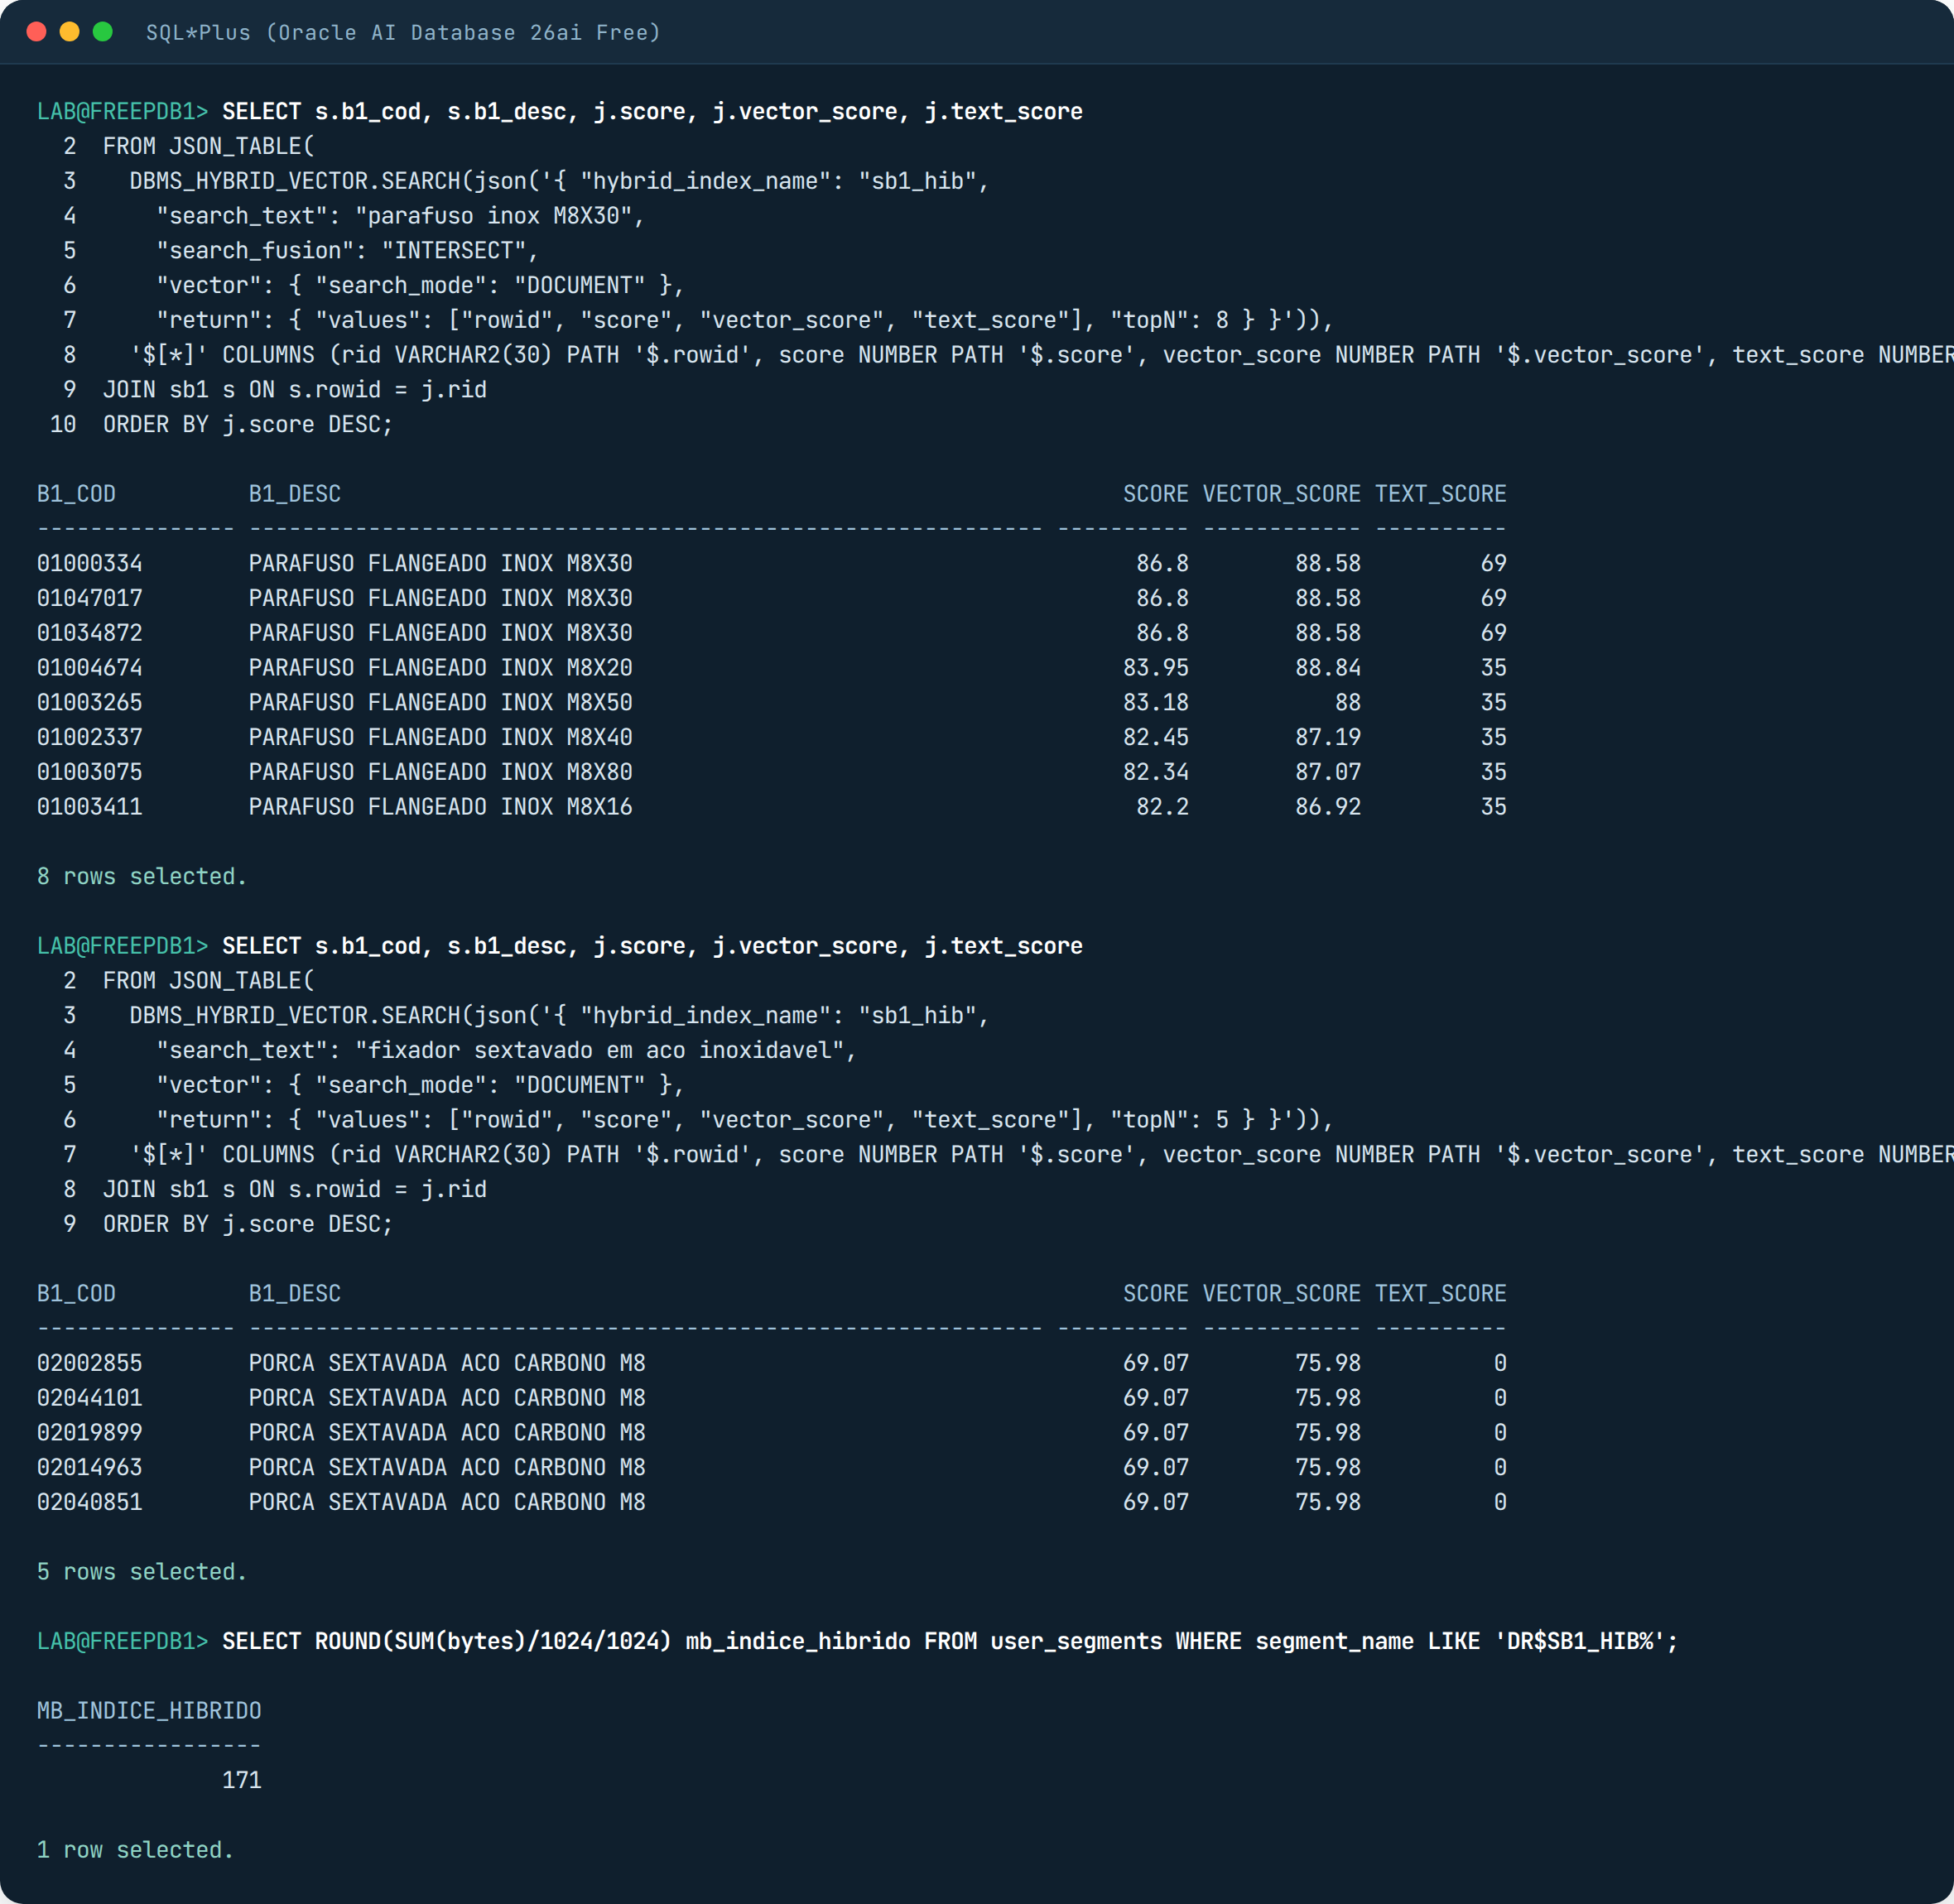
Os três primeiros são PARAFUSO FLANGEADO INOX M8X30, com text_score 69 porque o M8X30 bateu; os seguintes são M8X20, M8X50 e M8X40, parecidos no sentido mas com o text_score caindo pra 35. Na segunda pergunta, “fixador sextavado em aco inoxidavel”, nenhuma palavra existe no cadastro escrita assim, o text_score vai a zero e só o vetor trabalha: trouxe porcas sextavadas, que é parente, mas não é parafuso. Pra quem tem ERP esse é o cenário mais real que existe: código de produto é busca exata, descrição é busca por sentido, e o índice híbrido faz os dois numa chamada só.
MySQL 9.7 Community: guarda o vetor e não sabe comparar
MySQL 9.7.4 Community, que é a versão gratuita e a LTS (suporte longo) de abril de 2026. Criei a coluna VECTOR(384), carreguei a SB1 com LOAD DATA e converti os vetores do arquivo com STRING_TO_VECTOR num UPDATE: 66 segundos, bem mais que os outros dois, e 174 MB. VECTOR_DIM responde 384, então o vetor está lá inteiro. Até aqui parece que vai.
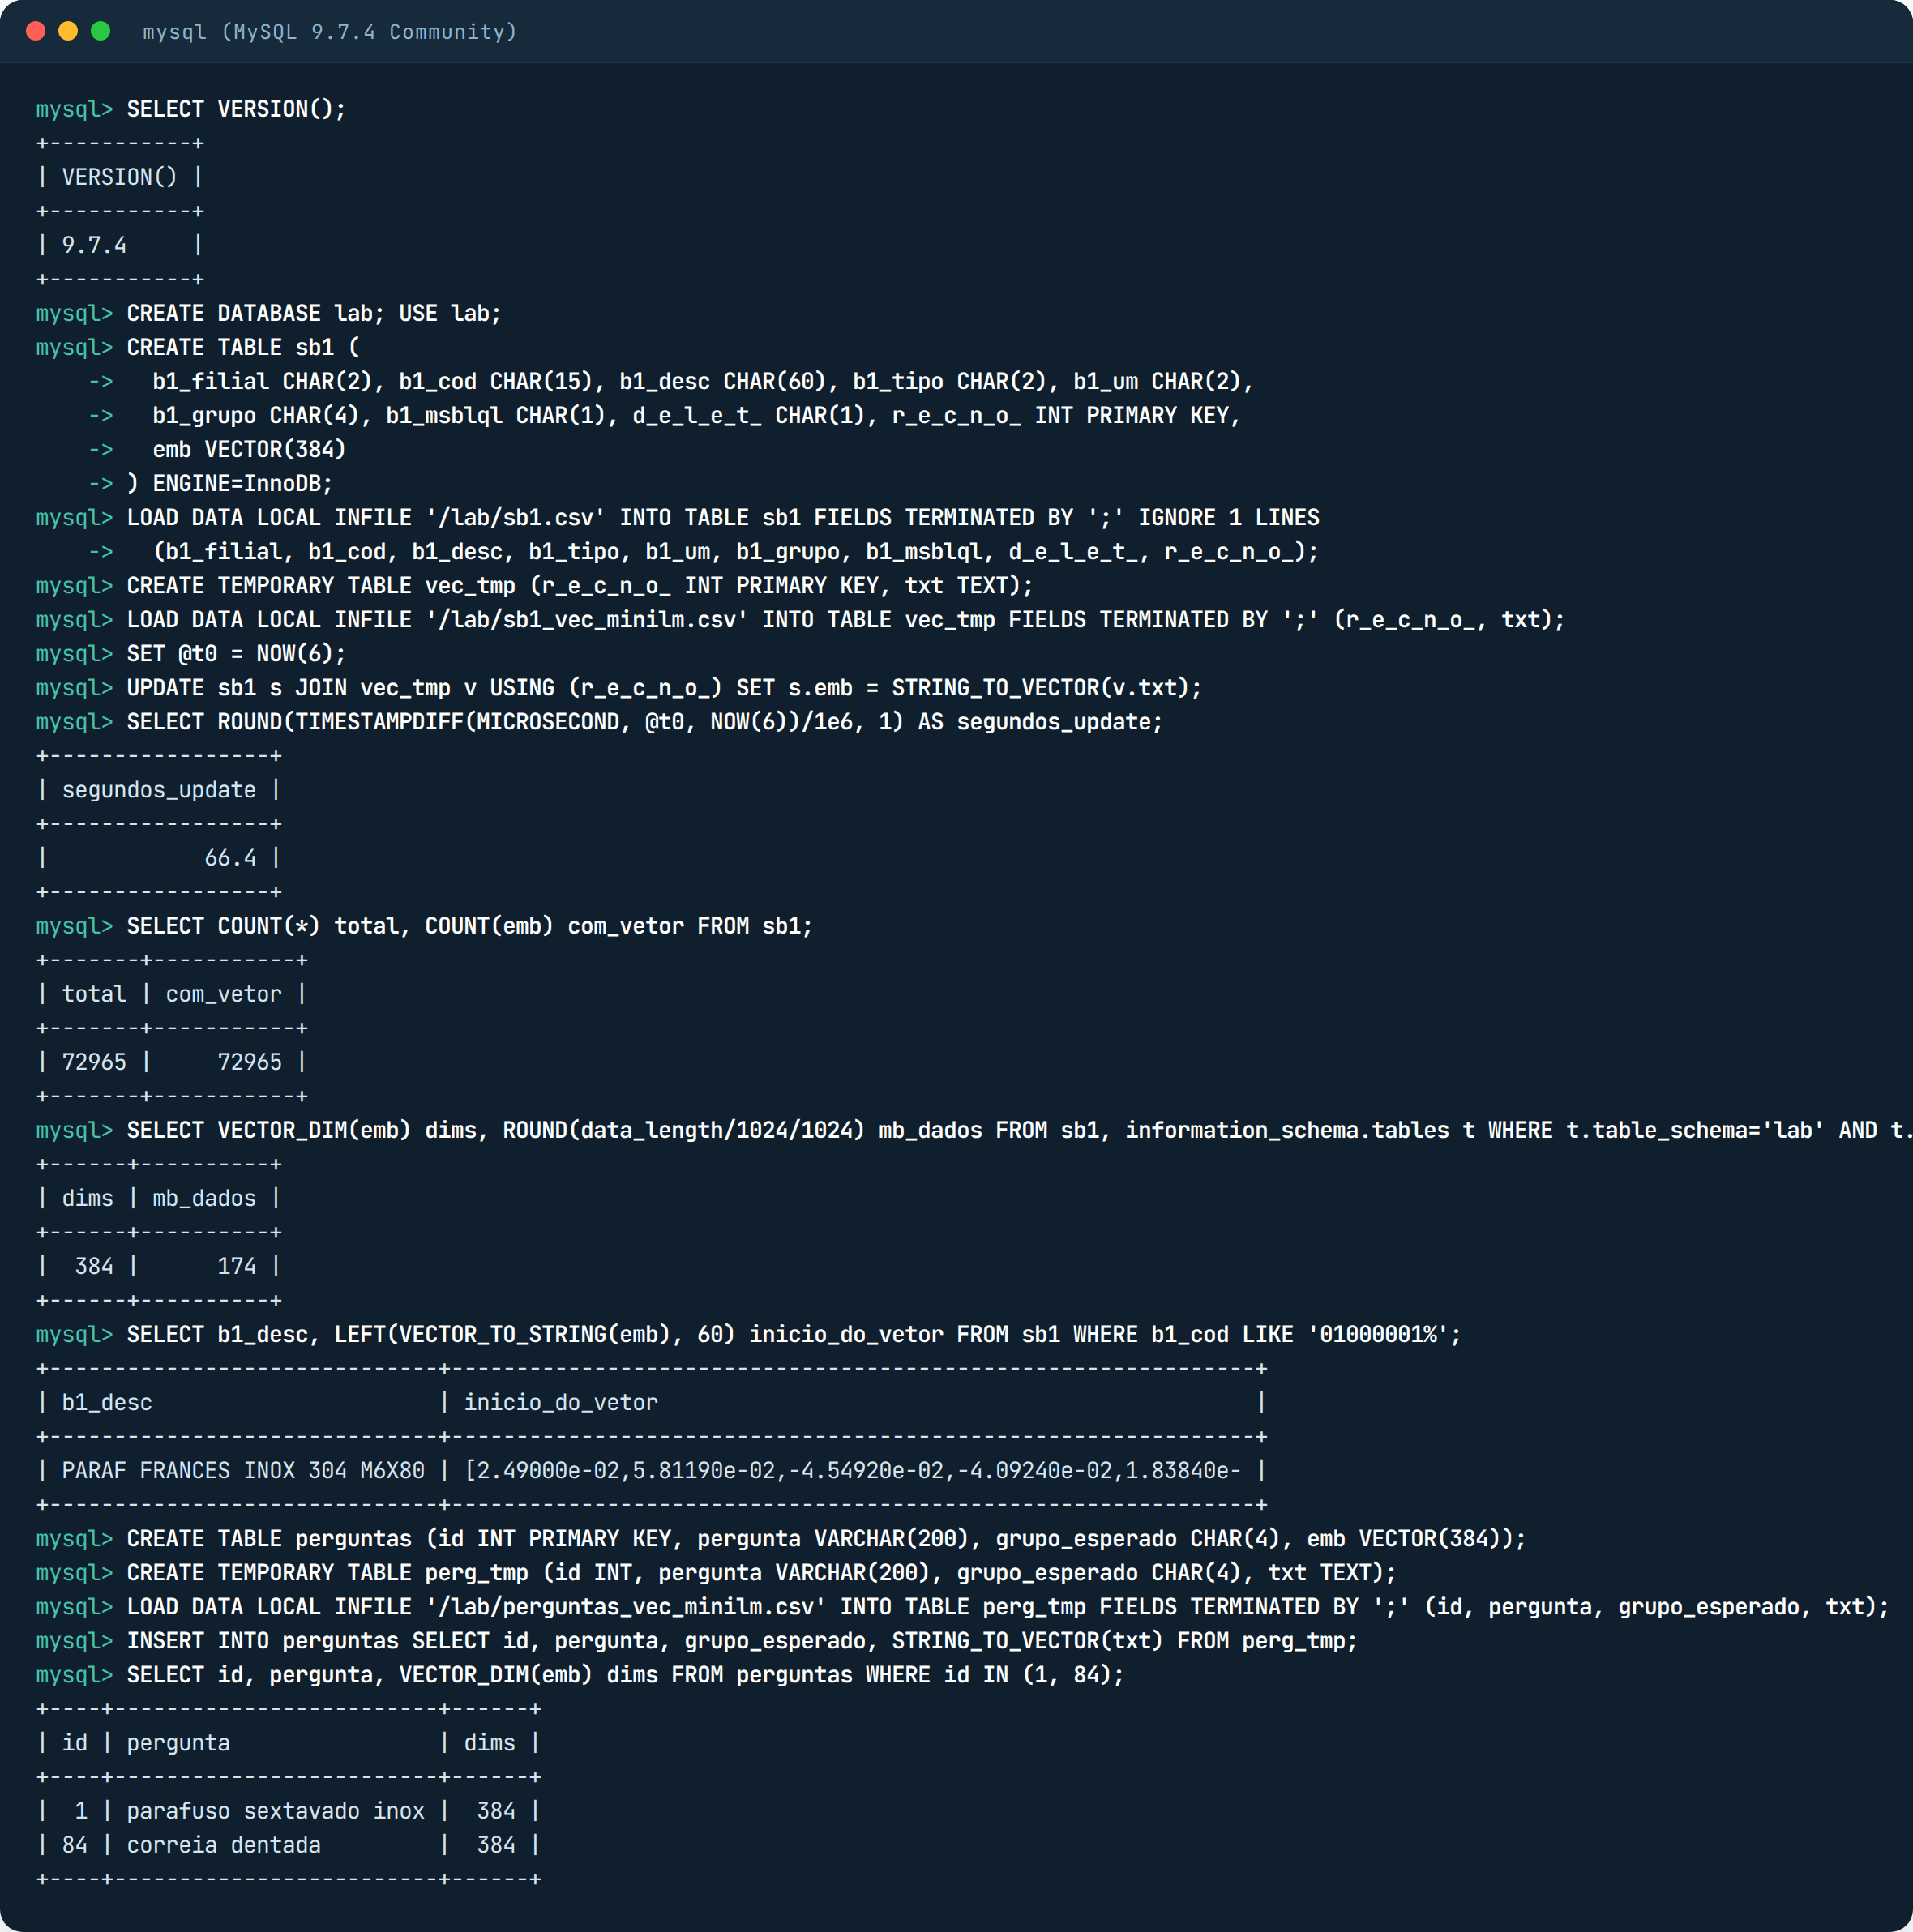
O problema aparece na hora de comparar. Pra achar os parecidos, o banco precisa de uma função que calcule a distância entre dois vetores. No MySQL ela chama DISTANCE():
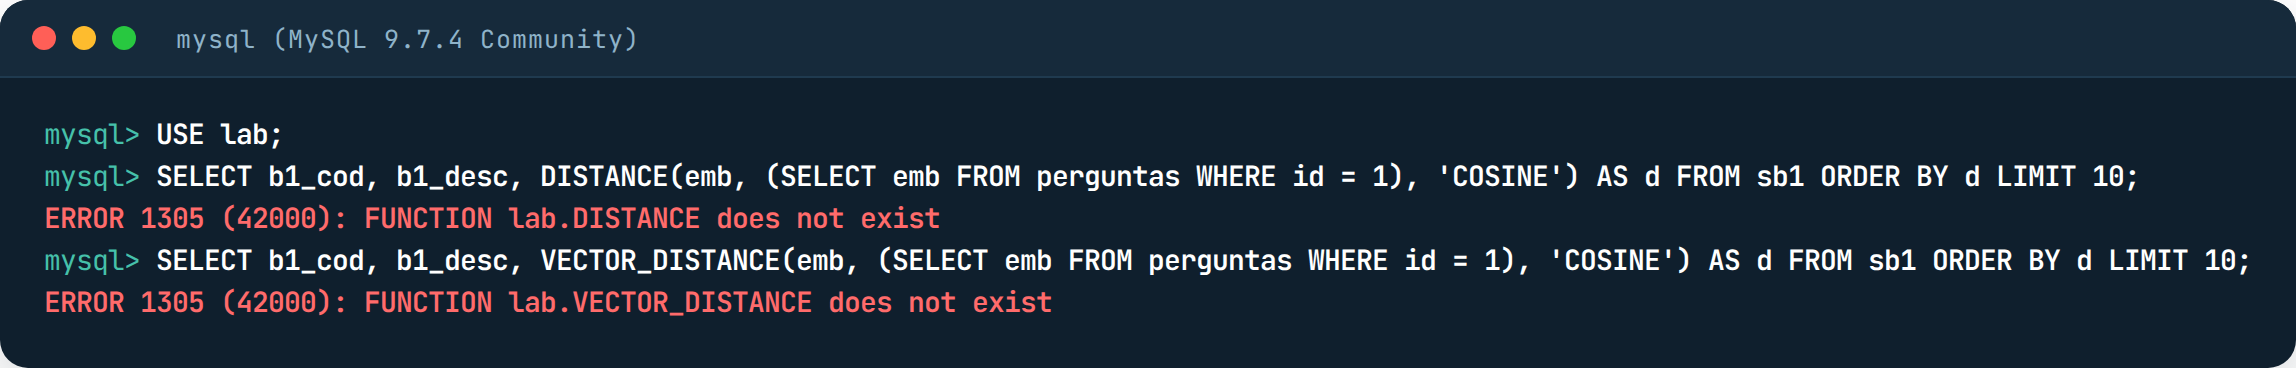
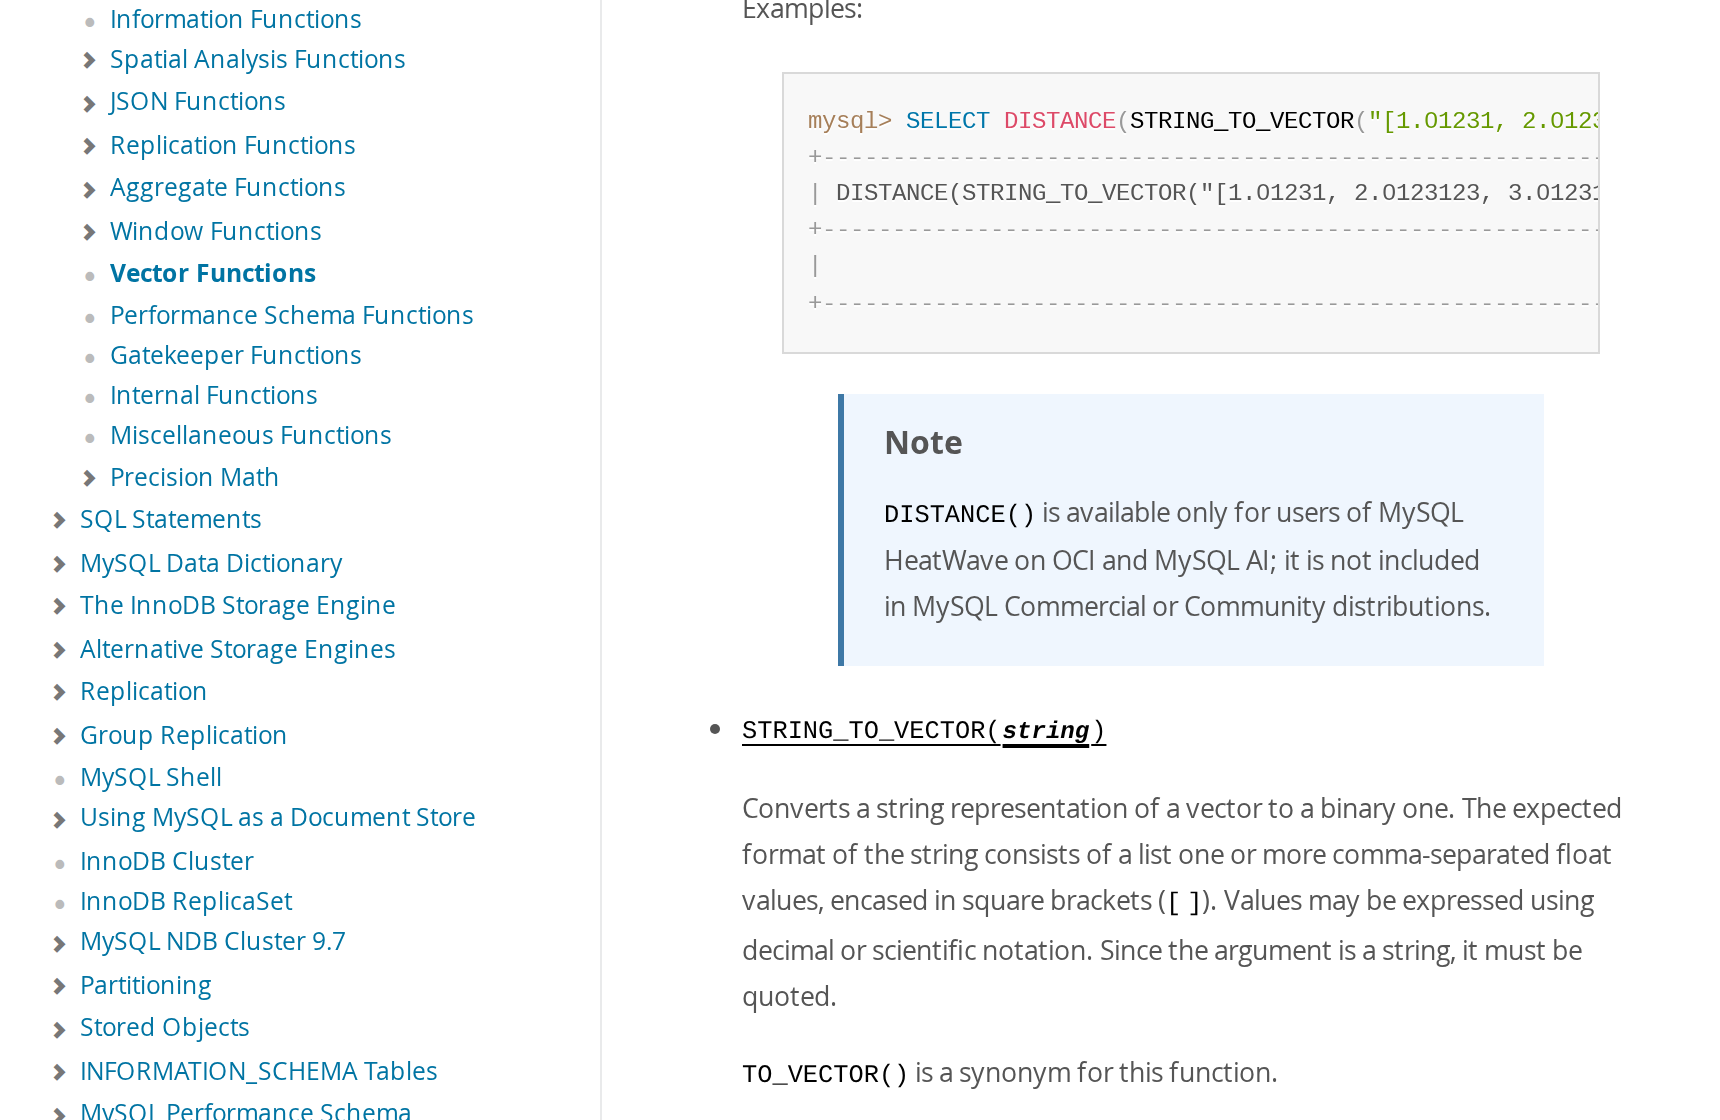
Não existe. Nem ela nem o outro nome, VECTOR_DISTANCE. O manual explica: essa função só vem no MySQL HeatWave (a versão em nuvem da Oracle) e no MySQL AI. Na Community e na Commercial, não.
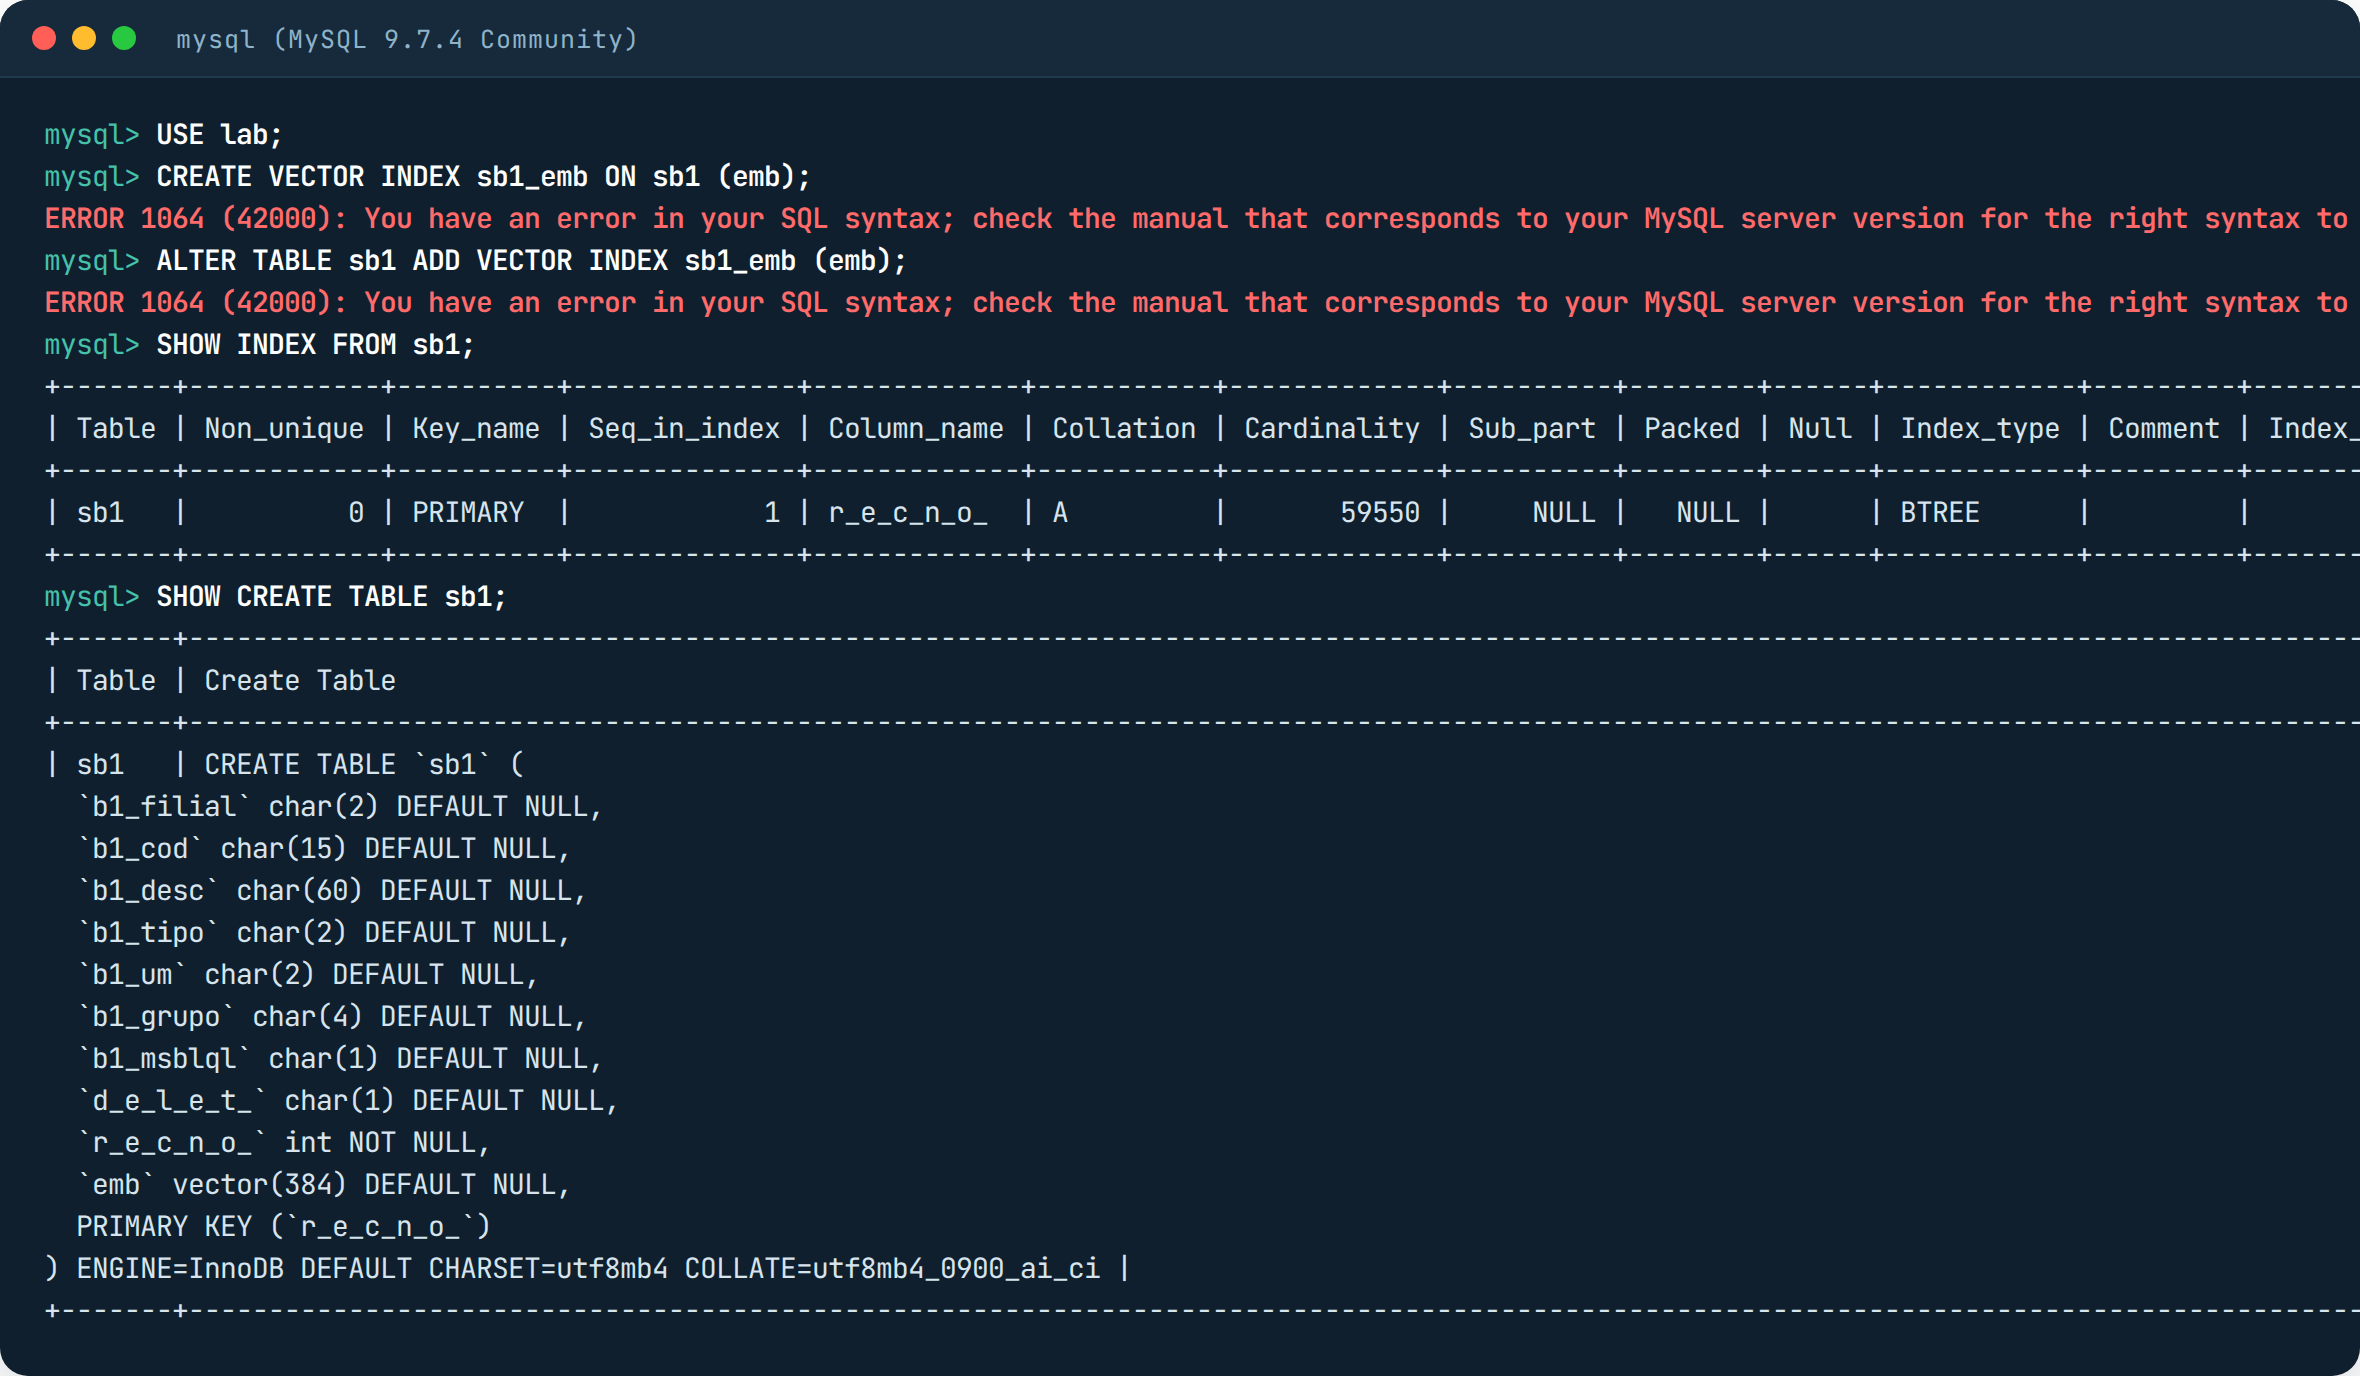
E índice vetorial o MySQL Community não tem. Tentei dos dois jeitos que a sintaxe do MySQL aceitaria se existisse, e o banco não reconhece nenhum:
O que dá pra fazer no Community é tirar os vetores do banco e comparar na aplicação. Eu fiz: trazer os 72.965 vetores levou 15,8 segundos e ocupou 112 MB de memória no programa; depois disso cada pergunta sai em 9,5 ms, com recall 100%, porque é a busca completa. Pra 70 mil produtos passa. Pra 7 milhões, não. Quem quer índice vetorial sem sair dessa família vai pro MariaDB, que é o próximo da lista.
MariaDB 11.8: o primo do MySQL que tem índice
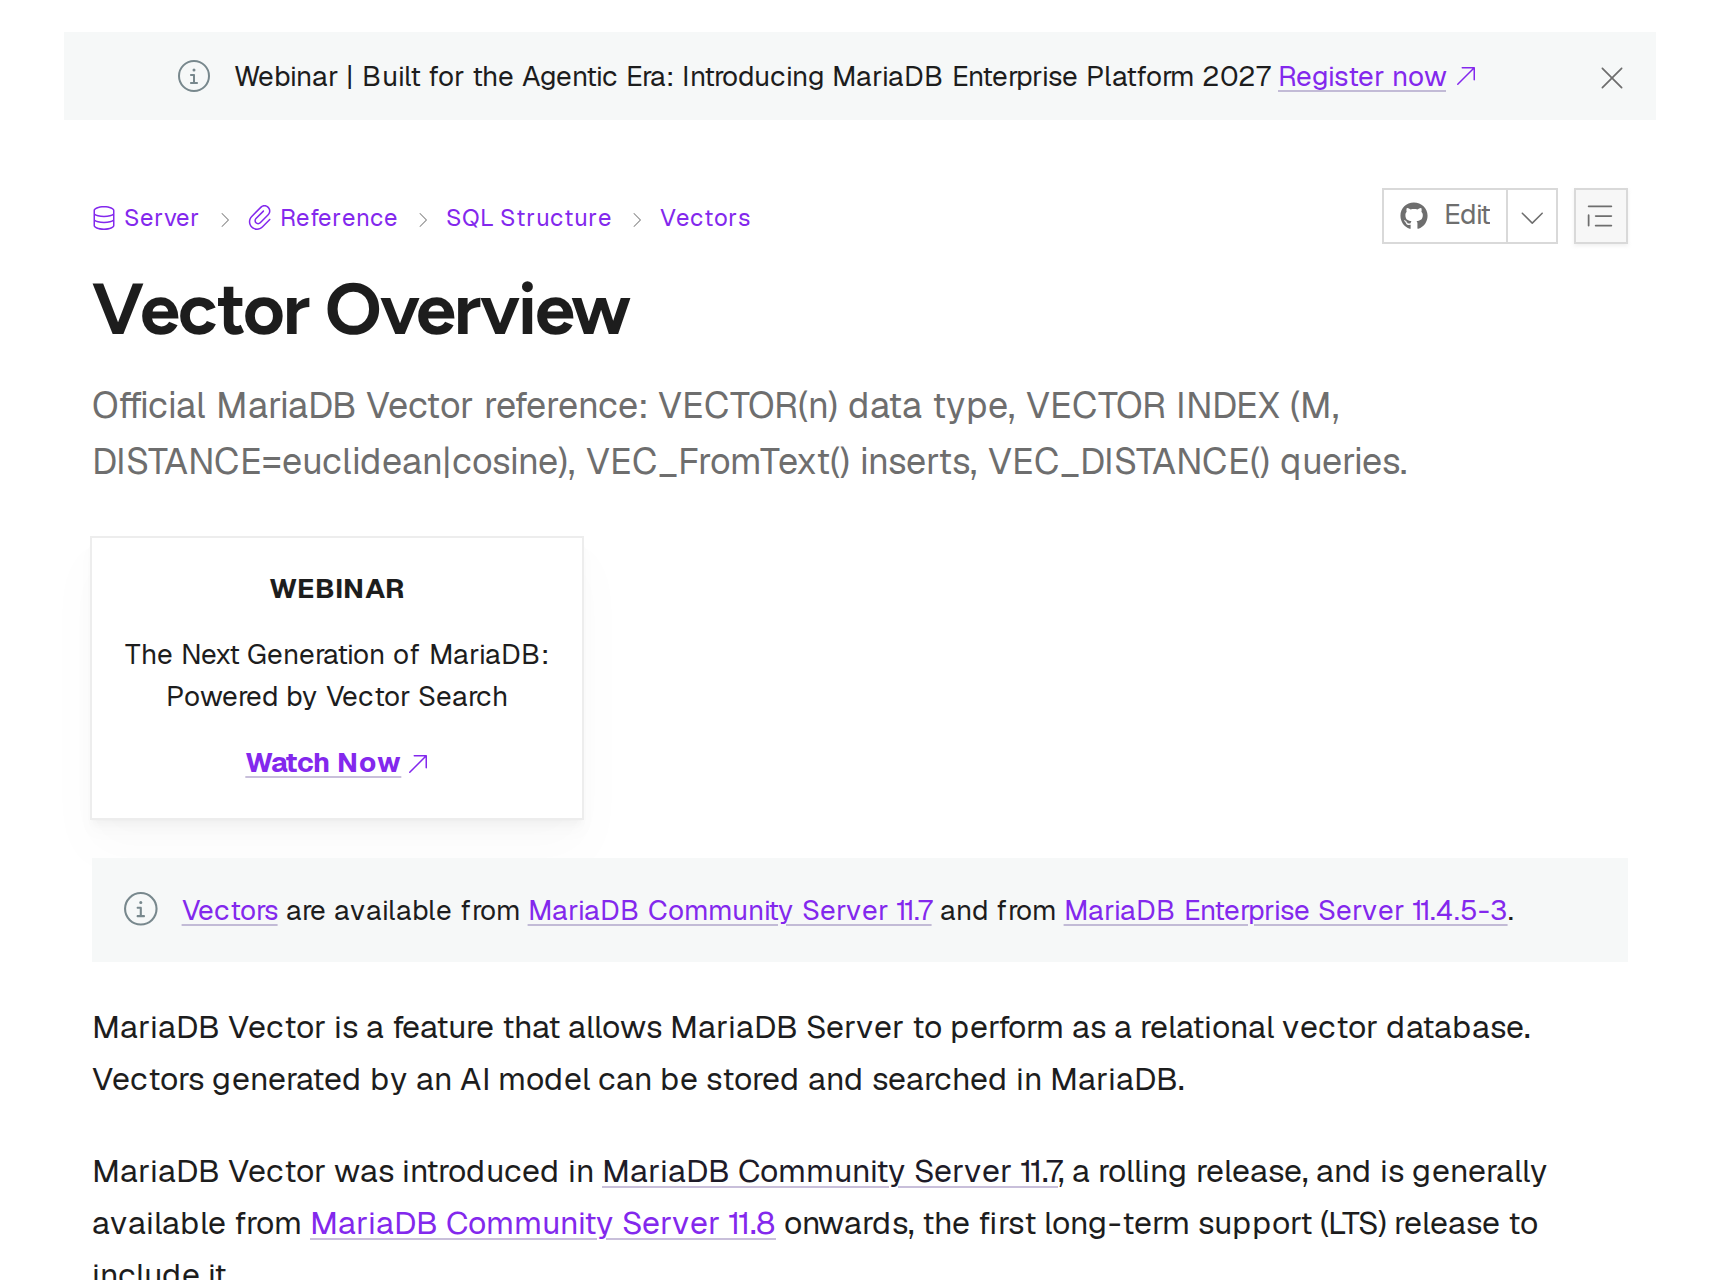
O MariaDB saiu do MySQL em 2009 e hoje é outro banco, mas quem tem MySQL costuma conseguir trocar por ele sem mexer na aplicação. Desde a versão 11.7, e na 11.8, que é a LTS, ele tem o tipo VECTOR, as funções de distância e o índice vetorial, tudo na versão gratuita. Testei a 11.8.8. A coluna é VECTOR(384) NOT NULL (o NOT NULL é obrigatório pra poder indexar), e a carga foi com LOAD DATA mais VEC_FromText, que converte o texto em vetor: 10 segundos.
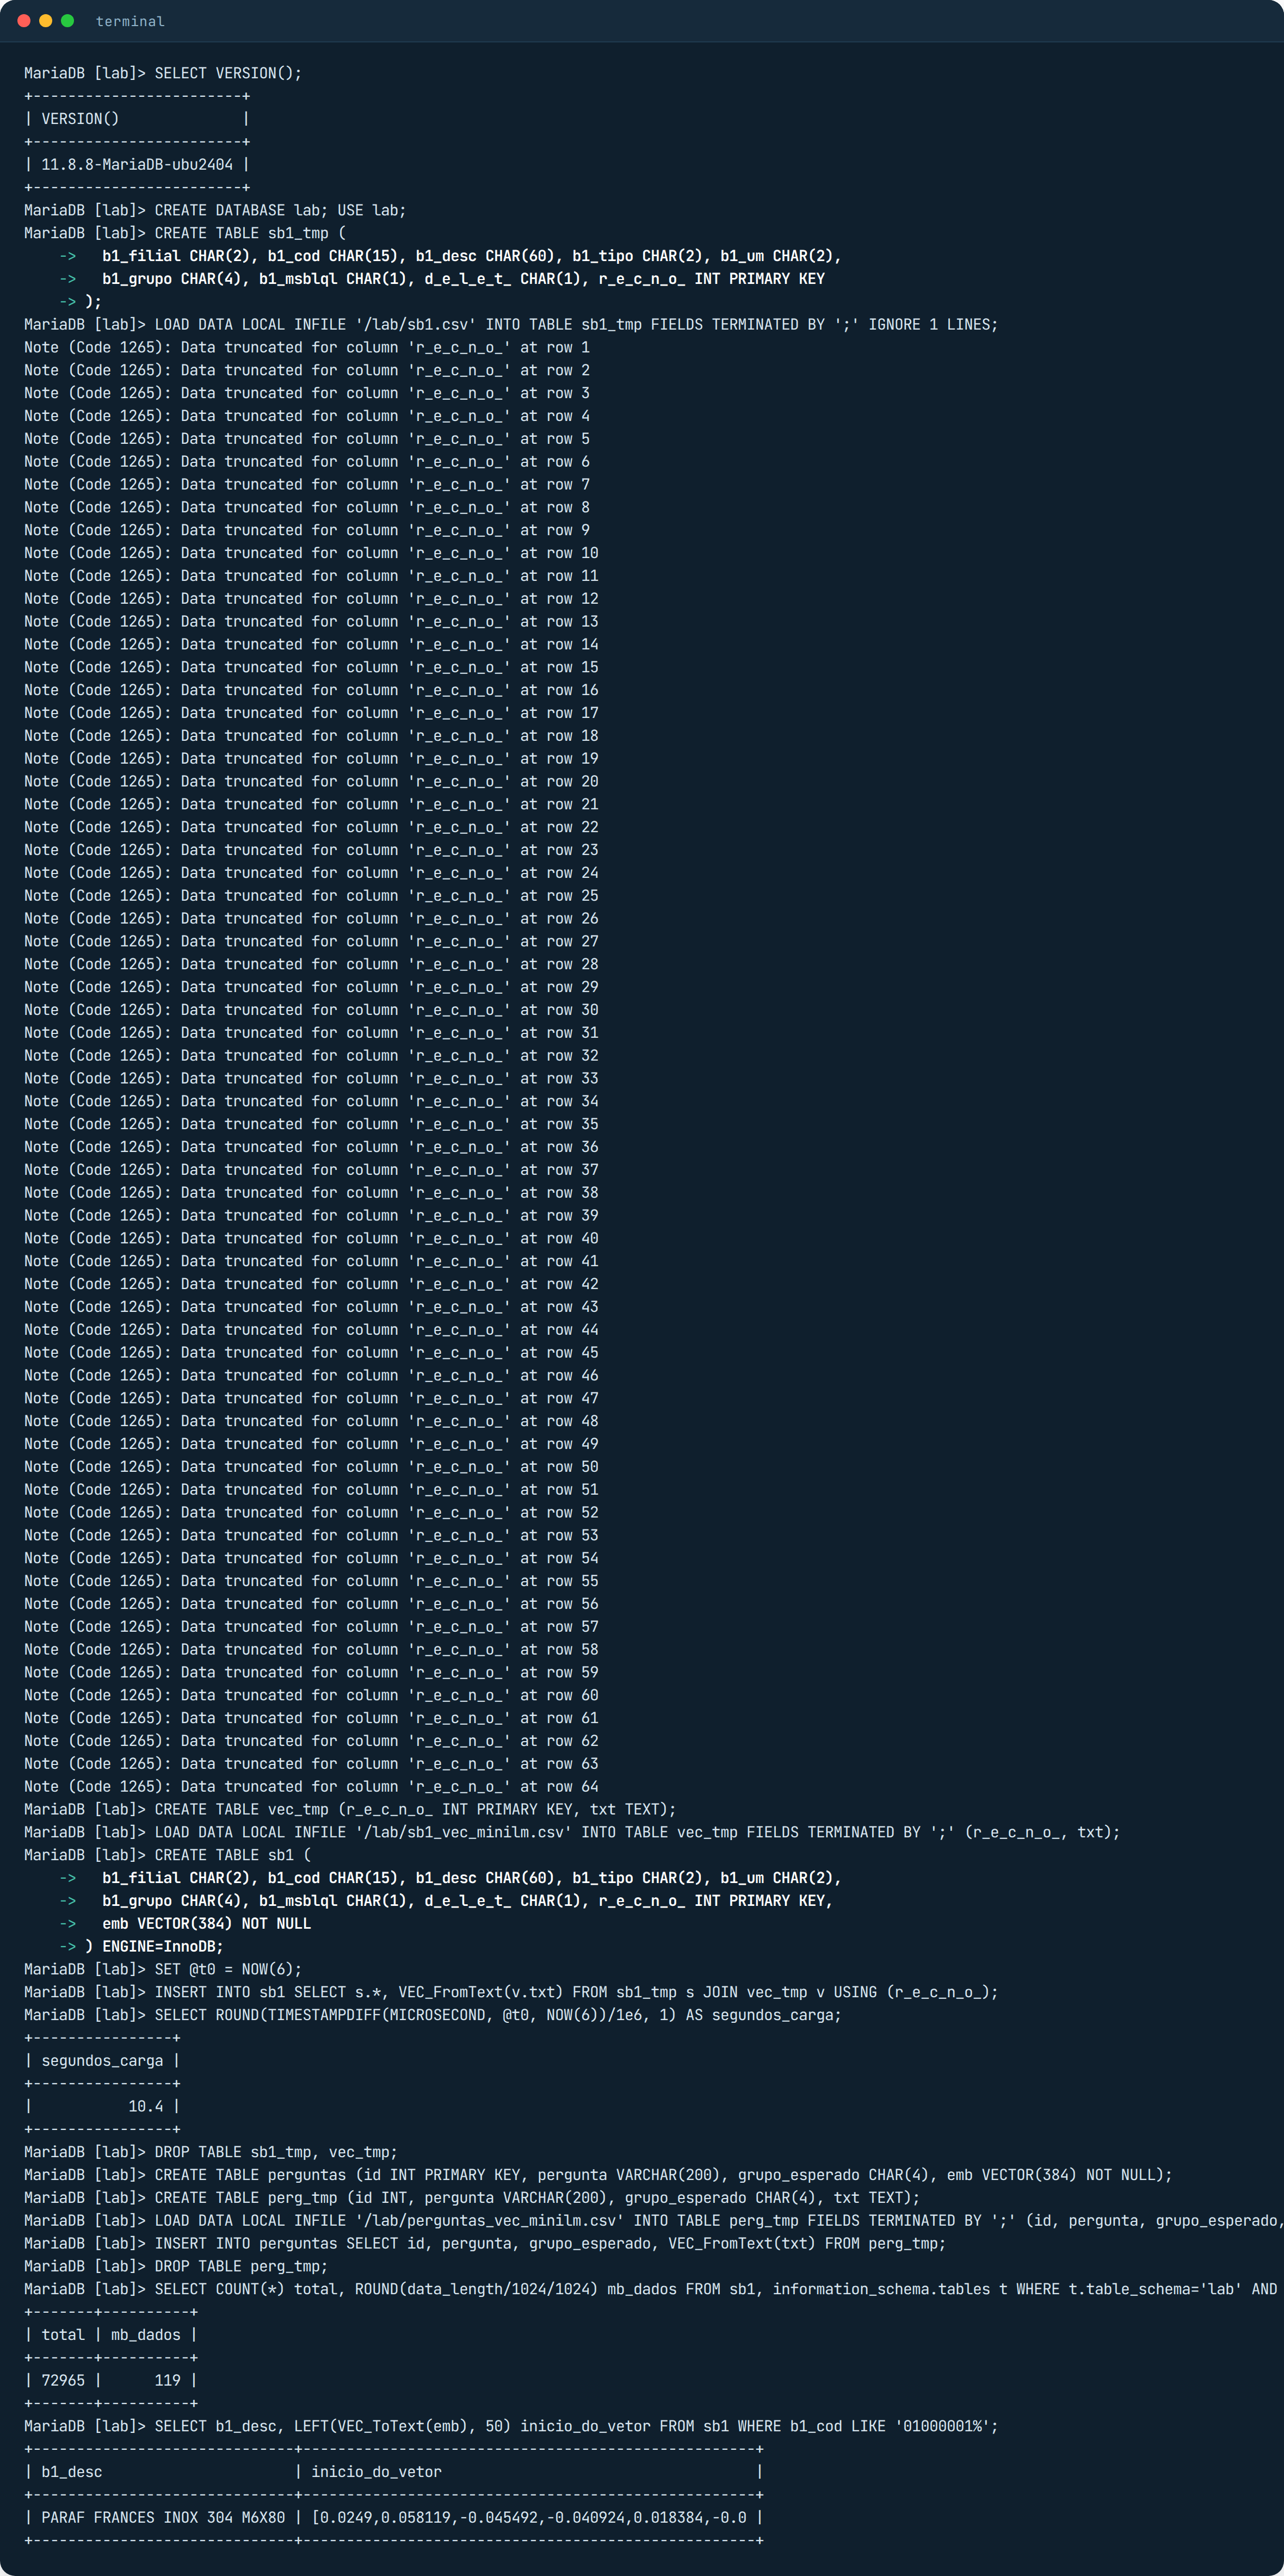
A busca completa funciona de cara com VEC_DISTANCE_COSINE, e o EXPLAIN mostra type ALL com Using filesort, que é “li a tabela inteira e ordenei”. Deu 83 ms no cliente e 87 ms por pergunta na medição, perto do PostgreSQL.
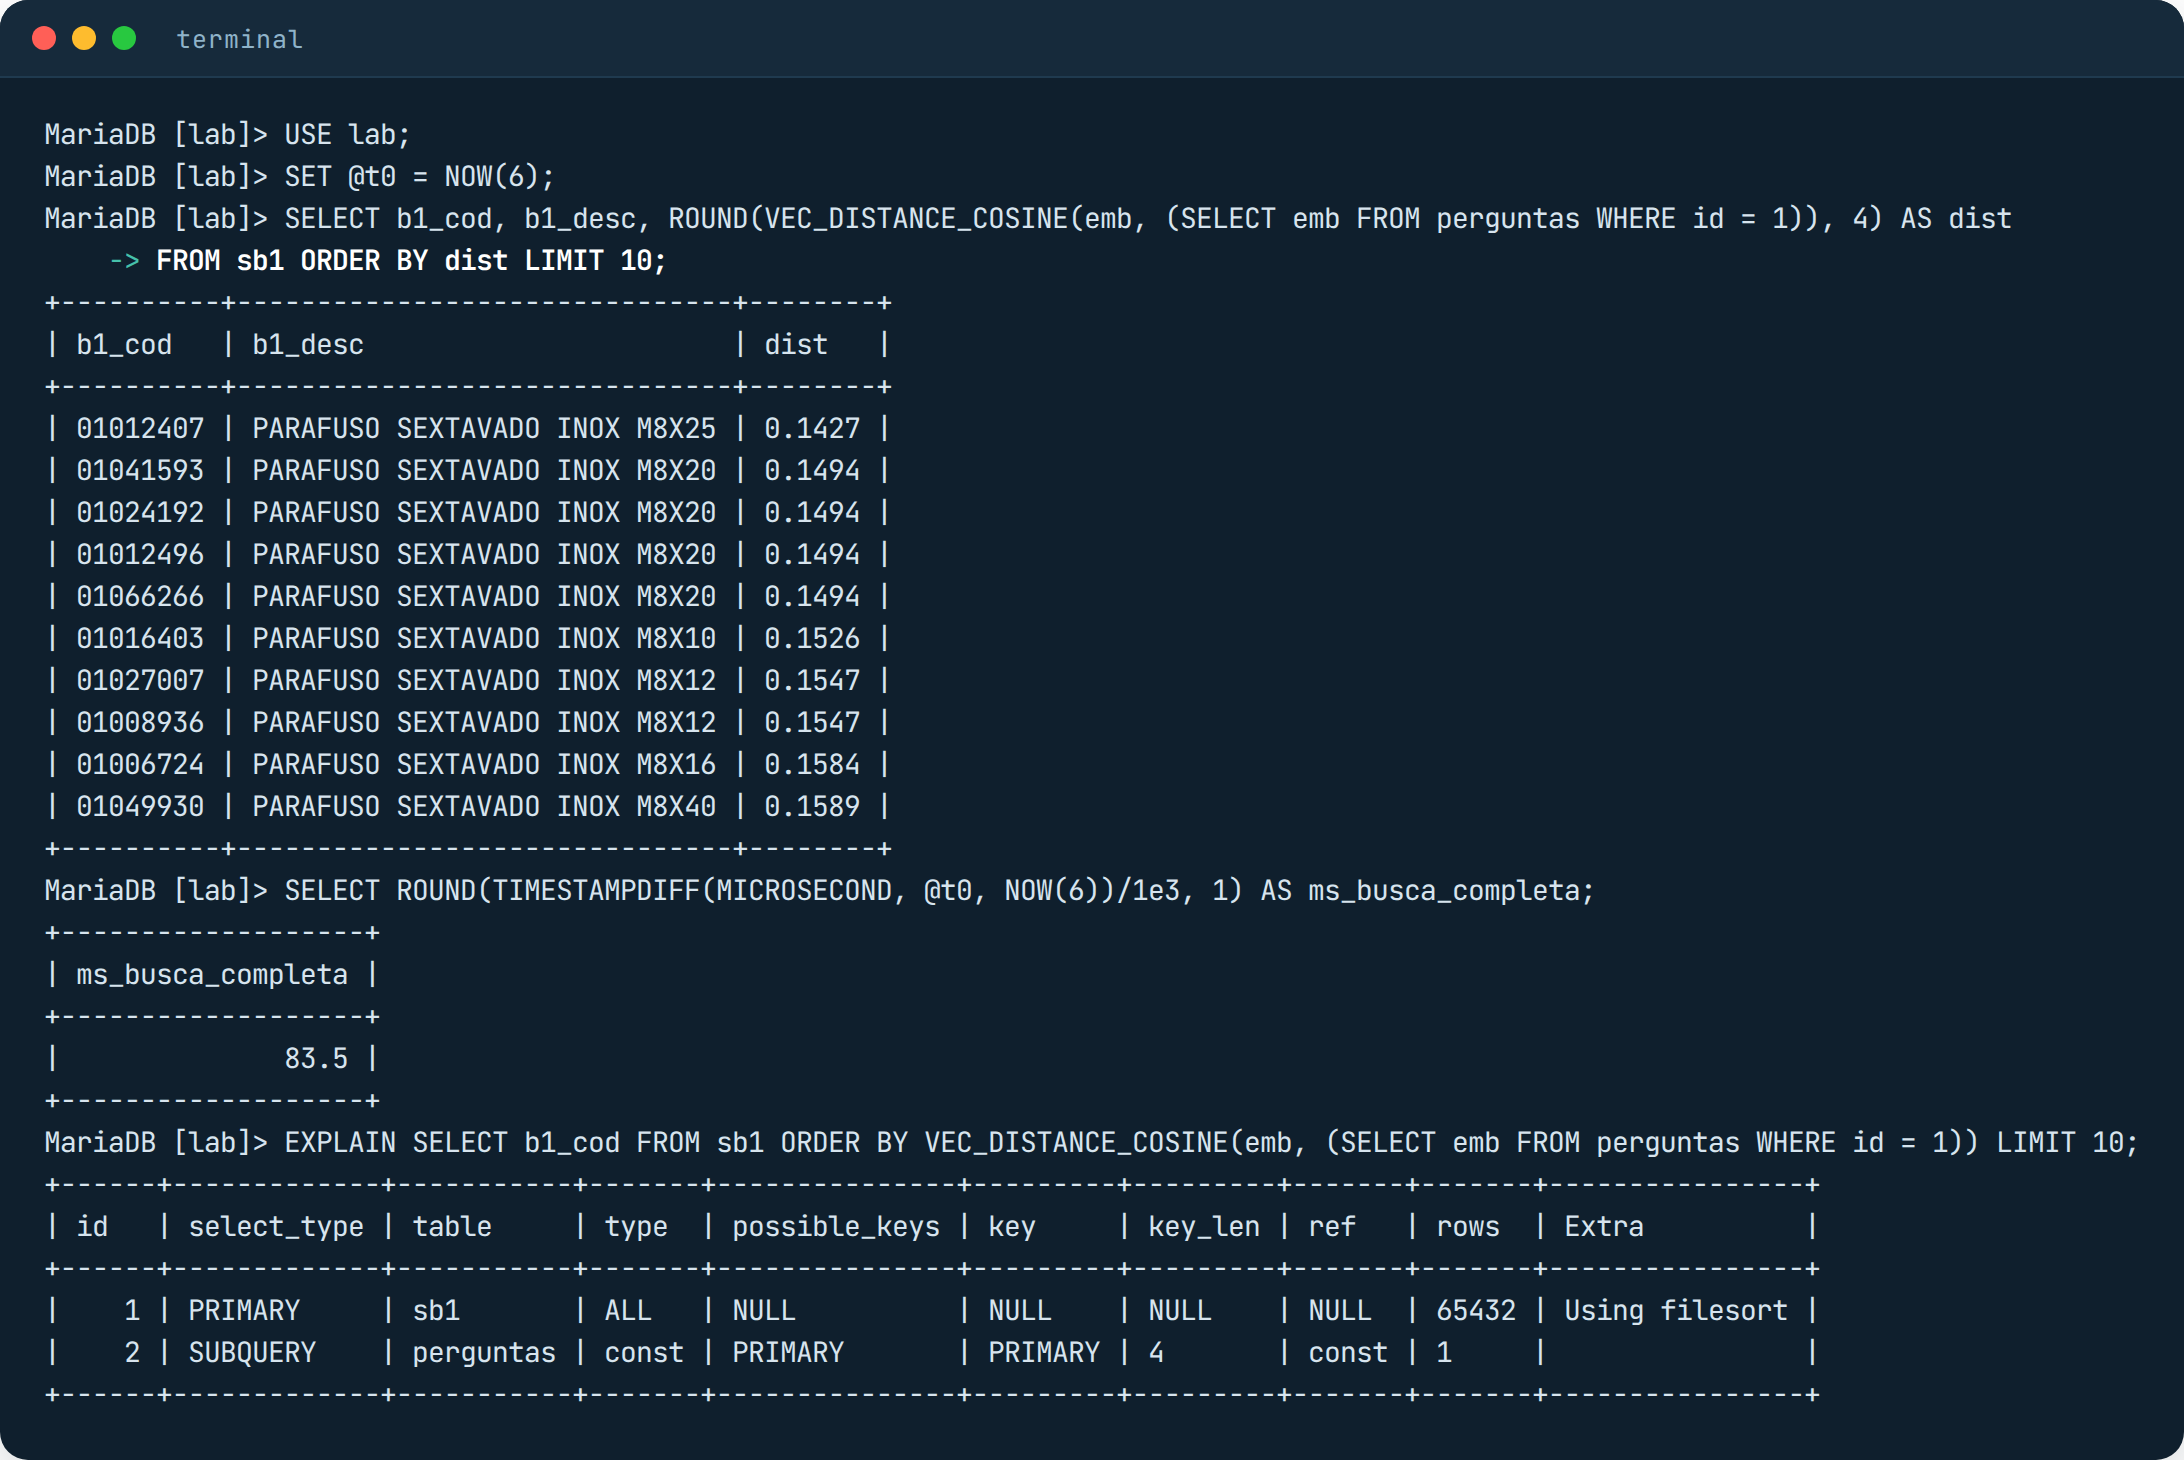
Antes do índice, uma pegadinha que custou caro no meu script de medição. Se a conversão do texto em vetor, o VEC_FromText, ficar dentro do ORDER BY, o MariaDB refaz essa conversão pra cada uma das 72.965 linhas, e a mesma consulta vai de 89 ms pra 2,9 segundos. A saída é converter uma vez, numa variável, e usar a variável na consulta. É assim que a aplicação deve mandar o vetor da pergunta.
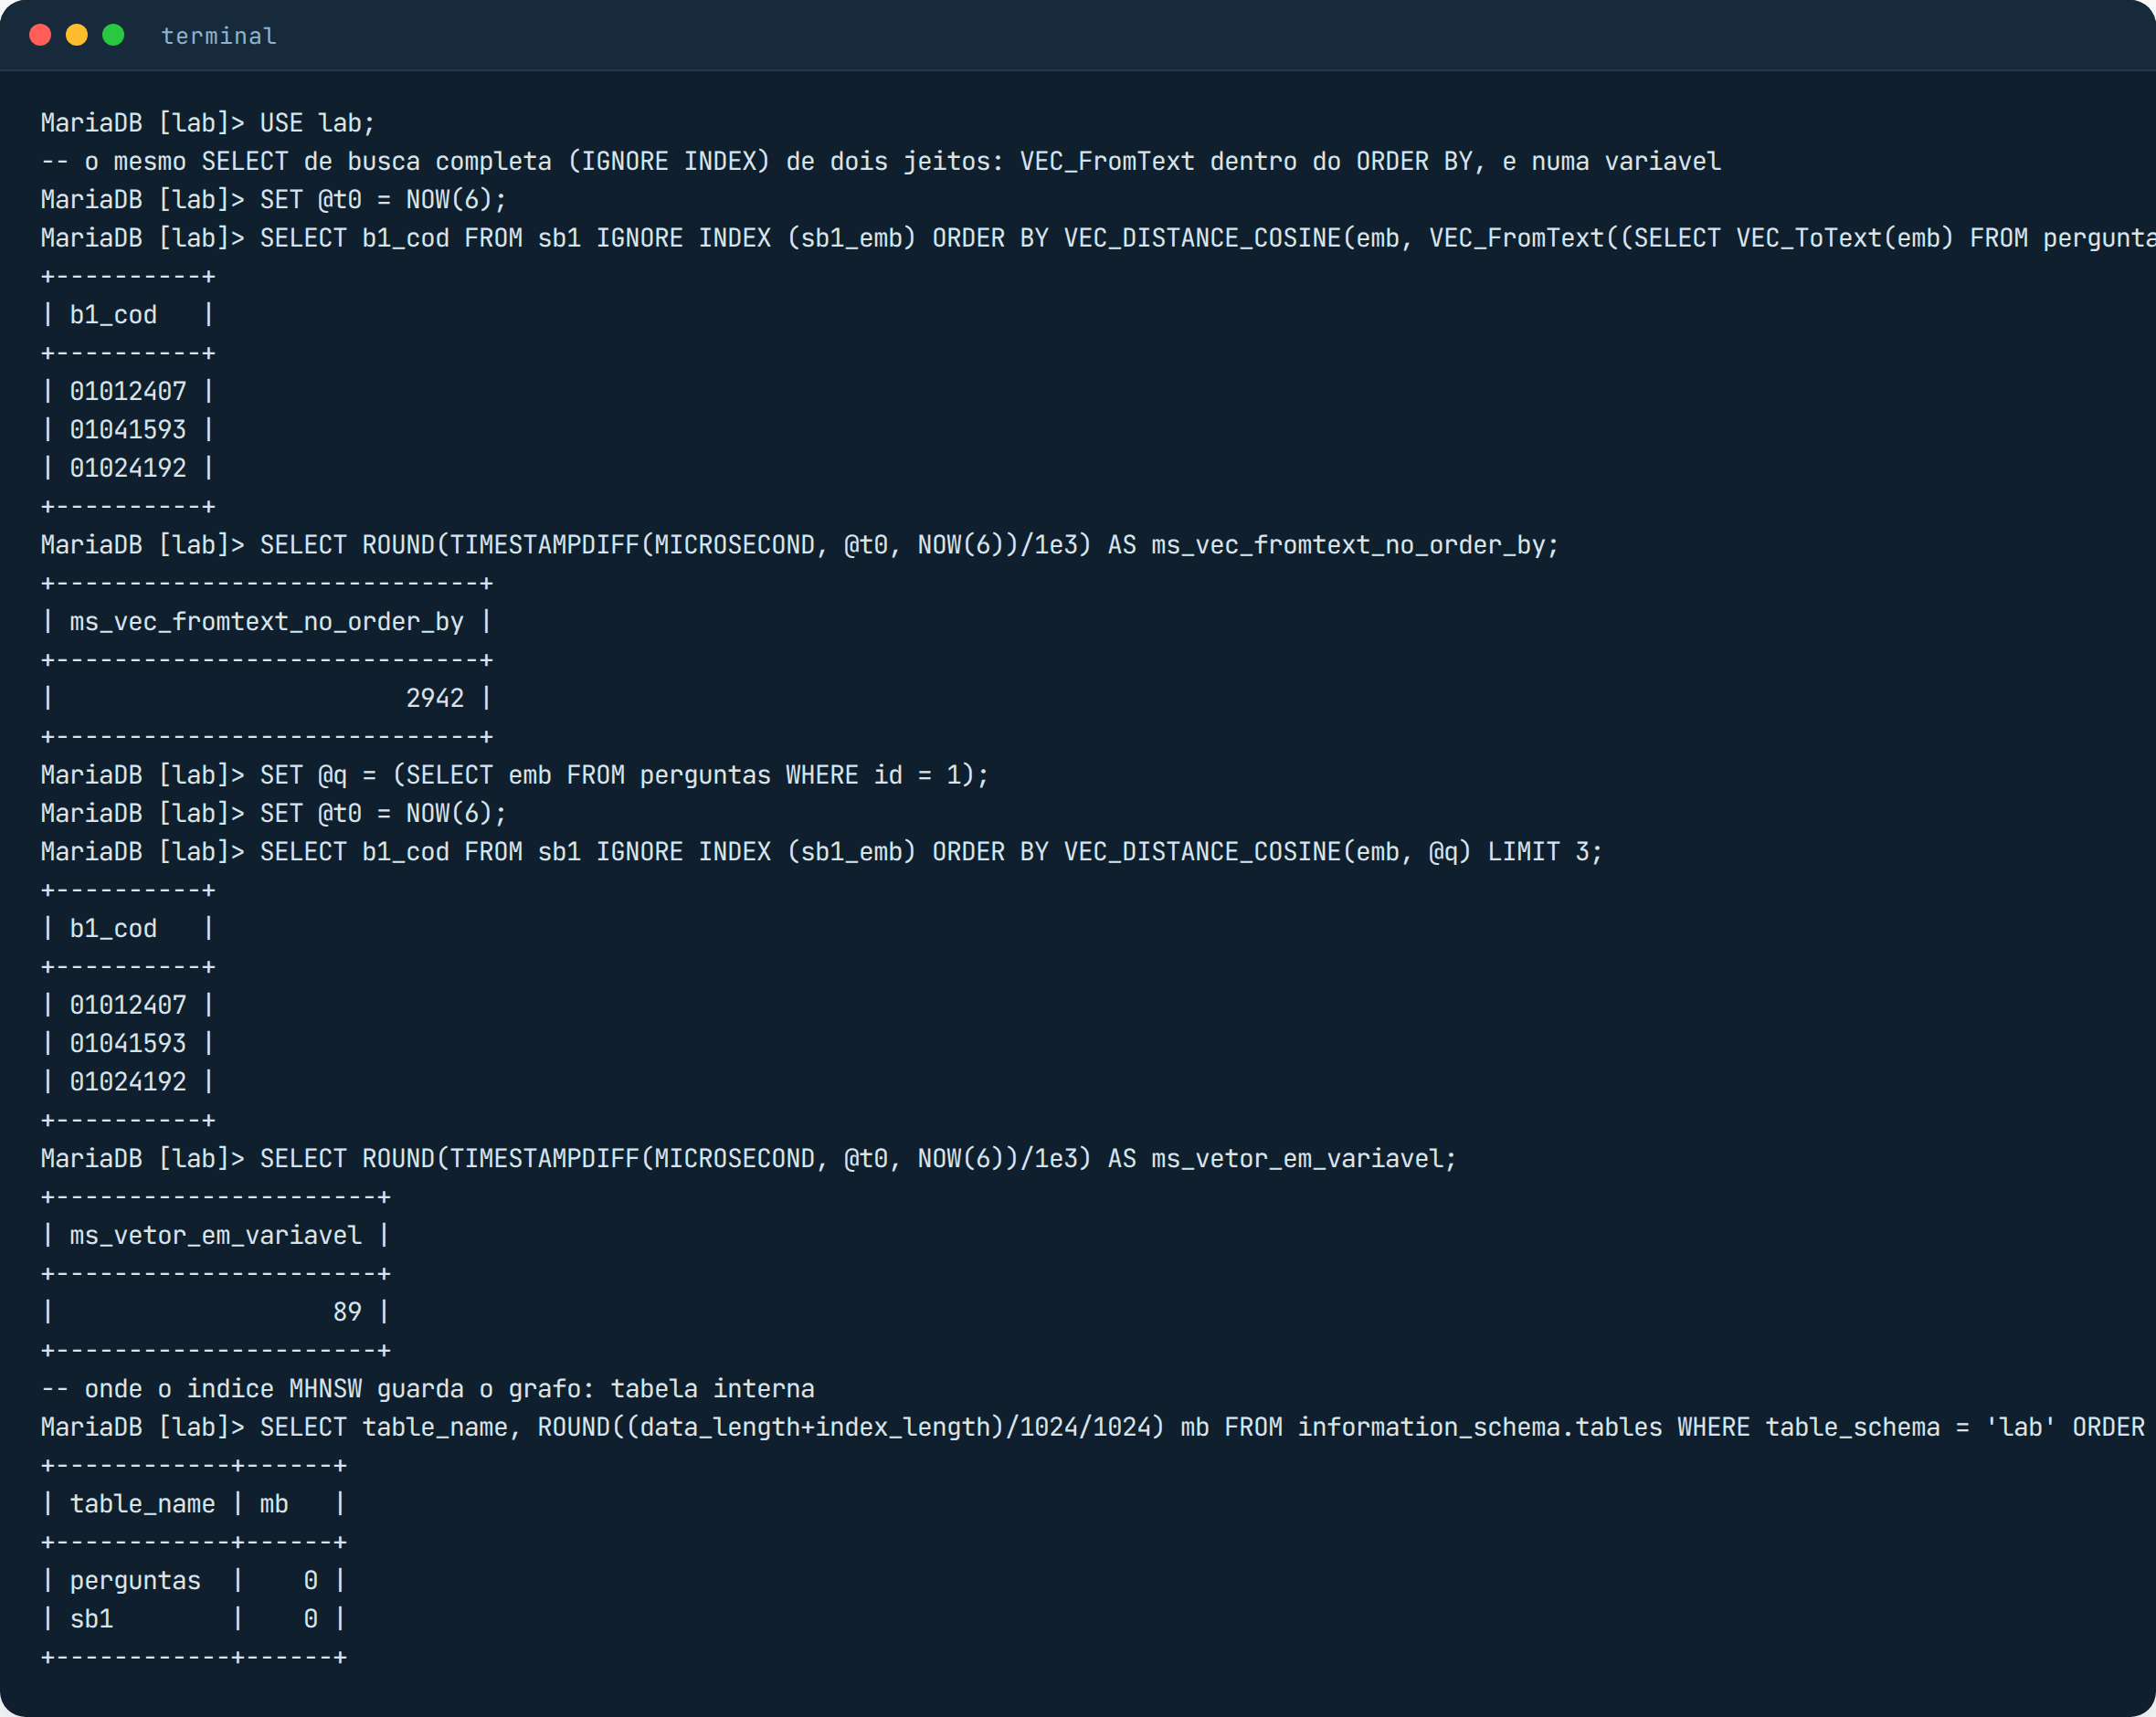
O índice entra com ALTER TABLE … ADD VECTOR INDEX, e dá pra escolher o M (quantos vizinhos cada ponto do mapa guarda) e a distância. Usei M=16 e cosseno, igual aos outros. Demorou 2 minutos e 6 segundos pra montar, mais que o pgvector (10 segundos) e perto da Oracle (1 minuto e 47). Depois disso o EXPLAIN mostra o índice sb1_emb sendo usado e a consulta caiu de 83 ms pra 4,5 ms no cliente e 0,76 ms por pergunta na medição, com recall de 99% no padrão (mhnsw_ef_search = 20). Foi a melhor precisão com configuração de fábrica entre os bancos do lab.
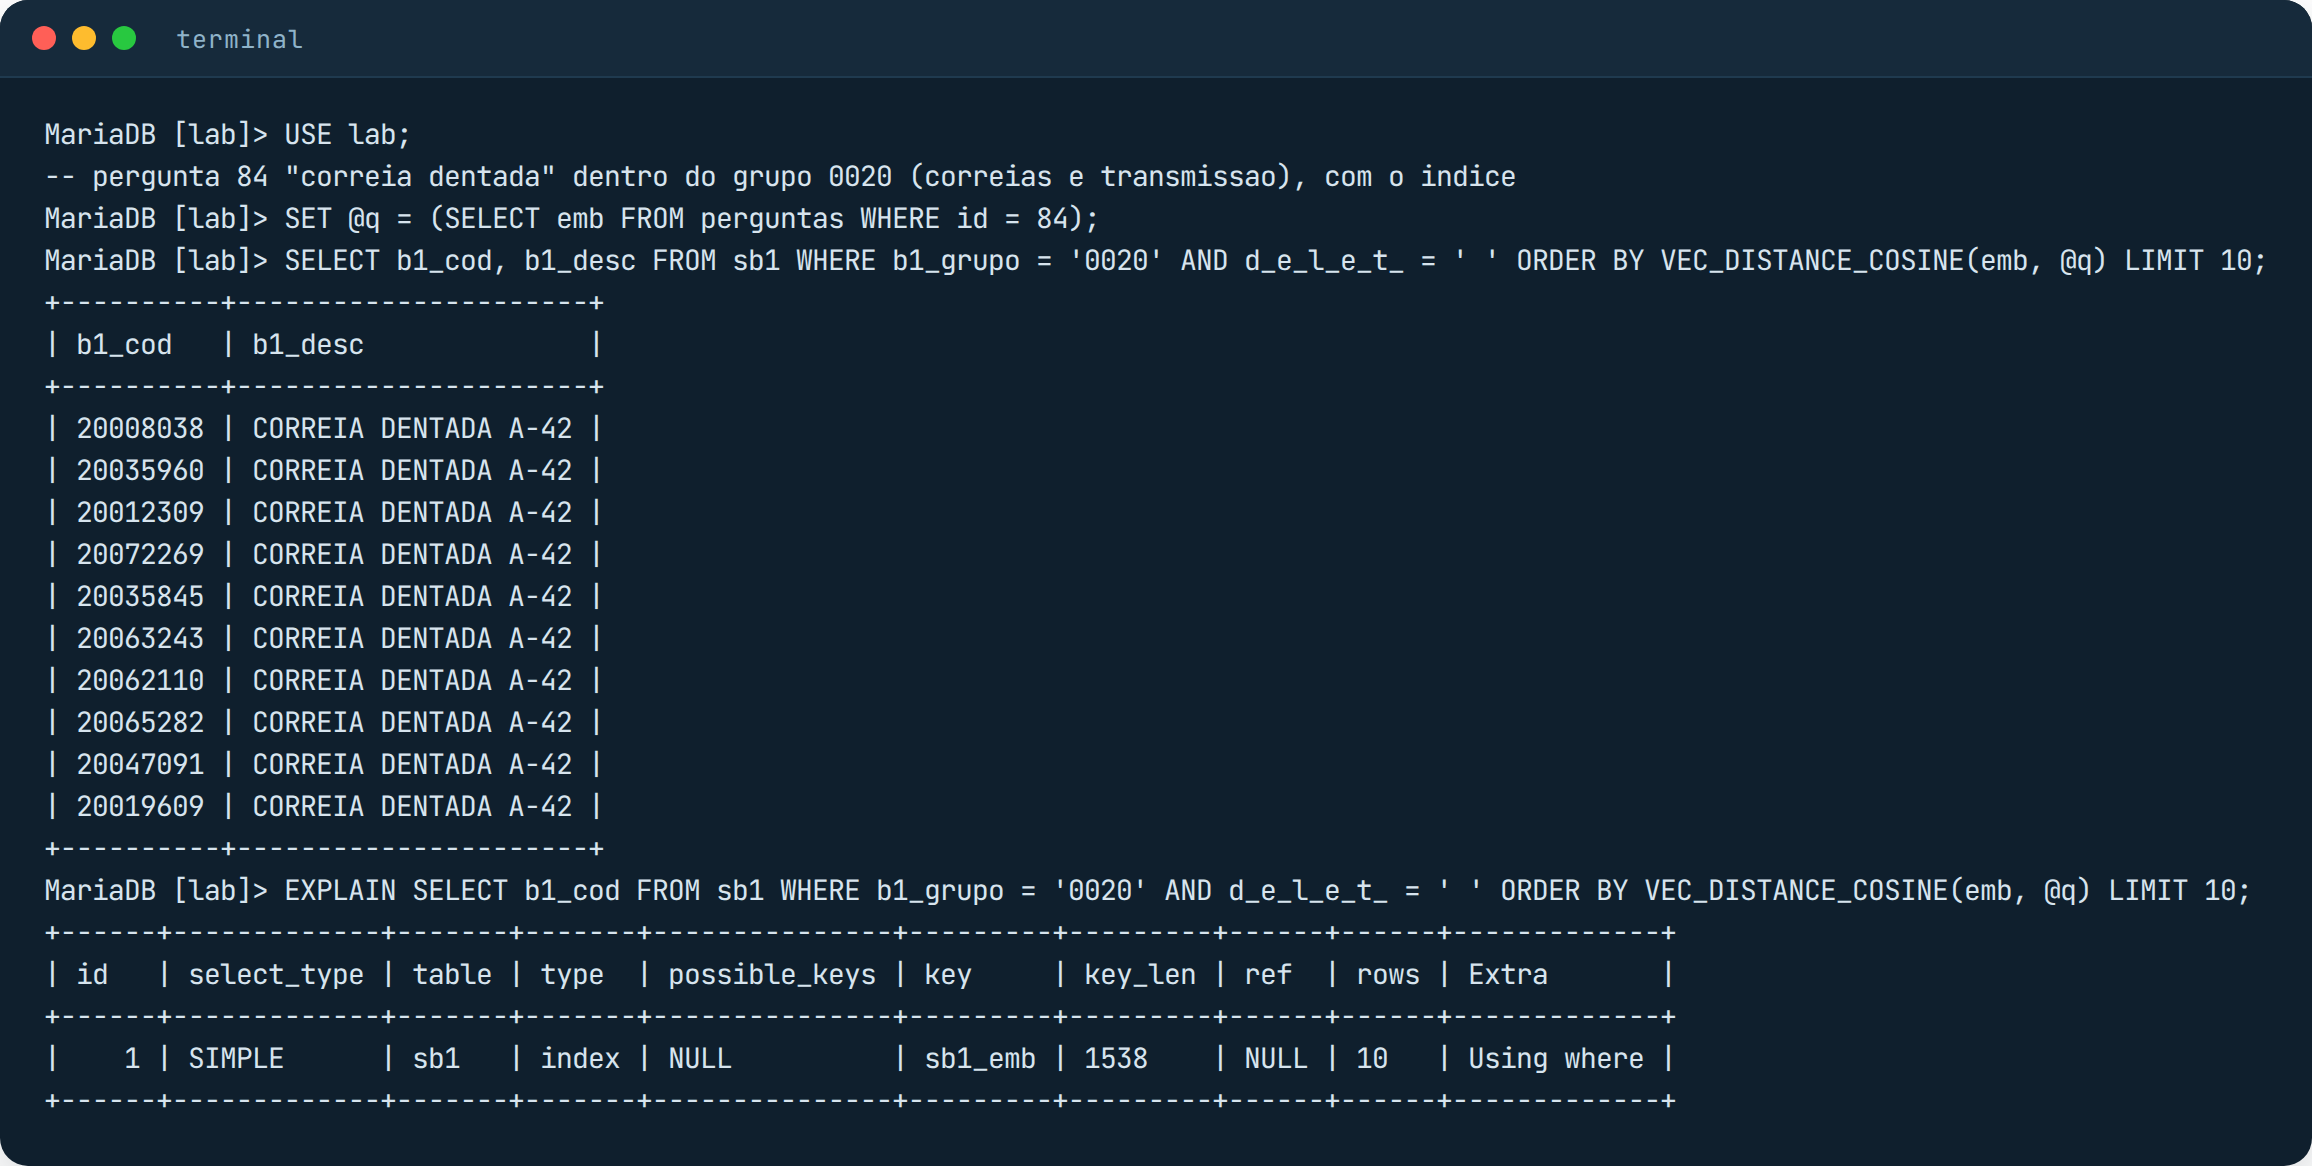
E o filtro, a mesma “correia dentada” no grupo 0020? Na tela, voltou certo: 10 correias dentadas, com o EXPLAIN mostrando o índice mais Using where. Mas essa pergunta teve sorte. Nas 100 perguntas com o filtro, o MariaDB devolveu em média 3,3 linhas das 10, com mínimo zero e recall de 25,8%, e o tempo variou de 26 ms na mediana até 1,8 segundos nas piores. Ele faz como o pgvector sem iterative scan: anda no mapa, separa candidatos e aplica o WHERE depois; quando os candidatos não passam, ele tenta mais um pouco e desiste. Subir o mhnsw_ef_search pra 200 não ajudou (1,9 linhas em média). Pra consulta com filtro de ERP, hoje, é o ponto fraco dele.
SQL Server 2025 e o tipo VECTOR: aqui não fiz lab
No SQL Server 2025 eu não rodei o lab por uma questão de licença, então nada do que segue foi medido por mim. É o que a documentação da Microsoft dizia em 9 de novembro de 2026, e vale conferir na sua versão antes de contar com qualquer coisa.
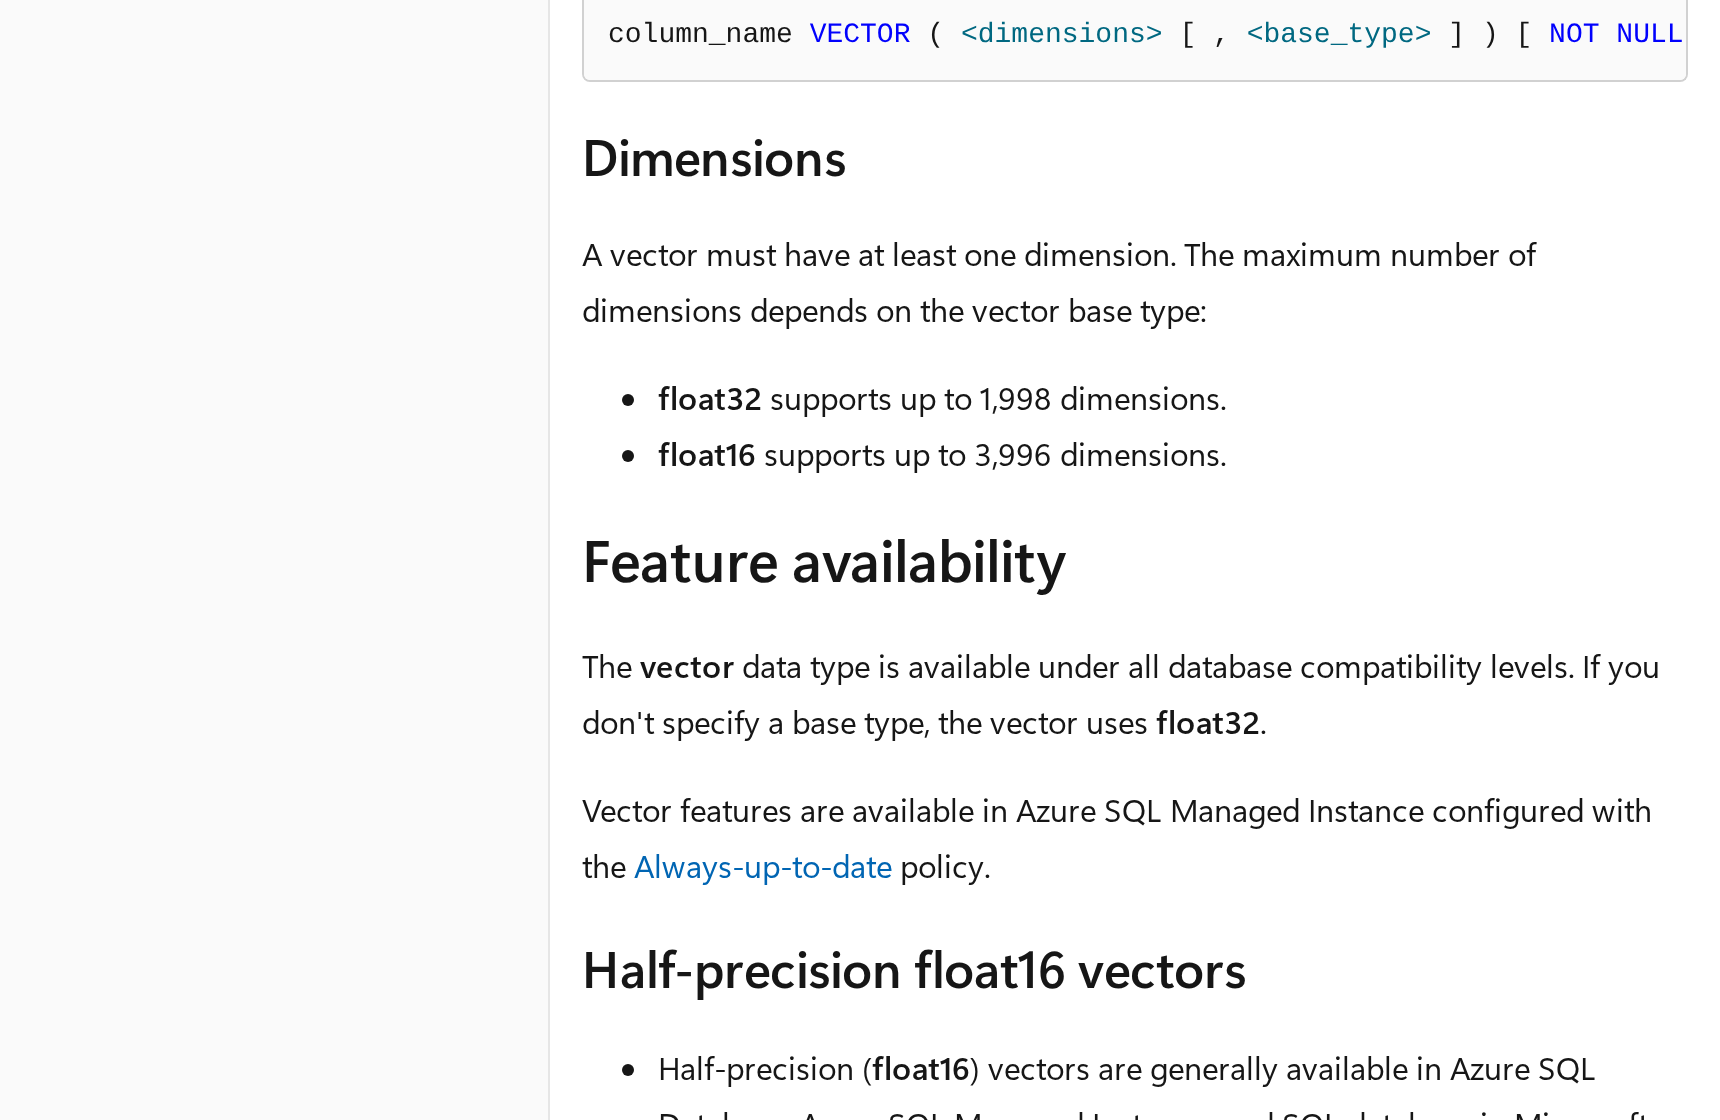
O tipo VECTOR está pronto pra produção (GA, que é “disponível pra todo mundo”): guarda até 1.998 números por vetor no formato normal (float32) e até 3.996 no formato compacto (float16), sendo que o float16 ainda é preview no SQL Server 2025 instalado na sua máquina. Preview quer dizer “em teste, pode mudar, a Microsoft não recomenda pra produção”. A busca completa, com VECTOR_DISTANCE e ORDER BY, funciona sem ligar nada, igual à que eu fiz nos outros bancos sem índice. Já o índice (CREATE VECTOR INDEX, do tipo DiskANN) e a função de busca com índice (VECTOR_SEARCH) são preview no SQL Server 2025: pra usar, precisa ligar com ALTER DATABASE SCOPED CONFIGURATION SET PREVIEW_FEATURES = ON. No Azure SQL Database, que é a versão em nuvem, os dois já são GA.
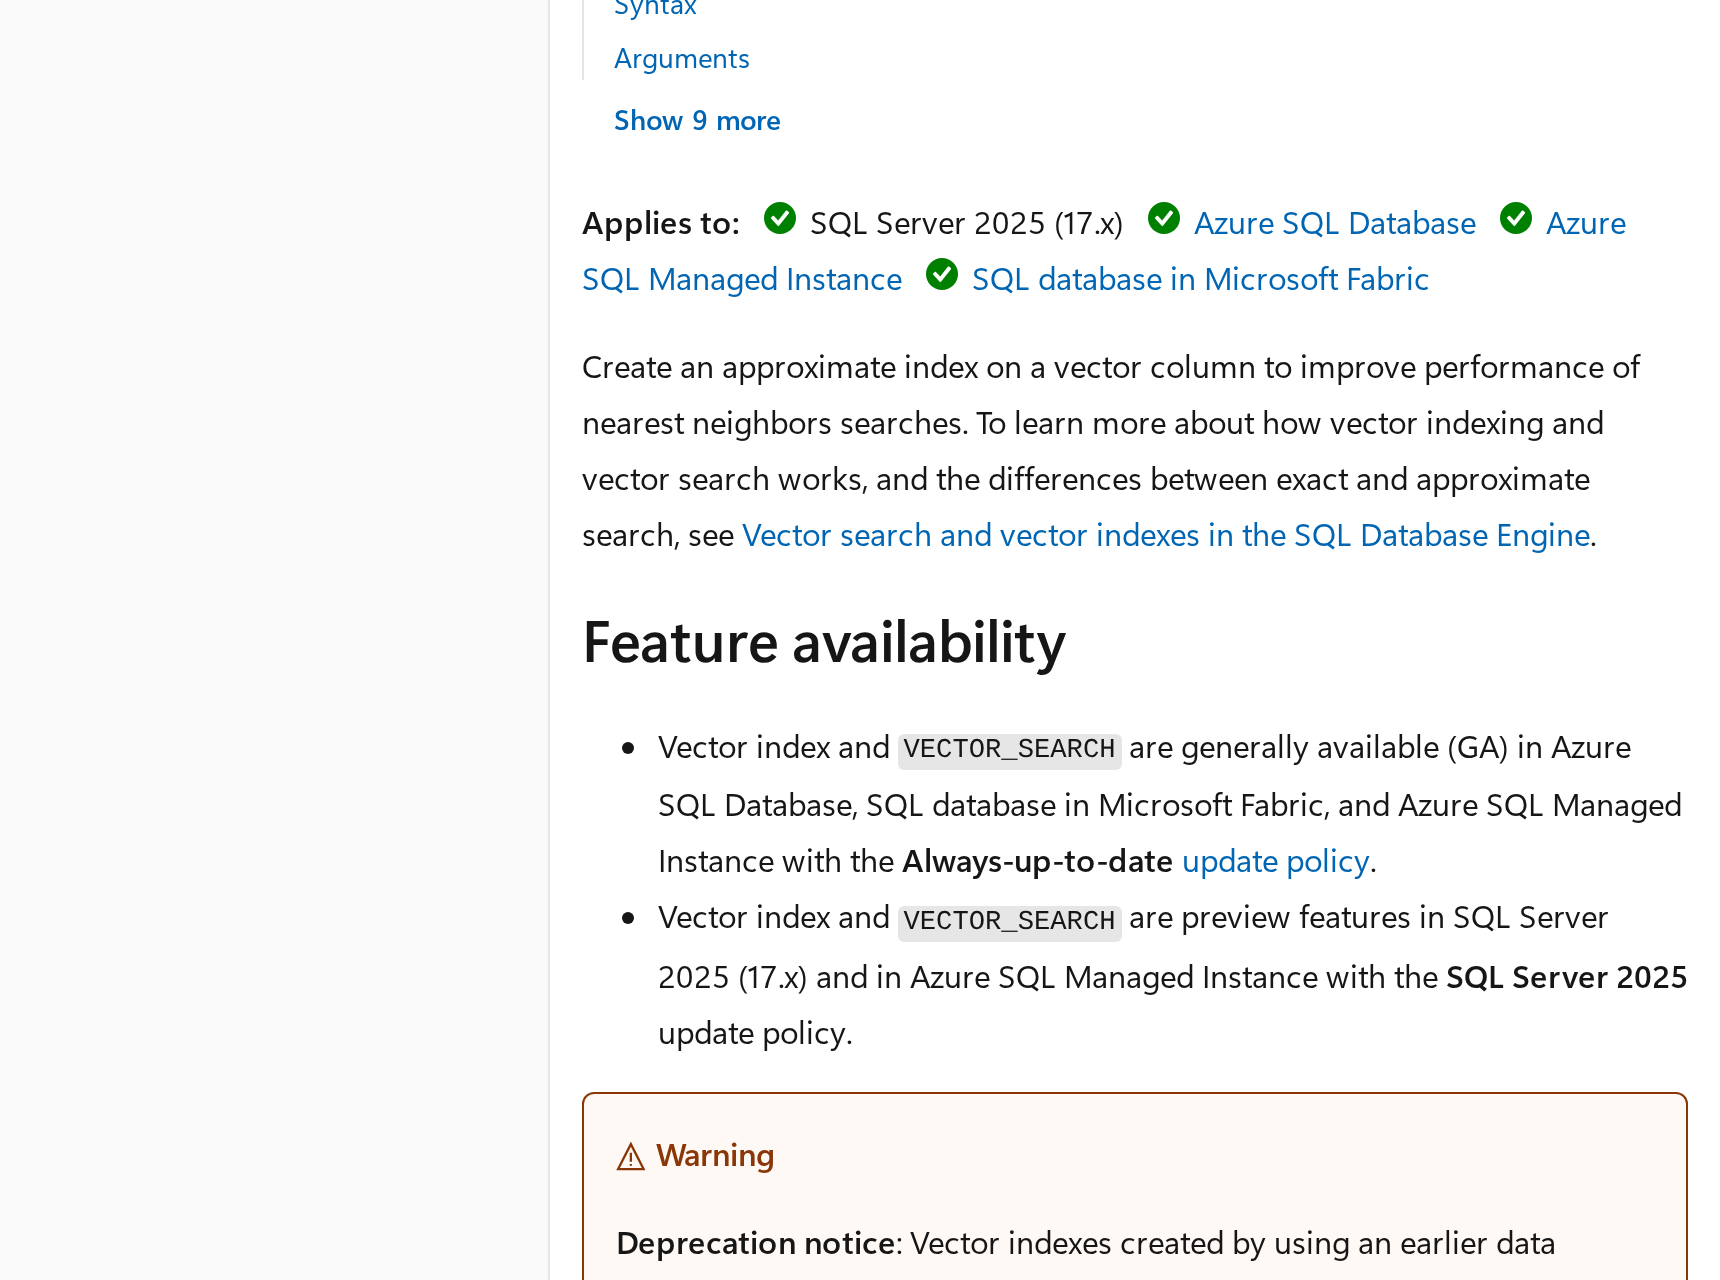
Tem mais um detalhe que a documentação deixa no meio do texto. Existe uma versão nova do índice, que aceita INSERT, UPDATE e DELETE na tabela e aplica o filtro do WHERE durante a busca; essa versão está na nuvem. A versão anterior deixa a tabela somente leitura depois que o índice é criado, e a documentação avisa que o filtro pode devolver menos linhas que o esperado, o mesmo comportamento que eu vi no pgvector. Antes de contar com índice vetorial em SQL Server instalado, olhe qual versão de índice você tem em sys.vector_indexes.
Comparando os cinco: qual banco de dados vetorial faz melhor
Todos os números que apareceram acima saíram do script de medição, do jeito que ele imprimiu. É número de lab, serve pra comparar os bancos entre si na mesma máquina, não pra prometer pra ninguém.
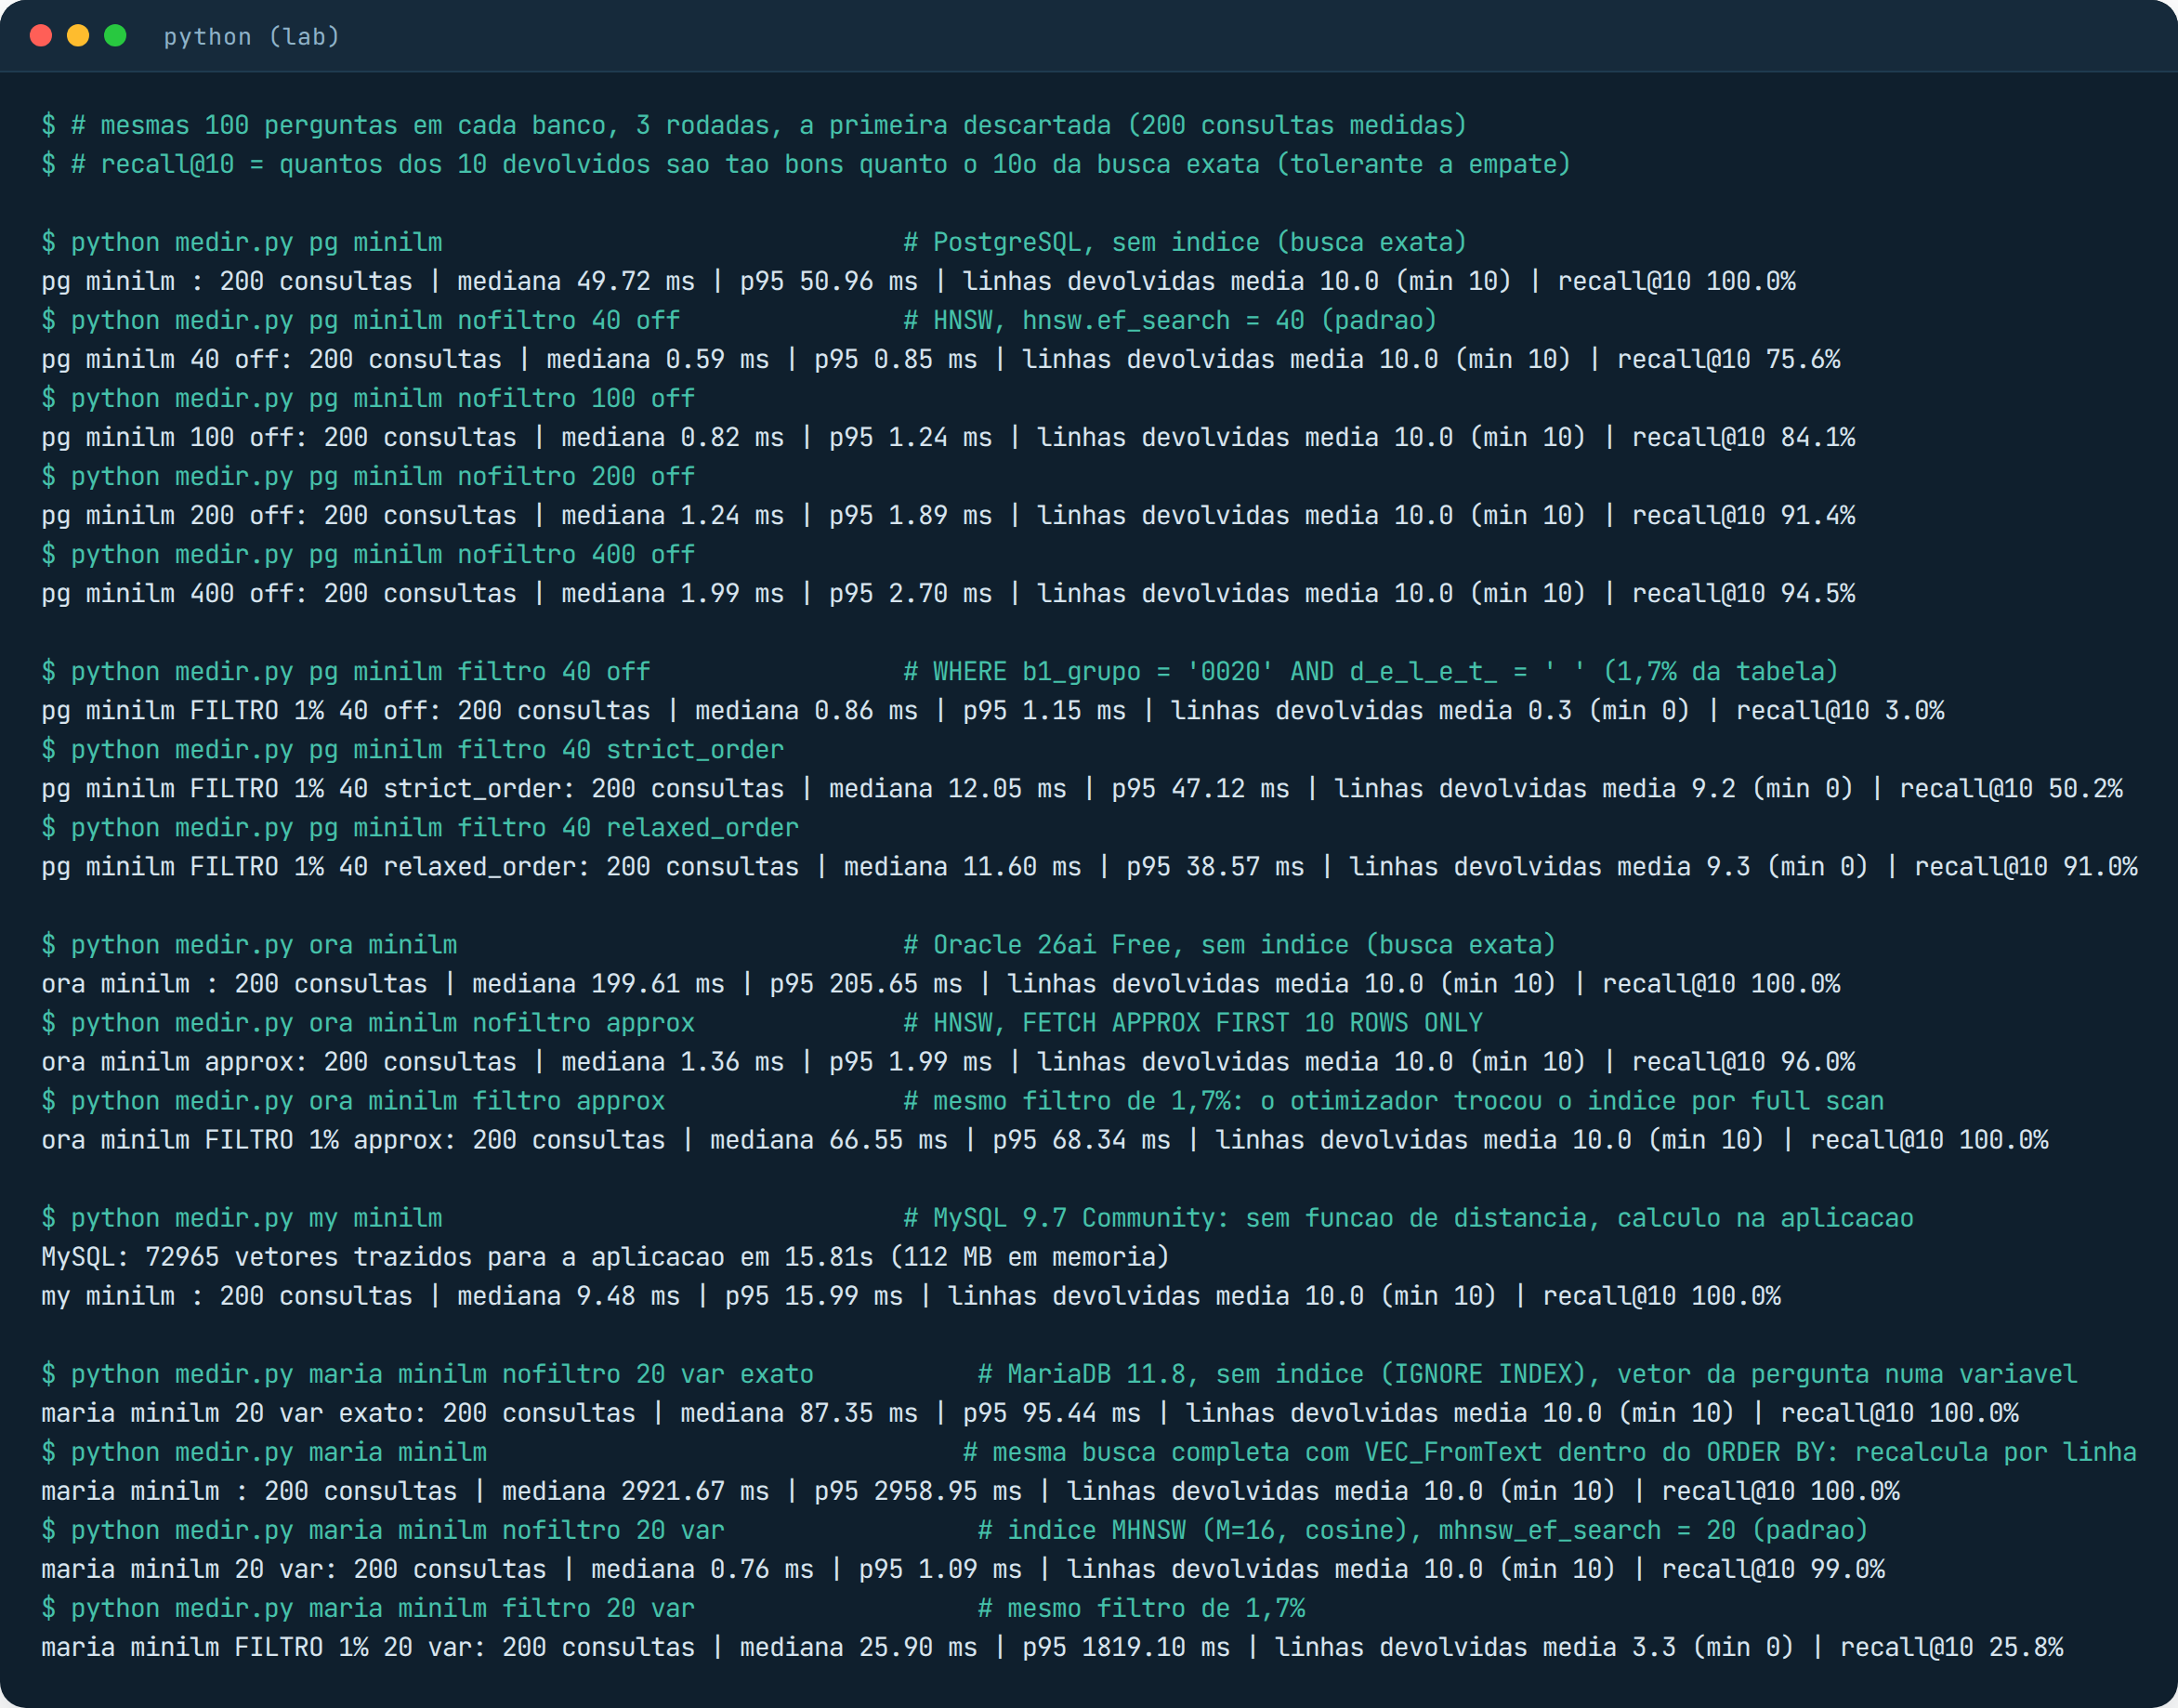
Lendo os números. Na busca completa, sem índice, o PostgreSQL foi quatro vezes mais rápido que a Oracle (49 ms contra 200 ms), e os dois acertam tudo, porque olham a tabela inteira. Com índice, os dois respondem em 1 ou 2 ms; o pgvector monta o índice em 10 segundos e acerta 75% no padrão, a Oracle leva quase 2 minutos pra montar e acerta 96%. Com filtro no WHERE, que é a vida real de ERP, o pgvector devolve vazio até você ligar o iterative scan, e a Oracle devolve certo mas desiste do índice e lê o grupo inteiro. O MariaDB 11.8 surpreendeu na precisão: 99% com a configuração de fábrica, em 0,8 ms, com índice montado em 2 minutos; mas com filtro no WHERE devolve em média 3 linhas das 10 e não tem o ajuste que o pgvector tem. O MySQL Community guarda o vetor, mas não compara nem indexa; a conta tem que ser feita fora, e pra 70 mil produtos ainda cabe. O SQL Server 2025 tem o tipo pronto e o índice em preview na versão instalada; a busca completa funciona hoje.
Pra fechar, um ranking dos cinco. O critério é o que cada banco entrega hoje pra busca vetorial, na versão que você instala no seu servidor, com os números deste lab e sem olhar preço. Se o preço entrar na conta, o PostgreSQL passa pra primeiro, e o MariaDB fica colado nele.
| Pos. | Banco | Busca com índice | Montar índice | Filtro no WHERE | Situação hoje |
|---|---|---|---|---|---|
| 1º | Oracle 26aiAI Vector Search | 1,36 ms, recall 96%busca completa: 200 ms | 1 min 47 s131 MB de RAM reservada (vector pool) | devolve certomas larga o índice e lê o grupo inteiro, 66 ms | pronto pra produçãomodelo dentro do banco e índice híbrido; precisa configurar o vector_memory_size |
| 2º | PostgreSQL 18pgvector 0.8.7 | 0,59 ms, recall 75,6%94,5% com ef_search 400; busca completa: 49 ms | 10 s36 MB em disco | devolve vazio no padrãoliga o iterative scan e vai a 91% | pronto pra produçãogratuito; vetor gerado fora, na aplicação; ajustar ef_search e iterative_scan |
| 3º | MariaDB 11.8MHNSW, versão gratuita | 0,76 ms, recall 99%busca completa: 87 ms | 2 min 06 síndice dentro do InnoDB | devolve 3 linhas das 10recall 26%, p95 de 1,8 s; sem ajuste equivalente ao iterative scan | pronto pra produçãogratuito; vetor gerado fora; cuidado com VEC_FromText dentro do ORDER BY |
| 4º | SQL Server 2025sem lab, só documentação | índice em previewVECTOR_SEARCH pede PREVIEW_FEATURES | previewversão antiga do índice deixa a tabela só leitura | pode devolver menos linhasfiltro iterativo só na versão da nuvem | tipo VECTOR pronto, índice nãobusca completa com VECTOR_DISTANCE funciona; vetor gerado fora |
| 5º | MySQL 9.7Community | não temDISTANCE() só no HeatWave e no MySQL AI | não temnão existe índice vetorial no Community | só na aplicação73 mil vetores em 15,8 s, depois 9,5 ms por pergunta | só guarda o vetora saída é o MariaDB, logo acima |
Pra um cadastro de dezenas ou centenas de milhares de itens, o banco que você já tem faz busca por sentido. PostgreSQL com pgvector é o mais barato e o mais maduro, desde que o iterative scan seja ligado antes do primeiro WHERE. Oracle 26ai é o mais completo, com o modelo dentro do banco e o índice híbrido, mas cobra em memória reservada e em tempo pra montar o índice. MariaDB é a saída natural pra quem está em MySQL e quer índice vetorial sem trocar de família, desde que a consulta com filtro seja testada antes. Um banco vetorial separado, pra esse tamanho de problema, é mais um sistema pra cuidar sem necessidade.
Quando chamar um especialista
Colocar busca vetorial no banco de produção mexe em memória (o vector pool da Oracle, a memória compartilhada e o maintenance_work_mem do PostgreSQL), em tempo pra montar índice e no jeito que a consulta com filtro se comporta, que é o caso de quase toda tela de ERP. Se você quer saber como o seu ambiente aguenta isso antes de ligar, a sustentação de banco de dados da Furushima faz esse levantamento. Pode pedir um health check ou falar com a gente pelo contato.
Imagem de capa: robôs humanoides em luta de boxe, reprodução de captura de tela publicada por O Globo em 26/05/2025.
Referências
- pgvector: README (Iterative Index Scans, Filtering) e CHANGELOG (0.8.7 em 01/10/2026)
- Oracle AI Vector Search User’s Guide: Size the Vector Pool
- Oracle: SQL Quick Start Using a Vector Embedding Model Uploaded into the Database
- Oracle: Understand Hybrid Vector Indexes
- Microsoft Learn: CREATE VECTOR INDEX (Transact-SQL)
- Microsoft Learn: Vector data type
- Microsoft Learn: VECTOR_SEARCH (Transact-SQL)
- MySQL 9.7 Reference Manual: Vector Functions
- sentence-transformers/all-MiniLM-L12-v2 e intfloat/multilingual-e5-small
- Oracle: pre-built ONNX model for embedding generation